API 성능 테스트, 현실적인 시나리오를 설계하는 방법
성능 테스트는 요청을 많이 보내는 게 목적이 아니다. 실제 사용자 흐름을 재현하고, 필요한 부하를 근거 있게 정하고, 환경과 지표를 제대로 맞춰야 결과가 쓸모 있어진다는 정리.


API Performance Testing: How to Design Realistic Tests
Most of us have heard the term performance testing, whether before releasing a big new feature,...
개요 #
성능 테스트를 돌렸는데도 배포 후에 터지는 경우가 있다. Daniel Balcarek은 그 원인을 테스트 자체의 설계에서 찾는다. 엔드포인트에 요청을 마구 쏘는 것만으로는 애플리케이션이 실제로 어떻게 동작할지 알 수 없고, 잘못 설계된 테스트는 오히려 엉뚱한 결론으로 이끈다는 것이다.
그래서 그는 실무 관점에서 네 가지를 짚는다. 사용자 흐름을 어떻게 재현할지, 감당해야 할 부하를 어떤 근거로 정할지, 외부 서비스를 어떻게 다룰지, 테스트 환경을 프로덕션에 얼마나 가깝게 맞출지다. 결론은 단순하다. 부하와 환경과 지표가 현실적일 때만 성능 테스트 결과에 의미가 생긴다.
성능 테스트의 여섯 가지 유형 #
성능 테스트는 애플리케이션의 속도, 안정성, 확장성, 응답성을 특정 워크로드 아래에서 평가하는 비기능 테스트다. API를 예로 들면, 실제 사용 패턴에 가까운 순서로 엔드포인트를 호출하면서 부하를 거는 방식이다. 성능이 부족한 상태로 배포하면 장애, 느린 응답, 정해진 시간 안에 작업을 끝내지 못하는 상황으로 이어지고, 결국 고객 이탈이나 매출 손실, 제품 신뢰도 하락까지 번진다.
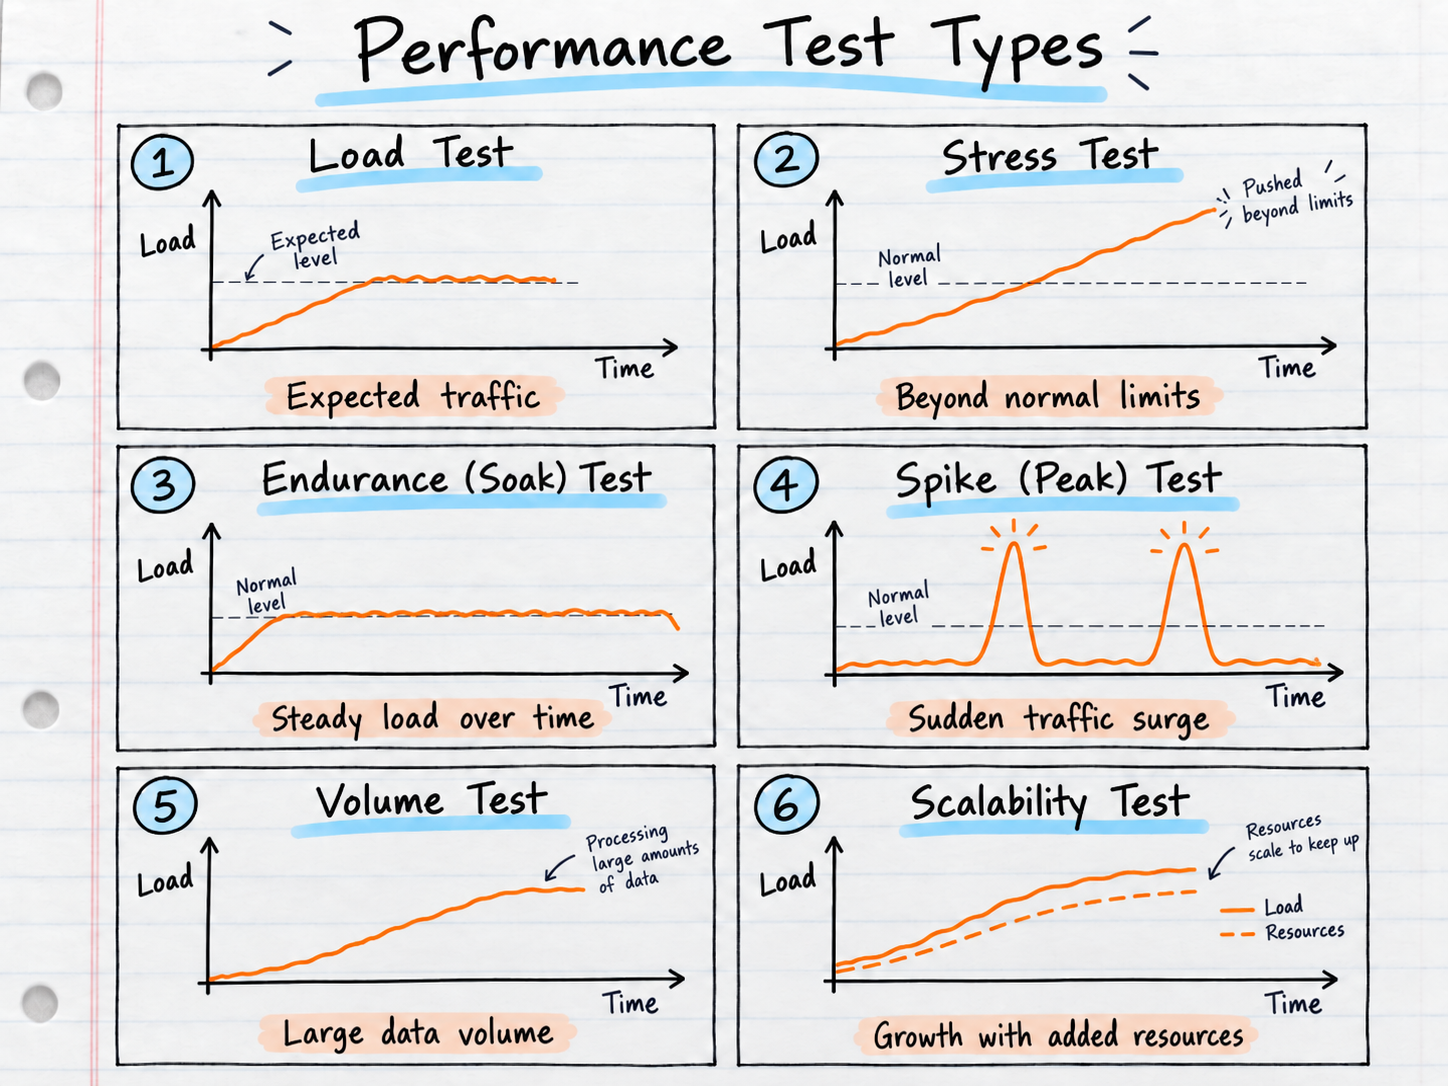
설정과 목적, 관찰할 지표에 따라 테스트는 여섯 가지로 나뉜다.
Load test(부하 테스트) 는 예상되는 정상 수준의 트래픽에서 애플리케이션이 어떻게 동작하는지 확인한다. 목표 사용자 수나 요청 수를 처리하면서 응답 시간, 에러율, 리소스 사용량이 허용 범위에 머무는지 검증한다.
Stress test(스트레스 테스트) 는 예상 한계를 넘겨 부하를 밀어붙여 어디서부터 성능이 꺾이고 실패하는지 찾는다. 시스템의 최대 수용량을 파악하고, CPU·메모리·DB 커넥션·스레드 같은 리소스가 고갈될 때의 거동을 관찰한다.
Endurance(Soak) test(내구성 테스트) 는 긴 시간 동안 부하를 지속적으로 유지한다. 짧은 테스트에서는 드러나지 않는 메모리 누수, 커넥션 누수, 리소스 고갈, 시간이 지나며 서서히 나빠지는 성능 저하를 잡아내는 게 목적이다.
Spike(Peak) test(급증 테스트) 는 트래픽이 갑자기 크게 치솟는 상황을 재현한다. 급격한 변화에 애플리케이션이 어떻게 반응하는지, 트래픽이 정상으로 돌아왔을 때 회복하는지를 본다.
Volume test(용량 테스트) 는 데이터 양이 많을 때의 거동에 집중한다. 평소보다 훨씬 큰 데이터를 다룰 때 DB 쿼리, 임포트, 익스포트, 배치 작업이 어떻게 반응하는지 같은 것들이다.
Scalability test(확장성 테스트) 는 워크로드를 늘리고 리소스를 추가했을 때 성능이 어떻게 변하는지 검증한다. 인스턴스나 CPU, 메모리, DB 용량을 늘리는 방식으로 시스템이 효율적으로 확장되는지 판단하는 게 목표다.
유형마다 완전히 다른 테스트를 만들 필요는 없다. 같은 시나리오를 재사용하면서 동시 사용자 수, 지속 시간, 요청 비율, 워크로드 패턴 같은 설정만 바꾸고, 목적에 따라 다른 지표를 보면 된다. 모든 애플리케이션이 여섯 가지를 다 필요로 하지도 않는다. 어떤 서비스는 부하와 스트레스 테스트가 중심이고, 어떤 서비스는 부하와 급증 테스트가 더 유용하다. 요구사항과 사용자가 실제로 어떻게 쓰는지에 달려 있다.
사용자 경로를 그대로 재현하기 #
Balcarek이 오랫동안 효과를 본 방식은 전형적인 사용자 행동을 찾아내 그대로 시뮬레이션하는 것이다. 주문 기능이 있는 이커머스 애플리케이션을 떠올려보자. 전형적인 사용자는 상품을 몇 개 검색하고, 장바구니에 담고, 체크아웃을 거쳐 결제를 마친다.
이때 엔드포인트를 하나씩 따로 테스트하는 대신, 이 흐름 전체를 재현하고 프런트엔드가 평소에 호출하는 것과 동일한 엔드포인트를 호출하도록 테스트를 설계한다.
사용자 유형이 여러 개인 업무용 애플리케이션이라면 유형별로 권한과 사용 방식이 다르다. 각 유형의 전형적인 워크플로를 설계해 프런트엔드와 같은 순서로 API를 호출하면 된다. 이렇게 하면 현실적인 사용자 행동을 유지한 채로 동시 사용자 수만 올리는 식으로 설정을 바꿔갈 수 있다. API 간 통신도 마찬가지다. POST 뒤에 GET이 따라오는 구조라면 입력 파라미터와 요청 패턴을 다양하게 바꿔가며 특정 부하에서의 거동을 관찰한다.
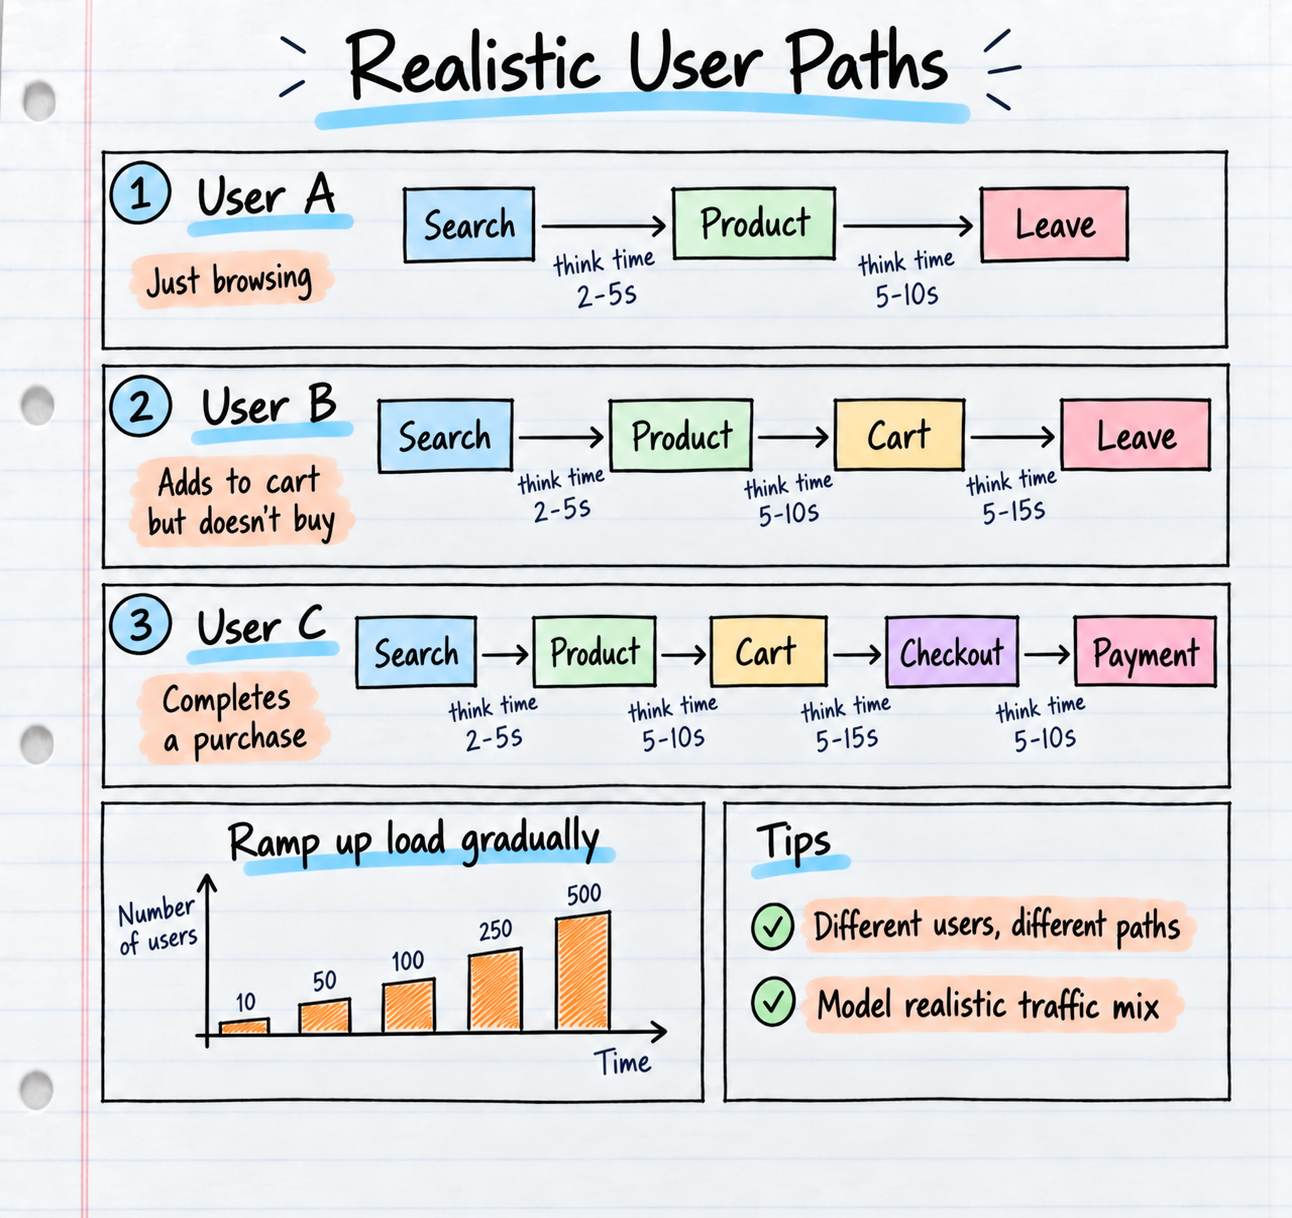
경로를 정했다고 끝은 아니다. 테스트 흐름을 만들 때 챙길 게 몇 가지 더 있다.
- 실제 사용자는 성능 테스트 도구만큼 빠르게 클릭하지 않는다. 동작 사이에 현실적인 think time을 넣어야 한다.
- 모두가 같은 경로를 따르지도 않는다. 이커머스라면 주문을 끝내는 사람도 있고, 상품만 둘러보거나 장바구니에 담아두고 나중에 돌아오는 사람도 있다. 행동이 다른 여러 경로를 함께 시뮬레이션해야 한다.
- 사용자가 전부 같은 순간에 접속하는 것도 아니다. 일반적인 부하 테스트라면 부하를 점진적으로 올려야 한다.
감당해야 할 부하는 어떻게 정하나 #
현실적인 워크로드를 만드는 건 절반이다. 테스트를 돌리기 전에 "성공"이 무엇인지도 정의해야 한다. 모든 애플리케이션이 초당 1,000 요청을 받아낼 필요는 없다. 시스템마다 기대 워크로드와 성능 요구사항이 다르다.
Expected load: 150 RPS

p95 < 400 ms
p99 < 1 s
Error rate < 0.5%
Required throughput maintained
No continuously growing queues/connections
그럼 이 숫자는 어디서 나오나. 관측 체계가 갖춰져 있다면 프로덕션의 과거 지표가 좋은 출발점이다. Grafana 같은 도구에서 최대 요청 비율, 동시 사용자 수, 주문량, CPU와 메모리 사용량을 확인하고 미래 부하를 추정한다. 이커머스라면 크리스마스나 블랙프라이데이처럼 평소보다 트래픽이 크게 뛰는 시기가 있다. 내년에 10% 성장을 예상한다면, 그 위에 안전 마진을 더해 테스트 목표를 잡는 식이다.
비즈니스 요구사항에서 거꾸로 계산하는 방법도 있다. 두 시간의 피크 구간에 주문 1만 건을 처리해야 한다고 해보자. 사용자가 검색하고 장바구니를 조작하고 체크아웃까지 가는 동안 몇 번의 HTTP 요청이 생기는지 세어본다. 주문 한 건이 평균 20 요청을 만든다면 1만 건은 두 시간에 약 20만 요청이다.
200,000 requests / 7,200 seconds ≈ 28 requests per second
평균 28 RPS가 나온다. 다만 이 값을 곧바로 테스트 목표로 쓰면 안 된다. 이 계산은 "완료된 주문"이 만드는 트래픽만 잡은 것이다. 실제로는 단순 탐색, 이탈한 장바구니, 백그라운드 요청 같은 다른 여정이 더해져 총량이 훨씬 커지고, 트래픽이 시간에 고르게 퍼지는 일도 드물다. 짧은 피크와 안전 마진을 함께 고려해야 한다.
프로덕션 지표가 마땅치 않은 상황이라면 이쪽으로 목표를 세우면 된다. 기술 데이터든 비즈니스 요구사항이든, 출발점은 둘 중 어느 쪽이어도 상관없다.
외부 서비스를 목으로 대체할 때와 그러지 말아야 할 때 #
외부 서비스는 따로 판단이 필요하다. LLM API처럼 유료로 과금되는 서드파티가 엔드포인트 뒤에 있다면 목으로 대체하는 게 합리적이다. 성능 테스트는 짧은 시간에 많은 요청을 만들어내므로 비용 문제가 현실적으로 걸린다.
애초에 외부 호출이 테스트 범위가 아닌 경우도 있다. 단순 참조 데이터 API나, 성능 측정 대상이 아닌 결제 대행사 같은 것들이다. 이럴 때는 WireMock 같은 도구로 통제 가능한 의존성으로 바꿔 원하는 응답을 돌려주게 만든다. 외부 서비스의 성능이나 레이트 리밋, 가용성이 결과에 섞여 들어가 정작 우리 쪽 병목을 가리는 일을 막을 수 있다.
반대로 외부 서비스와의 통신이 실제 성능에서 중요한 부분이라면 별도로 테스트하거나 성능 테스트에 포함시켜야 한다. 목으로 대체할지 말지는 무엇을 재현하고 무엇을 측정하려는지에 따라 갈린다.
환경은 프로덕션에 얼마나 가까워야 하나 #
환경이 프로덕션과 크게 다르면 결과가 오해를 부른다. 실제 부하에서의 거동을 추정하려는 경우라면 특히 그렇다.
먼저 애플리케이션 설정은 프로덕션과 같거나 거의 같아야 한다. API가 도는 서버나 클러스터의 CPU, 메모리, 스케일링 규칙, 리소스 제한도 비슷해야 한다.
DB도 마찬가지인데, 리소스만의 문제가 아니다. 거의 빈 데이터베이스를 상대로 테스트하는 걸 피해야 한다. 데이터의 양과 분포는 성능에 큰 영향을 준다. 테이블에 수백만 행이 있을 때와 테스트 레코드 몇 개만 있을 때, 높은 부하에서의 CRUD·조인·필터링·정렬은 전혀 다르게 동작한다. 인덱스, 쿼리 실행 계획, 통계, 캐싱 모두 데이터 크기와 구조에 따라 달라진다. 그러니 테스트 DB에는 가능한 한 현실적인 양의 대표성 있는 데이터를 넣어둬야 한다.
Redis나 인메모리 캐시 설정도 챙겨야 한다. 캐시 구성이 다르거나 항상 따뜻한 캐시 상태로 테스트하면 실제 프로덕션과 동떨어진 결과가 나온다.
네트워크 조건도 변수다. 외부 서비스를 로컬에 목으로 띄우면 요청이 거의 즉시 끝나지만, 프로덕션의 실제 서비스는 수십에서 수백 밀리초의 지연을 더한다. 측정 목적에 따라 이 지연을 의도적으로 재현해야 할 수도 있다.
마지막은 부하 생성기 자체다. 이건 잊기 쉽다. 부하를 만드는 머신에 CPU, 메모리, 네트워크 용량, 가용 커넥션이 충분하지 않으면 테스트 대상이 아니라 부하 생성기가 병목이 된다.
지표는 여러 개를 함께 봐야 한다 #
테스트를 돌린 뒤에는 결과를 평가하고 보고서를 만든다. 어떤 지표를 볼지는 테스트 유형에 따라 갈린다. 유형마다 답하려는 질문 자체가 다르다.
부하 테스트는 기대 워크로드가 이미 정해져 있다. 그 부하에서 성능이 허용 범위에 머무는지 확인하는 게 목적이다. 주요 지표는 이렇다.
- 응답 시간 — 특히 p95, p99 같은 퍼센타일
- 에러율 — 실패한 요청의 비율
- 처리량 — 기대한 요청 수를 실제로 처리했는지
- 리소스 사용량 — CPU, 메모리, DB 커넥션, 커넥션 풀 등
특정 엔드포인트의 p95가 기대보다 크게 높다면 거기서부터 병목을 파고들면 된다. 에러율이 허용 한계를 넘으면 어떤 요청이 왜 실패하는지 찾아야 한다.
스트레스 테스트는 목적이 조금 다르다. 기대 수준을 넘겨 부하를 의도적으로 올리고, 성능이 꺾이기 시작하는 지점을 찾는다. 부하가 오를 때 응답 시간과 에러율이 어떻게 변하는지, CPU·메모리·DB 커넥션·큐 같은 제한된 리소스가 어떻게 반응하는지를 함께 본다. 시스템이 포화되고, 에러가 과하게 나오고, 요구 처리량을 유지하지 못하는 지점을 찾는 것이다.
부하가 줄어든 뒤의 거동도 볼 만하다. 극한 부하에서 느려졌다가 회복하는 시스템과, 그대로 멈춰 재시작이 필요한 시스템은 전혀 다르다.
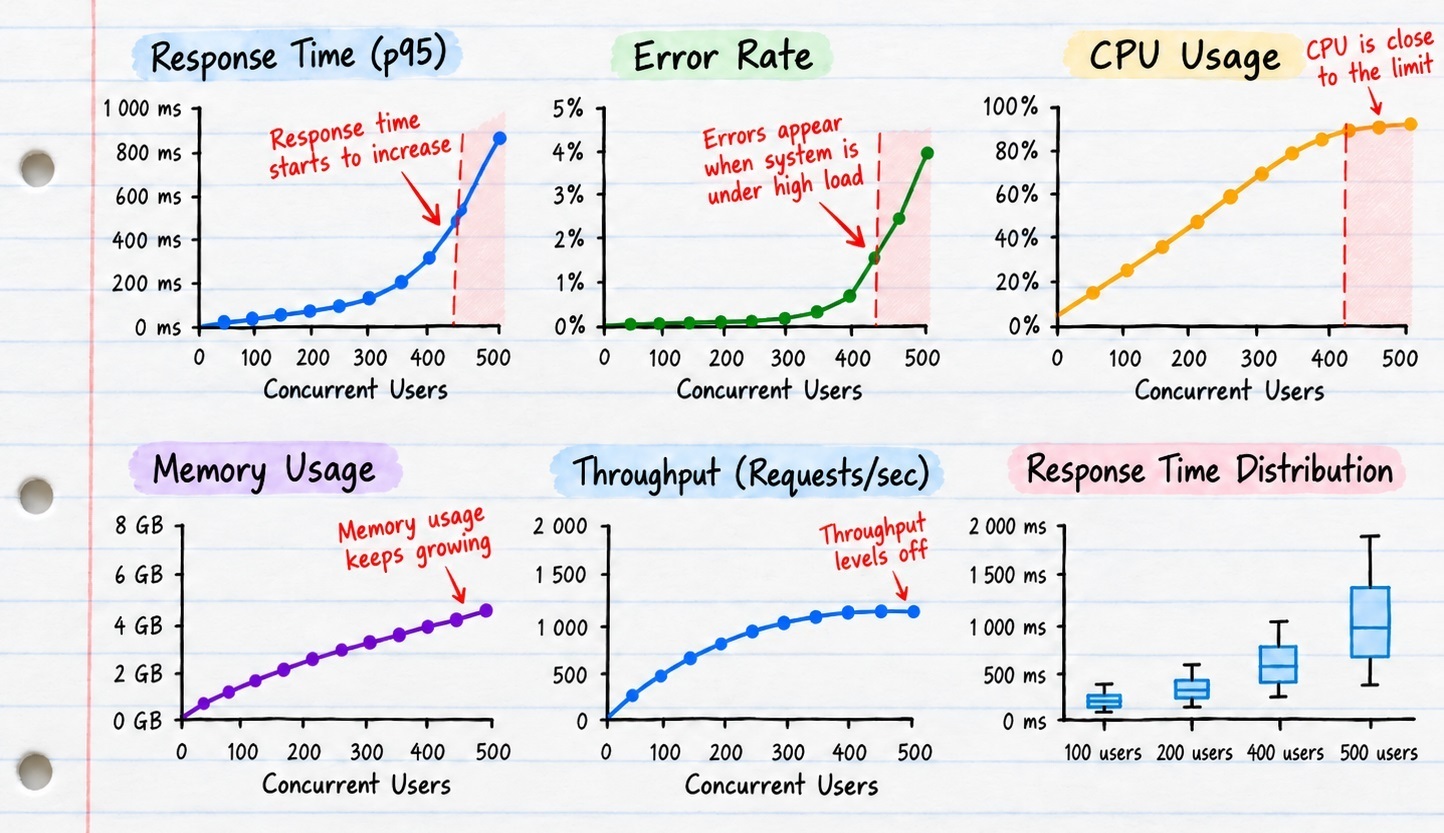
그래서 최종 보고서에 평균 응답 시간 같은 숫자 하나만 담으면 안 된다. 생성한 워크로드를 지연, 처리량, 에러, 리소스 사용률과 연결해야 기대에 못 미쳤는지뿐 아니라 왜 그랬는지까지 읽힌다.
정리 #
Balcarek은 이미 성능 테스트 이론과 유형을 설명한 글이 많다는 걸 인정한다. 그가 하려던 건 이론의 반복이 아니라, 현실적인 테스트를 설계하는 자신의 방식을 실무 관점에서 보여주는 것이었다.
챙길 건 네 가지다. 애플리케이션이 실제로 어떻게 쓰이는지 파악하고, 테스트 환경을 현실에 가깝게 맞추고, 대표성 있는 워크로드를 만들고, 맞는 지표를 보는 것. 여기까지 제대로 설계됐을 때 성능 테스트는 병목과 시스템 한계, 부하 아래의 전반적 거동에 대해 쓸 만한 정보를 준다.
워크로드와 환경, 지표가 충분히 현실적이어야 결과도 쓸모가 생긴다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.