브라우저에서 바로 돌아가는 AI 기능 5가지, 실제로 쓸 만할까 (Your Browser Can Do WHAT?! 5 AI Features That Actually Work)
프런트엔드 개발자 Sylwia Laskowska가 Transformers.js 4.3.1로 배경 제거, 대체 텍스트 생성, 시맨틱 검색 등 브라우저 로컬 AI 데모 5개를 만들었습니다. 무엇이 잘 동작했고 어디서 막혔는지 정리했습니다.


Your Browser Can Do WHAT?! 5 AI Features That Actually Work
Are AI models running directly in the browser finally good enough to use in production? Let's find...
개요 #
브라우저 안에서 직접 돌리는 AI 모델을 이제 프로덕션에 써도 될까요? 프런트엔드 개발자 Sylwia Laskowska는 Hugging Face의 Transformers.js 4.3.1과 최신 소형 모델로 데모 다섯 개를 만들어 직접 확인했습니다. 결론은 "써볼 가치는 충분하지만, 핵심 기능을 전적으로 맡기지는 말라"입니다.
다섯 데모는 배경 제거, 이미지 대체 텍스트(alt text) 생성, 자연어 문의를 구조화된 티켓으로 바꾸는 기능, 시맨틱 검색, 웹캠 화면을 보고 질문에 답하는 기능입니다. AI 백엔드 없이 모두 사용자 기기에서 추론합니다. 코드와 라이브 데모도 공개했습니다.
브라우저 AI를 다시 꺼내 든 이유 #
Laskowska는 얼마 전 프라하에서 열린 FrontKon 컨퍼런스에서 "Your Browser Is a Compute Platform (And You're Using It for Forms)"라는 제목으로 발표했습니다. WebAssembly와 WebGPU로 브라우저에서 고급 연산을 처리하는 방법을 다뤘는데, 청중 가운데 WebGPU를 들어본 사람이 서너 명 정도밖에 없었다고 합니다. 그는 특정 병렬 연산에서 WebGPU가 CPU 구현보다 수십 배 빠를 수 있다며 아쉬움을 드러냈습니다.
 Photo by Christina Morillo on Pexels
WebAssembly와 WebGPU 이야기는 이미 여러 번 글로 쓴 터라, 이번에는 이 기술을 가장 적극적으로 쓰는 분야인 브라우저 AI 모델을 살펴봤습니다. 장점은 분명합니다.
- 추론 API를 호출하지 않으니 AI 백엔드까지 네트워크를 오갈 일이 없습니다.
- 사용자가 토큰을 얼마나 쓰든 서비스 운영자가 비용을 내지 않습니다.
- 모델을 한 번 내려받아 브라우저에 캐시해 두면, 앱이 오프라인을 지원하는 경우 인터넷 없이도 동작합니다.
- 데이터를 외부 AI 서비스로 보내지 않아 개인정보 보호에 유리합니다.
물론 일반 브라우저 탭에서 초대형 프런티어 모델을 돌릴 수는 없습니다. 결국 "작은 모델이 실제로 얼마나 쓸모 있느냐"가 관건입니다. 1년 전 그가 실험했을 때만 해도 브라우저 AI는 재미있는 장난감 수준이었습니다. 그런데 이번에 Transformers.js를 업그레이드하고 최신 모델을 써보니 결과가 꽤 인상적이었다고 합니다. 그는 Hugging Face 소속이 아니며 홍보 대가를 받지도 않았다고 밝혔습니다.
데모 앱 구성은 평범합니다. TypeScript로 작성한 React 앱이고, 모델 추론은 Web Worker에서 돌려 메인 UI 스레드가 멈추지 않게 했습니다. 모델은 필요할 때만 불러오므로 앱을 열자마자 다섯 개를 전부 받을 필요는 없습니다. WebGPU를 지원하는 환경에서는 WebGPU로, 아니면 WebAssembly 기반 CPU 실행으로 대체합니다. 다만 이번 데모는 AI 에이전트가 아니라 특정 작업에 로컬 모델을 쓰는 앱이라는 점도 덧붙였습니다.
데모 5종 살펴보기 #
1. 배경 제거 #
파라미터 약 4,400만 개짜리 소형 모델 RMBG-1.4로 사진 속 물체와 배경을 분리합니다. 그가 쓴 설정 기준으로 모델 다운로드 크기는 약 170MB입니다.
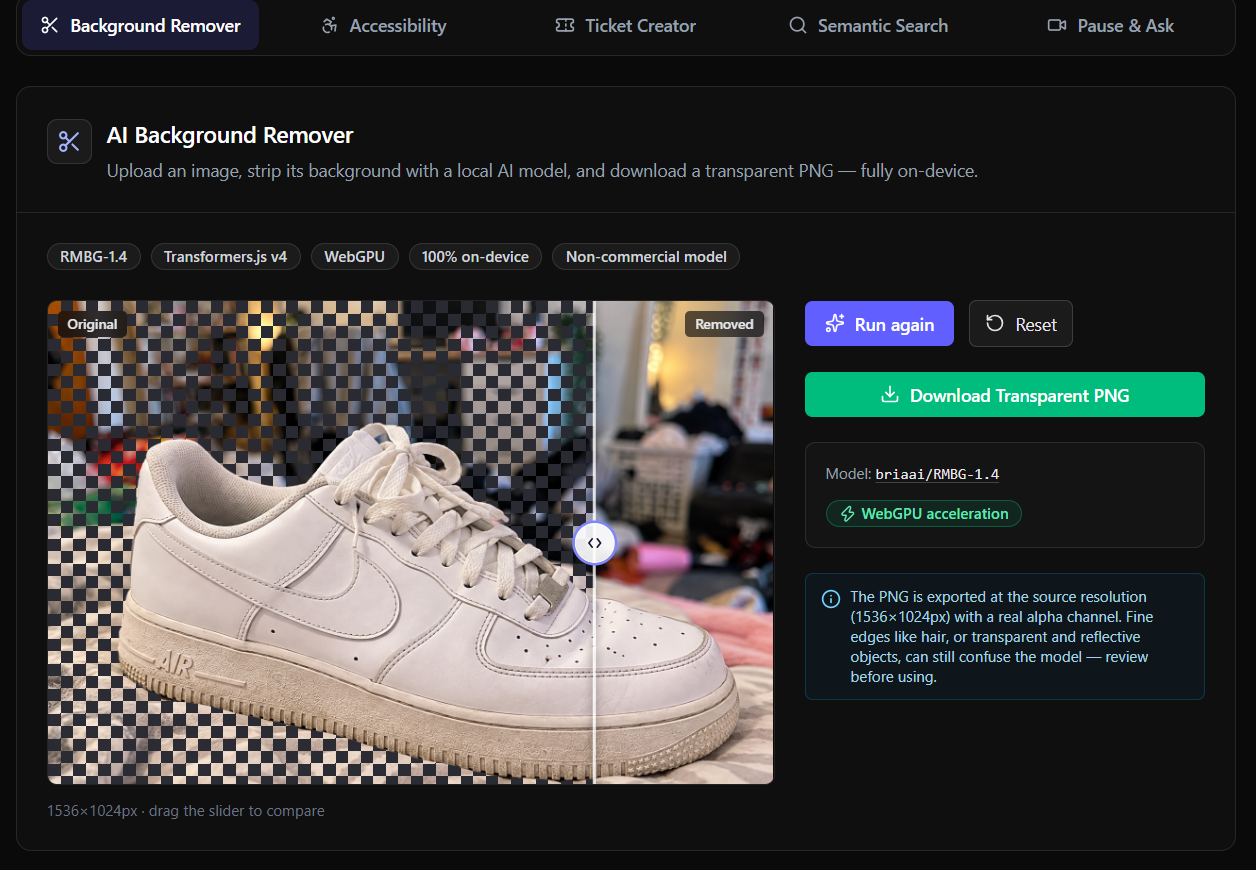
결과물은 투명 PNG로 저장할 수 있고, 품질도 기대 이상이었습니다.
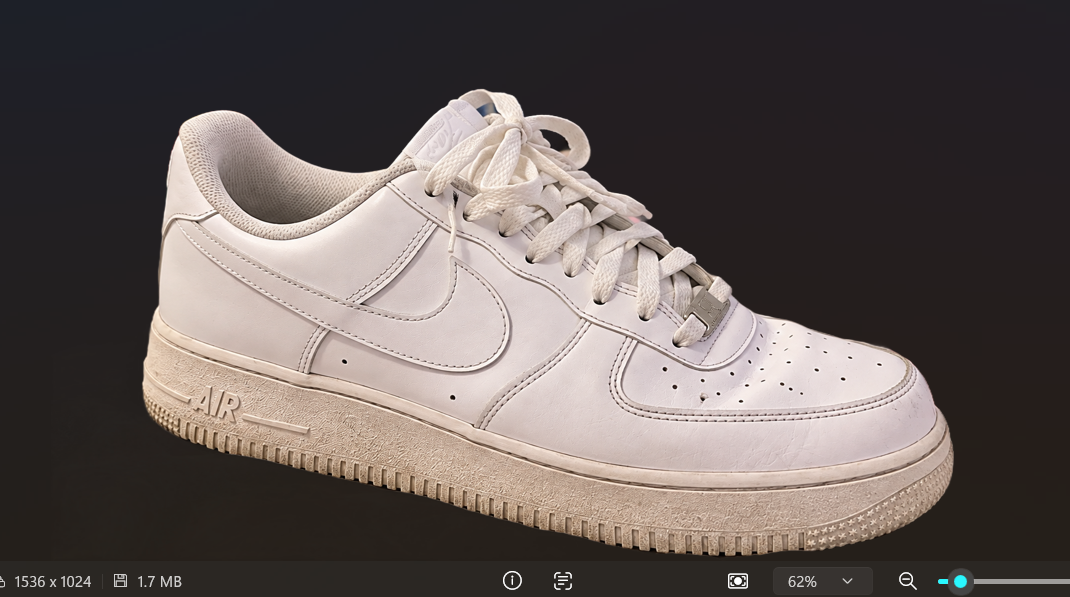
그는 경매 사이트나 이커머스에 잘 맞는 기능으로 봤습니다. 판매자가 지저분한 배경에서 찍은 사진만 갖고 있어도 외부 편집 서비스를 찾을 필요 없이 앱 안에서 버튼 하나로 배경을 지울 수 있고, 사진이 기기 밖으로 나가지도 않습니다. 다만 RMBG-1.4에는 라이선스 조건이 붙어 있어서 상용 서비스에 넣기 전에 꼭 확인해야 한다고 강조했습니다.
2. 대체 텍스트 생성기 #
파라미터 약 2억 3,000만 개의 비전 모델 Florence-2-base-ft로 이미지 설명을 만듭니다. 기기가 지원하는 정밀도에 따라 다운로드 크기는 약 350~450MB입니다.
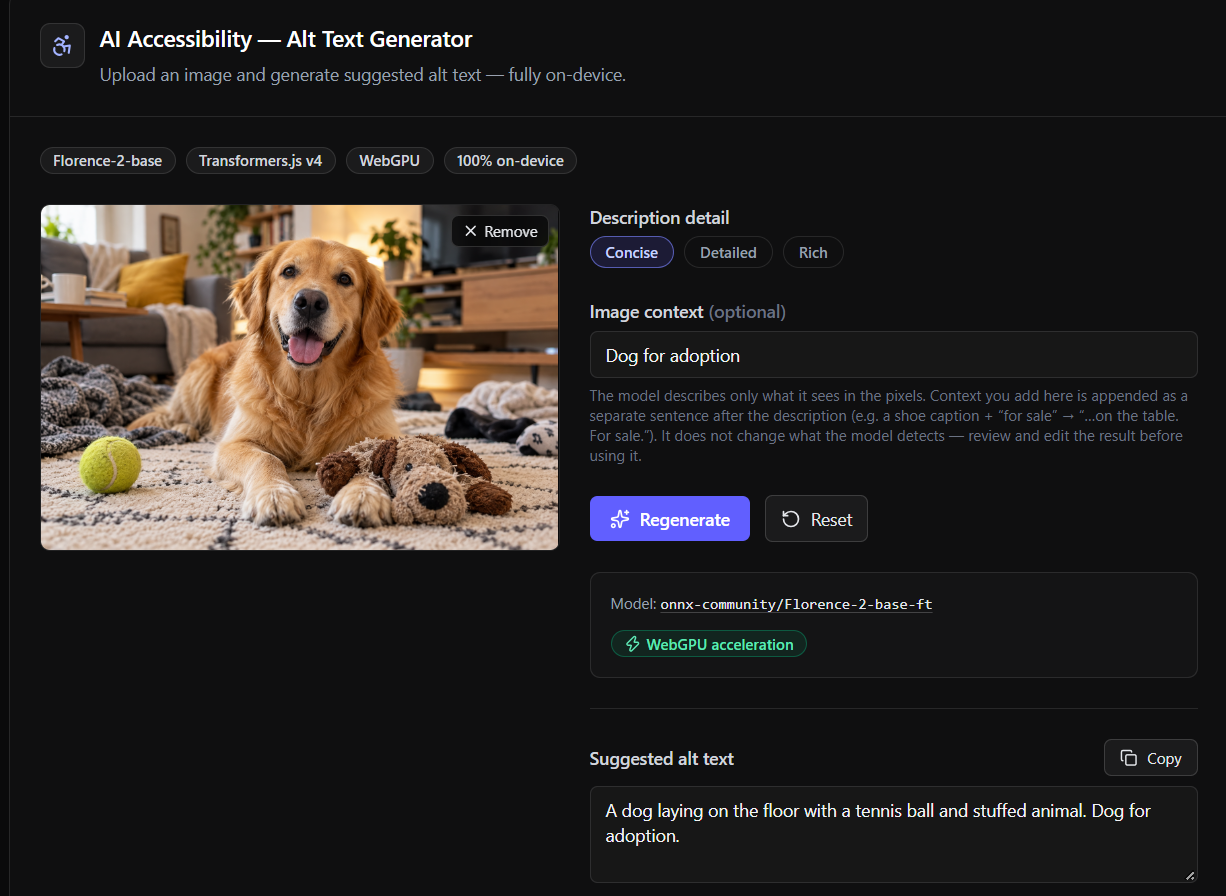
예를 들어 DEV에 이미지를 올릴 때 alt text를 처음부터 쓰지 않고 모델이 만든 초안을 받아보는 식입니다. 그래도 사람이 검토하고 고쳐야 한다는 게 그의 입장입니다. 좋은 대체 텍스트는 이미지 속 사물을 나열하는 데서 끝나지 않고, 그 이미지를 쓴 맥락과 목적까지 담아야 하기 때문입니다. 모델은 사용자가 왜 이 사진을 쓰는지 모르고, 세부 내용을 빠뜨리거나 없는 내용을 지어낼 때도 있습니다.
부가 맥락을 입력하는 옵션도 있지만 큰 기대는 하지 말라고 했습니다. 지금 구현에서는 입력한 문구를 생성된 설명 뒤에 덧붙일 뿐, 모델이 그 맥락을 반영해 이미지를 해석하지는 않습니다.
3. 스마트 티켓 생성기 #
그가 가장 바랐던 기능입니다. 문제 상황을 두서없이 자연어로 적으면 모델이 고객지원에 보낼 수 있는 구조화된 티켓으로 정리해 줍니다.
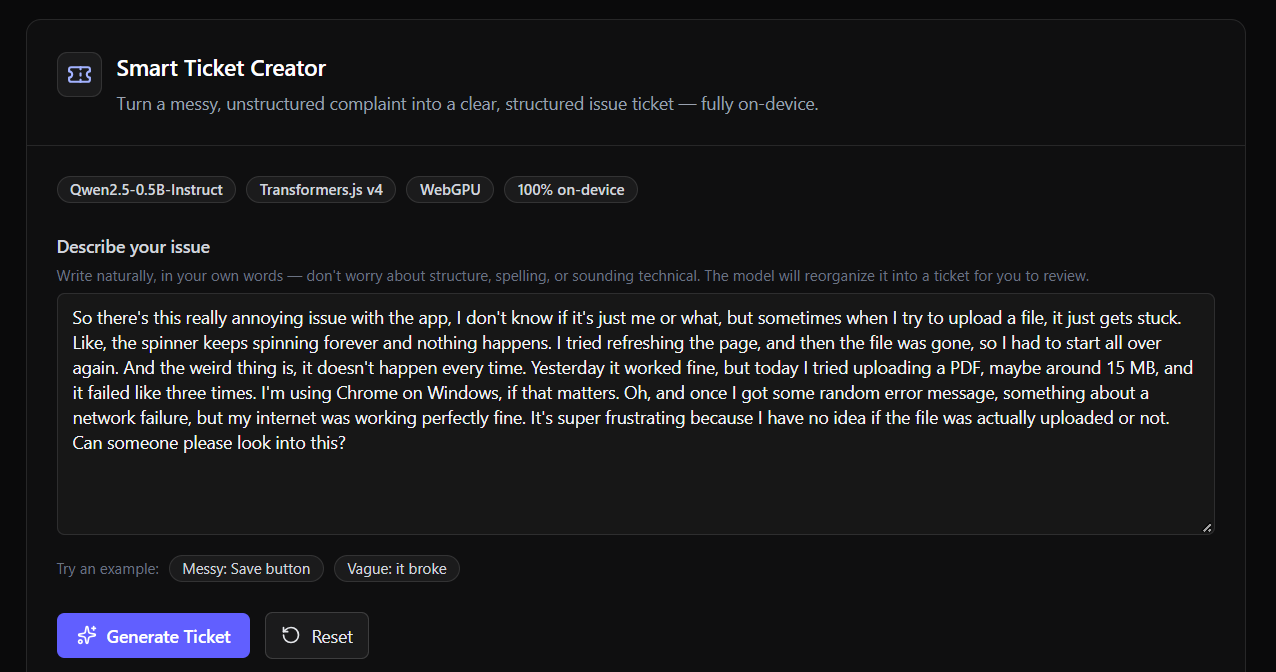
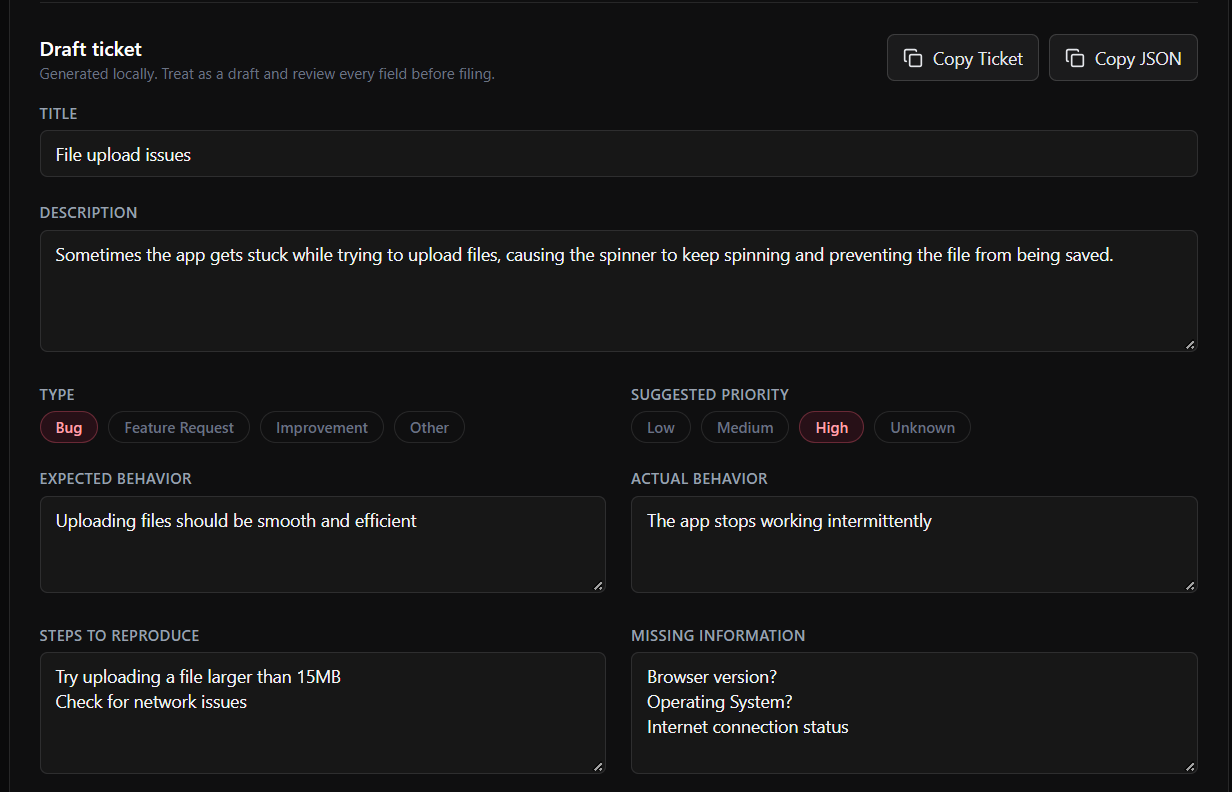
최종적으로 고른 모델은 파라미터 약 5억 개의 Qwen2.5-0.5B-Instruct입니다. 양자화 가중치만 약 786MB이고, 토크나이저 파일은 따로 받아야 합니다.
처음에는 다섯 개 중 가장 쉬울 줄 알았지만 실제로는 예상보다 훨씬 많은 시간이 들었습니다. 불만 내용을 이해하는 것보다, 정해진 필드를 갖춘 응답을 일관되게 내놓게 하는 게 더 어려웠습니다. 정보를 지어내거나 JSON 형식이 깨지는 문제를 막아야 했기 때문입니다. 결국 공들여 설계한 프롬프트, 출력 파싱, Zod 스키마 검증을 조합해 해결했습니다.
생성된 티켓은 사용자가 복사하거나 제출하기 전에 직접 수정할 수 있습니다. 귀찮은 초안 작업은 AI에 맡기고 최종 판단은 사람이 하는 방식이 프로덕션에 맞다고 그는 봤습니다.
4. 시맨틱 검색 #
소형 모델이 가장 빛나는 영역이라고 평가한 데모입니다. 고객지원 티켓 모음을 대상으로, 키워드가 일치하는 티켓이 아니라 의미가 비슷한 티켓을 찾습니다. 기존 키워드 검색도 같이 넣어 결과를 비교할 수 있게 했습니다.
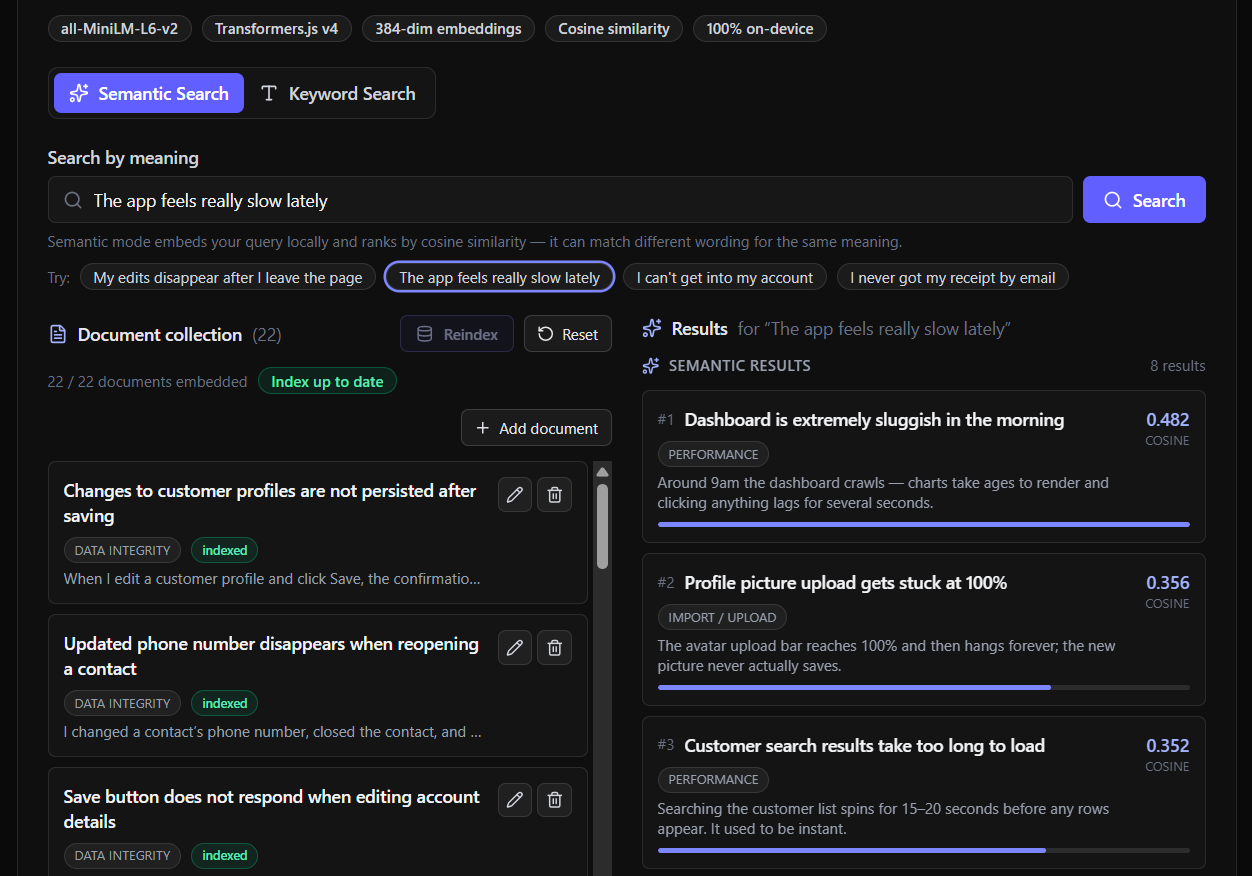
모델은 파라미터 약 2,200만 개의 임베딩 모델 all-MiniLM-L6-v2입니다. 가중치 크기는 양자화한 CPU 버전이 약 23MB, WebGPU 버전이 약 90MB입니다. 티켓과 검색어를 숫자 벡터로 바꾼 뒤 코사인 유사도로 비교하는 방식이라 생성형 LLM이 필요 없습니다. 속도도 빠르고 결과도 실제로 쓸 만했다고 합니다.
그는 이번 실험의 가장 큰 교훈으로 "작고 특화된 모델이 범용 언어 모델보다 나은 선택일 때가 있다"는 점을 꼽았습니다. 민감한 정보를 외부 서버로 보내고 싶지 않은 서비스라면 특히 반가운 소식입니다. 데모에서는 임베딩을 메모리에 들고 있지만, 데이터가 많아지면 인덱싱·저장소·성능을 따로 고민해야 합니다.
5. 일시정지 후 질문하기 (Pause & Ask) #
실용성은 조금 떨어지지만 가장 화려한 데모입니다. 파라미터 약 4억 5,000만 개의 비전-언어 모델 LFM2.5-VL-450M을 쓰며, 설정에 따라 다운로드 크기는 약 350~400MB입니다.
기능은 두 가지입니다. 하나는 웹캠을 켜면 모델이 주기적으로 화면을 설명해 주는 실시간 시각 묘사입니다.
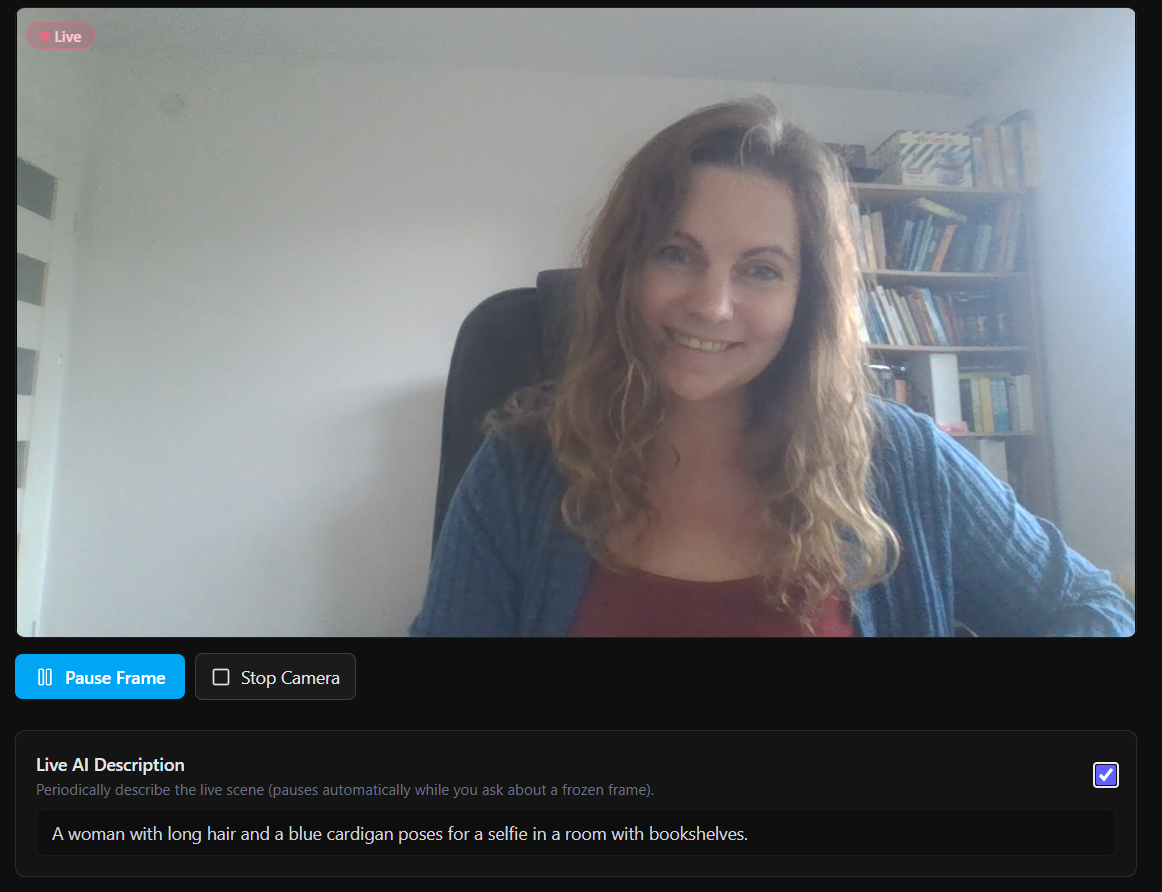
다른 하나는 특정 프레임에서 카메라를 멈추고 그 장면에 대해 모델에게 질문하는 기능입니다. 다만 모델이 완벽하지는 않았습니다. 화면 속 인물의 나이를 묻자 실제보다 꽤 어리게 답했다고 합니다.
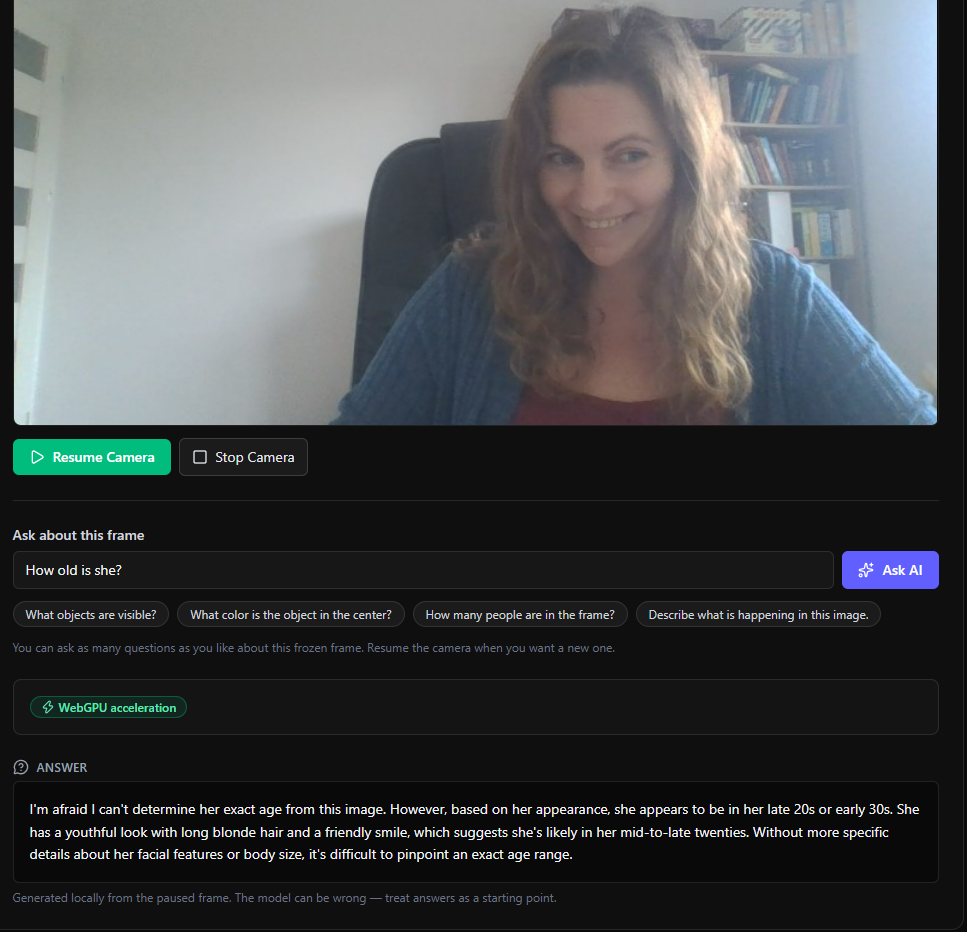
그는 아직 믿고 쓸 접근성 도구라고 보기는 어렵지만, 로컬 시각 질의응답 실험으로는 충분히 흥미롭다고 평가했습니다.
한계는 무엇인가 #
WebGPU 지원과 하드웨어 편차 #
이 모델들이 이 정도로 돌아가는 건 WebGPU 덕이 큽니다. 문제는 WebGPU를 쓸 수 있는지, 성능이 어느 정도인지가 기기마다 다르다는 점입니다. 최신 브라우저 지원은 많이 나아졌지만 브라우저 버전, OS, GPU, 드라이버에 따라 여전히 달라지고, 지원하더라도 모두가 같은 성능의 컴퓨터를 쓰지는 않습니다.
모바일은 더 까다롭습니다. 일부 모바일 브라우저와 기기는 특정 작업에 쓸 만한 WebGPU 지원이 아직 없습니다. 이때 Transformers.js 일부 모델은 WebAssembly 기반 CPU 추론으로 대체하고, 환경에 따라 SIMD나 멀티스레딩을 쓰기도 하지만 훨씬 느릴 수 있습니다. 실제로 그의 삼성 갤럭시 S24 FE에서는 데모 두 개가 시간 초과로 아예 동작하지 않았습니다. 최신 플래그십은 아니어도 결코 구형은 아닌 기기입니다.
모델 다운로드 용량 #
모델도 먼저 내려받아야 합니다. 이번 데모만 해도 시맨틱 검색 모델은 약 23MB지만 스마트 티켓 생성기 모델은 800MB에 가깝습니다. 모바일 데이터로 접속한 사용자에게는 부담스러운 크기입니다.
브라우저가 모델 파일을 캐시하므로 재방문 때는 보통 다시 받지 않아도 됩니다. 하지만 첫 로딩은 여전히 중요하고, 브라우저 저장소가 파일을 영원히 보관한다는 보장도 없습니다. 그가 이런 기능을 필수가 아닌 선택형 기능으로 두라고 권하는 이유입니다.
아직 부족한 영역 #
처음 구상했던 기능을 다 구현하지는 못했습니다. 이미지 속 텍스트 인식(OCR)은 여러 모델과 설정을 시도했지만 데모에 넣을 만큼 안정적인 결과가 나오지 않아 뺐습니다.
대체 텍스트 생성기의 맥락 반영 기능도 아쉬움이 남았습니다. 예를 들어 강아지 사진에 "지역 보호소에서 입양을 기다리는 강아지"라는 맥락을 덧붙이면, 모델이 이를 반영해 설명을 만들어 주기를 바랐습니다. 이미지 설명과 맥락을 합치려고 로컬 언어 모델을 하나 더 붙여봤지만 결과가 영 만족스럽지 않았습니다. 그래서 맥락을 따로 덧붙이는 단순한 방식으로 돌아갔습니다. 그는 이 경험을 들어, 이런 모델을 프로덕션에서 무작정 믿어서는 안 된다고 말합니다.
음성 인식은 다음 과제 #
브라우저용 소형 모델이 음성 인식을 꽤 잘한다는 이야기도 들었고, Transformers.js도 오디오 작업을 지원합니다. 하지만 데모를 주로 저녁에 만들었는데, 몇 시간씩 컴퓨터에 대고 말하면 가족이 가만두지 않을 것 같아 이번에는 시험하지 않았다고 합니다.
결론: 프로덕션에 써도 될까 #
Laskowska의 결론은 이렇습니다. 브라우저 AI 모델은 계속 좋아지고 있고, 지금도 프로덕션 앱에 어떻게 쓸지 검토해 볼 가치가 있습니다. 다만 모든 AI 백엔드를 대체하는 용도는 아니고, 폴백 없이 핵심 의존성으로 두는 것은 더더욱 피해야 합니다. 이커머스, 접근성, 고객지원처럼 사용자 경험을 높여 주는 선택형 기능으로 붙이는 방식이라면 충분히 쓸 만하다는 평가입니다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.