9년치 Dev.to 데이터를 직접 뽑아봤다 — 숫자는 예상과 달랐다
2017년부터 Dev.to에 글을 써온 개발자가 공개 API로 팔로워·조회수·댓글 데이터를 전수 조사했다. 팔로워 1만 8천 명과 조회수 1만 4천 회가 공존하는 이유, 그리고 지표가 실제로 말해주는 것.


I Pulled Nine Years of My Own Dev.to Data. The Numbers Were Not What I Expected.
There is an API. It will tell you things about your writing that the dashboard will not. I have been...
개요 #
Ken W Alger는 2017년 4월부터 Dev.to에 글을 써왔다. 중간에 4년 가까이 거의 글을 올리지 않은 공백이 있고, 2026년 3월에 돌아와 6개월 만에 86편을 썼다. 같은 계정에 성격이 완전히 다른 두 덩어리의 글이 쌓인 셈이다.
그가 원래 만들려던 건 단순한 차트였다. 팔로워 증가 곡선 위에 글 발행일을 찍어서, 어떤 글이 선을 끌어올렸는지 보는 것. 그런데 손에 쥔 건 차트가 아니었다. 자기 지표 중 뭐가 의미 있고 뭐가 아닌지를 처음부터 다시 배우는, 꽤 불편한 시간이었다.
이걸 가능하게 한 건 Dev.to의 공개 API다. 그의 표현대로라면, 쓰는 사람이 거의 없는 API다.
API는 분명히 존재한다 #
베이스 URL은 https://dev.to/api다. 키는 Settings → Extensions → DEV Community API Keys에서 발급받는다. 본인 데이터를 읽는 대부분의 엔드포인트는 이 키를 api-key 헤더에 넣어야 한다.
그리고 오후 시간을 조용히 날려먹을 수 있는 함정이 하나 있다.
headers = {
    "api-key": key,
    # 이 줄을 빼면 v0 응답이 온다. 에러도, 경고도 없다.
    "accept": "application/vnd.forem.api-v1+json",
    "user-agent": "my-analytics-script/1.0",
}
accept 헤더가 없으면 구버전 v0 시리얼라이저가 응답한다. 실패하지 않는다. 응답 구조만 조용히 달라진다. 문서에 있는 필드가 왜 안 보이는지 20분쯤 헤매게 된다.
첫 번째: 기본 페이지 크기는 최댓값이 아니다 #
팔로워 엔드포인트는 페이지당 80개를 반환한다고 문서화돼 있다. Alger의 팔로워는 1만 8천 명이 조금 넘으니, 그대로 믿으면 227번을 왕복해야 한다.
실제 v1 페이지네이션 범위는 1000까지다. 80은 기본값이지 상한이 아니었다.
batch = client.get(
    f"{API_ROOT}/followers/users",
    params={"page": page, "per_page": 1000},
).json()
227번이 19번으로 줄었다. 전체 수집에 31초가 걸렸다.
다만 Forem 인스턴스는 환경 변수로 per_page 상한을 더 낮게 걸 수 있다. 그러니 값을 하드코딩하지 말고, 최대치를 요청한 뒤 돌아온 결과에서 실제 보폭을 배우는 편이 낫다.
if page == 1 and len(batch) < requested:
    # 서버가 제한했거나, 이게 전체 목록이거나.
    # 어느 쪽이든 이것이 실제 페이지 크기다.
    page_size = len(batch)
레이트 리밋도 실재하고 꽤 빡빡하다. 429가 뜨면 백오프하고, 페이지 사이에 쉬고, 몇 페이지마다 병합 결과를 디스크에 체크포인트로 남겨야 한다. 190페이지에서 죽었다고 앞선 189페이지를 버릴 이유는 없다.
두 번째: 팔로워 날짜가 기록한 적 없는 역사를 복원한다 #
Alger가 API에서 가장 쓸모 있다고 꼽은 지점이자, 놓치기 쉬운 지점이다.
/api/followers/users는 팔로워마다 created_at을 돌려준다. 그 사람이 나를 팔로우하기 시작한 날짜다. 매일 팔로워 수를 스냅샷으로 찍어두고 반년을 기다릴 필요가 없다. 한 번만 당기면 첫 팔로워까지 거슬러 올라가는 곡선 전체가 소급 복원된다.
from collections import Counter
from datetime import date, timedelta

dates = sorted(
    date.fromisoformat(f["created_at"][:10]) for f in followers
)
cumulative = list(range(1, len(dates) + 1))  # 성장 곡선, 공짜로

weekly = Counter(d - timedelta(days=d.weekday()) for d in dates)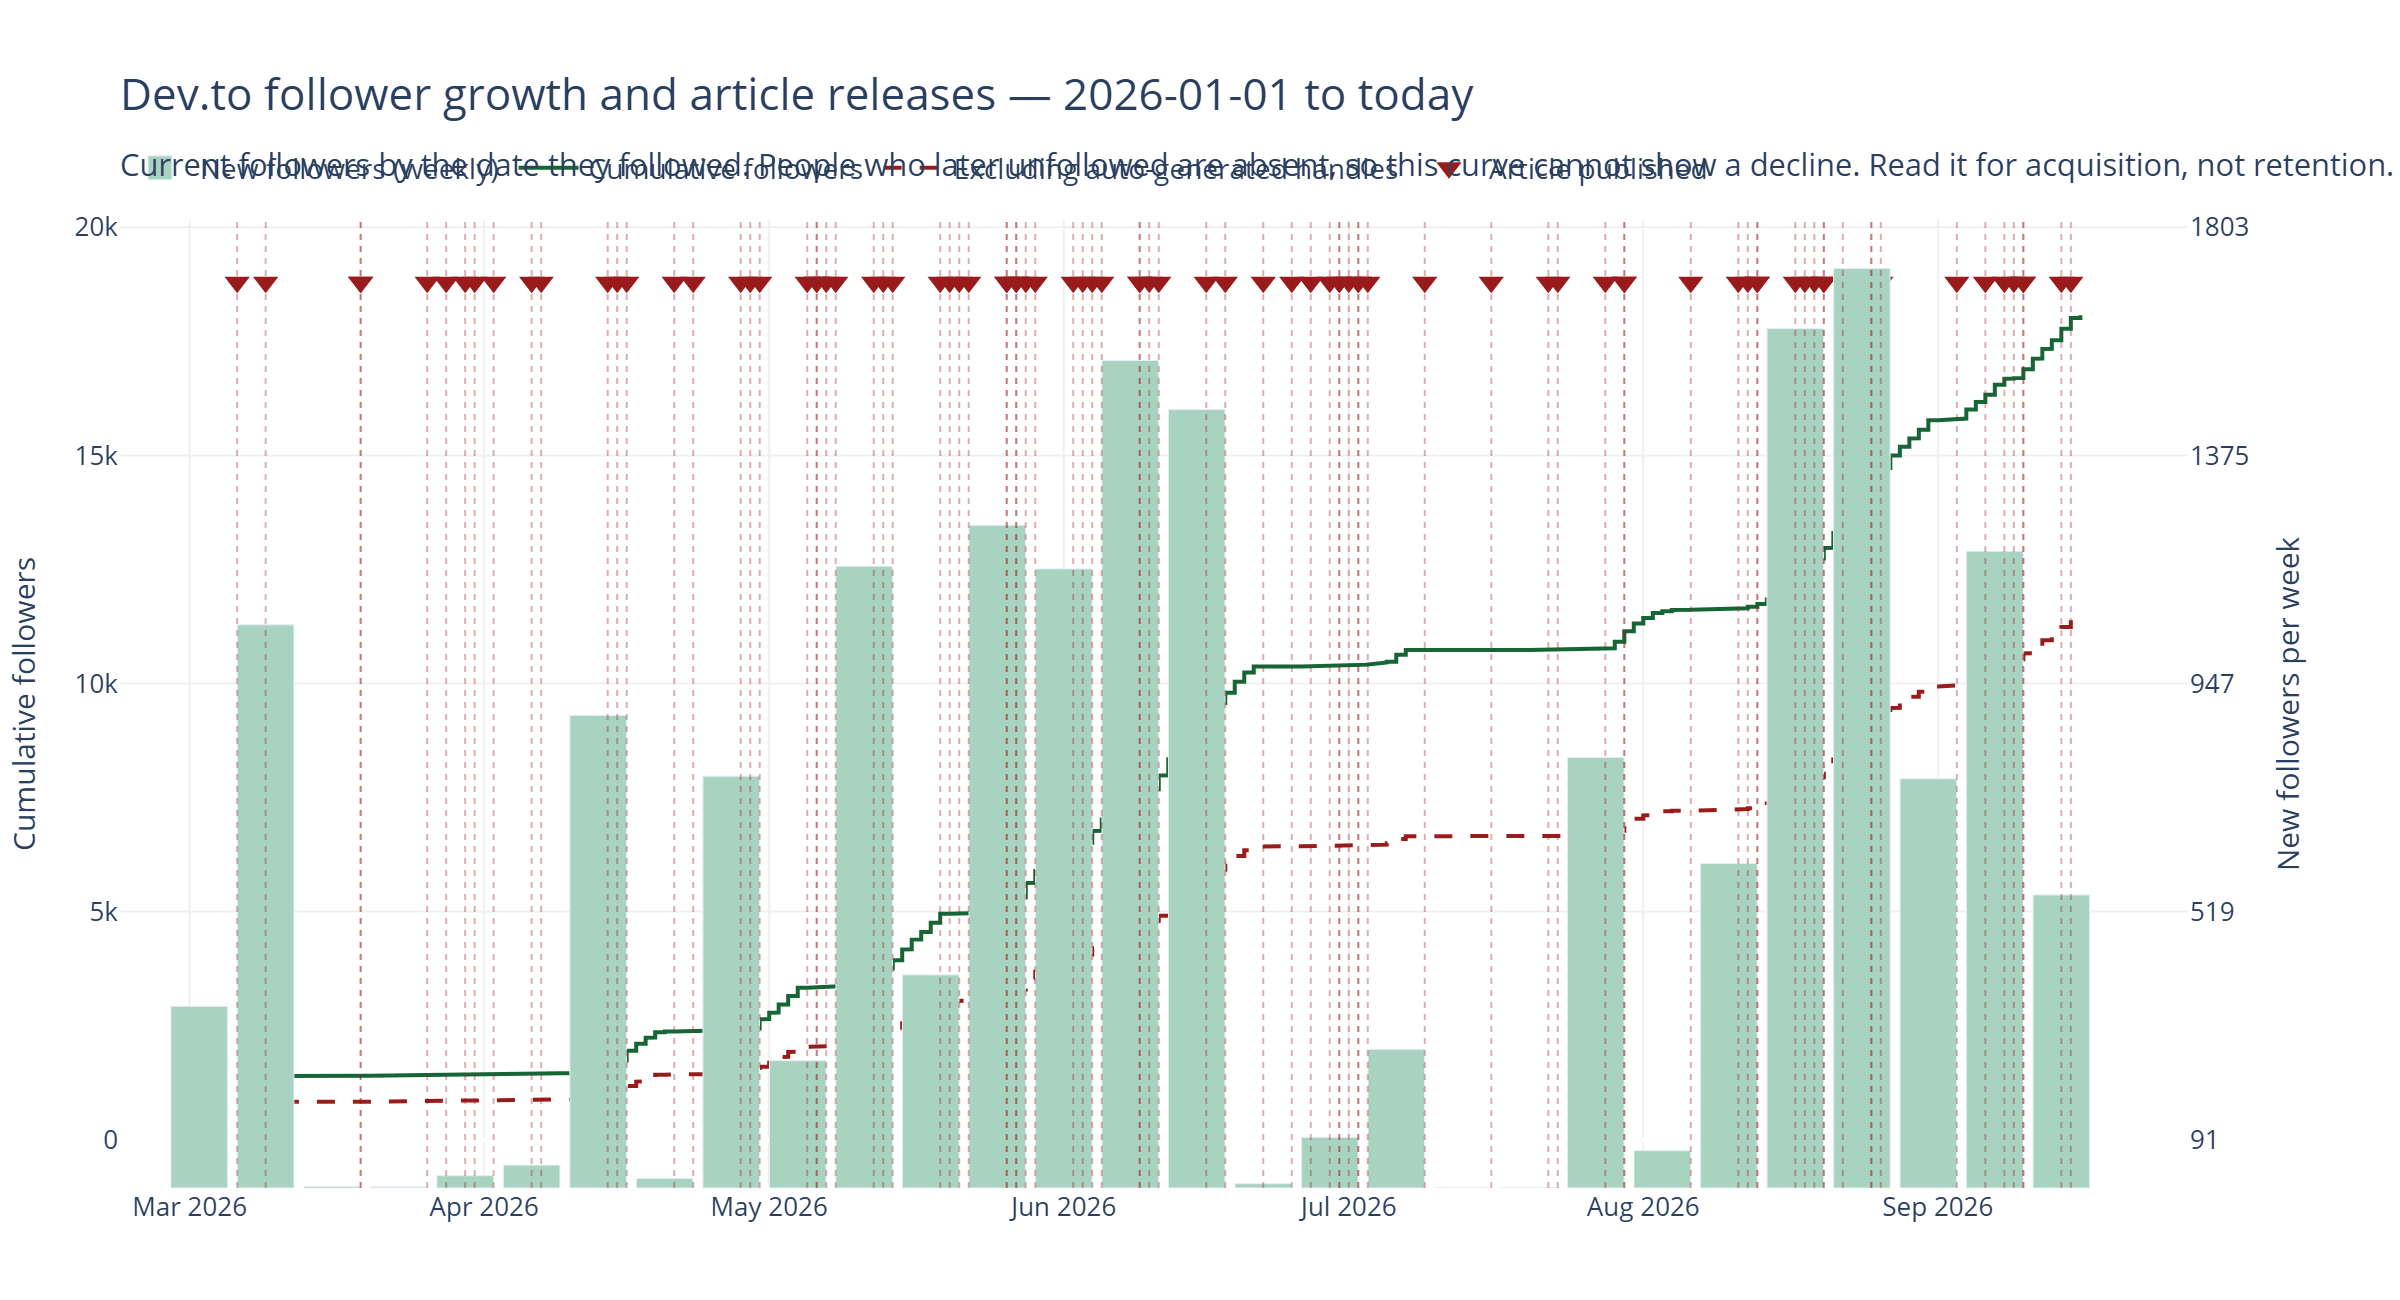
그런데 짚고 넘어가야 할 함정이 있다. API가 주는 건 지금 나를 팔로우 중인 사람뿐이다. 팔로우했다가 끊은 사람은 데이터셋에서 사라졌다. 그러니 이 곡선은 "현재 팔로워를 획득 시점별로 정렬한 것"이지, 특정 날짜의 실제 팔로워 수가 아니다. 구조상 단조 증가할 수밖에 없고, 실제로 일어난 하락은 절대 보여주지 못한다.
어떤 글이 유입을 만들었는지 보는 용도로는 괜찮다. 다만 이탈이나 유지율을 보려는 순간, 대놓고 사람을 속이는 지표로 바뀐다.
세 번째: 분석 엔드포인트는 있는데 문서가 거의 없다 #
서드파티 도구 대부분이 무시하는 analytics 계열이 통째로 존재한다.
/api/analytics/totals               누적 조회·반응·댓글
/api/analytics/historical           기간별 일간 시계열
/api/analytics/past_day             최근 24시간, 시간 단위
/api/analytics/referrers            트래픽 유입 경로
/api/analytics/follower_engagement  기간별 팔로워 증가
/api/analytics/dashboard            누적 + 히스토리 + 인기글 묶음
전부 article_id를 받아서 글 하나로 범위를 좁힐 수 있다. 알아둘 게 두 가지다.
먼저, 응답으로 숫자가 툭 오지 않는다. 한 겹 더 감싼 객체로 온다.
{"page_views": {"total": 246454, "average_read_time_in_seconds": 306}}그리고 과거로 갈수록 데이터가 열화된다. Alger의 2017년 글은 일간이 아니라 주간 버킷으로 돌아왔고, 합산해봐야 그 글들의 누적 조회수 중 15% 정도밖에 설명하지 못했다. 2019년은 95%, 2026년은 100%였다.
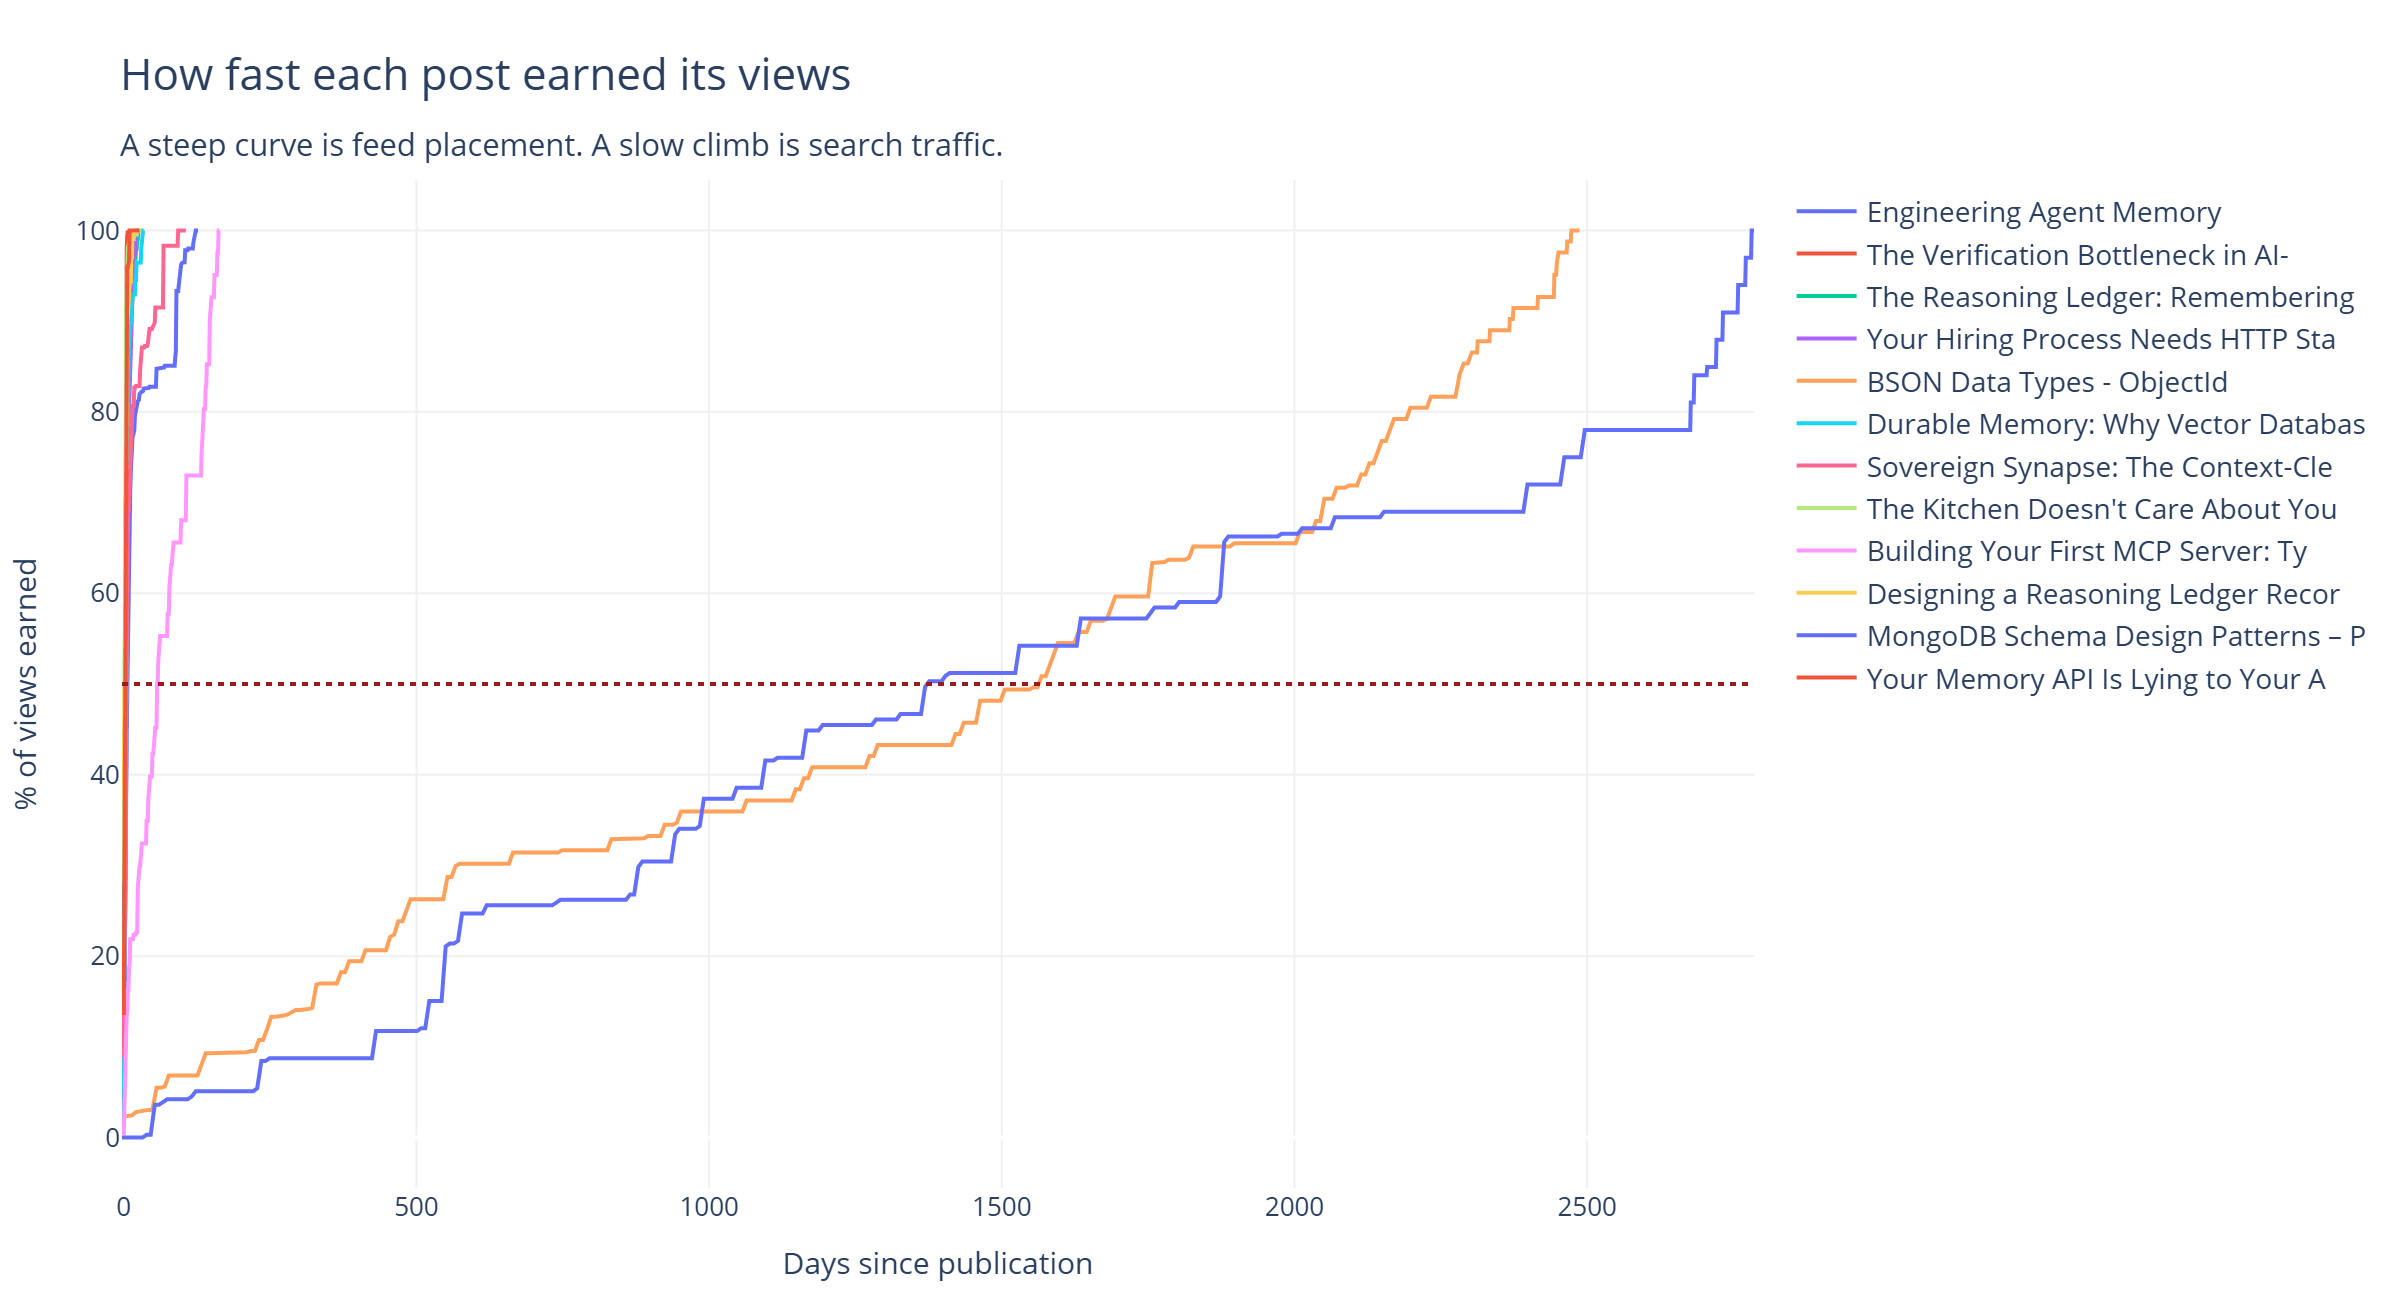
이게 생각보다 큰 문제다. 그는 글마다 "반감기"를 계산했다. 발행 후 누적 조회수의 절반을 채우기까지 걸린 일수다. 첫 시도는 2017년 글 몇 편의 반감기가 3,000일쯤 된다고 자신 있게 보고했다. 사실이 아니다. 엔드포인트가 그 글들이 벌어들인 대부분을 기억하지 못할 뿐이고, 기억하는 일부만 나누면 정밀하고 권위 있어 보이는 무의미한 숫자가 나온다.
해법은 커버리지 게이트였다.
lifetime = article["page_views_count"]
tracked = sum(daily_series.values())

# 조회수의 15%만 설명하는 시계열도 자신만만한 반감기를 뱉는다.
# 그건 글이 어떻게 소비됐는지가 아니라
# 엔드포인트가 무엇을 남겨뒀는지의 부산물이다.
if lifetime and tracked < lifetime * 0.8:
    continue
130편 중 82편이 이 게이트를 통과했다. 통과한 글들의 반감기 중앙값은 4일이었다.
네 번째: 일부 메타데이터는 JSON이 아니라 마크다운에 있다 #
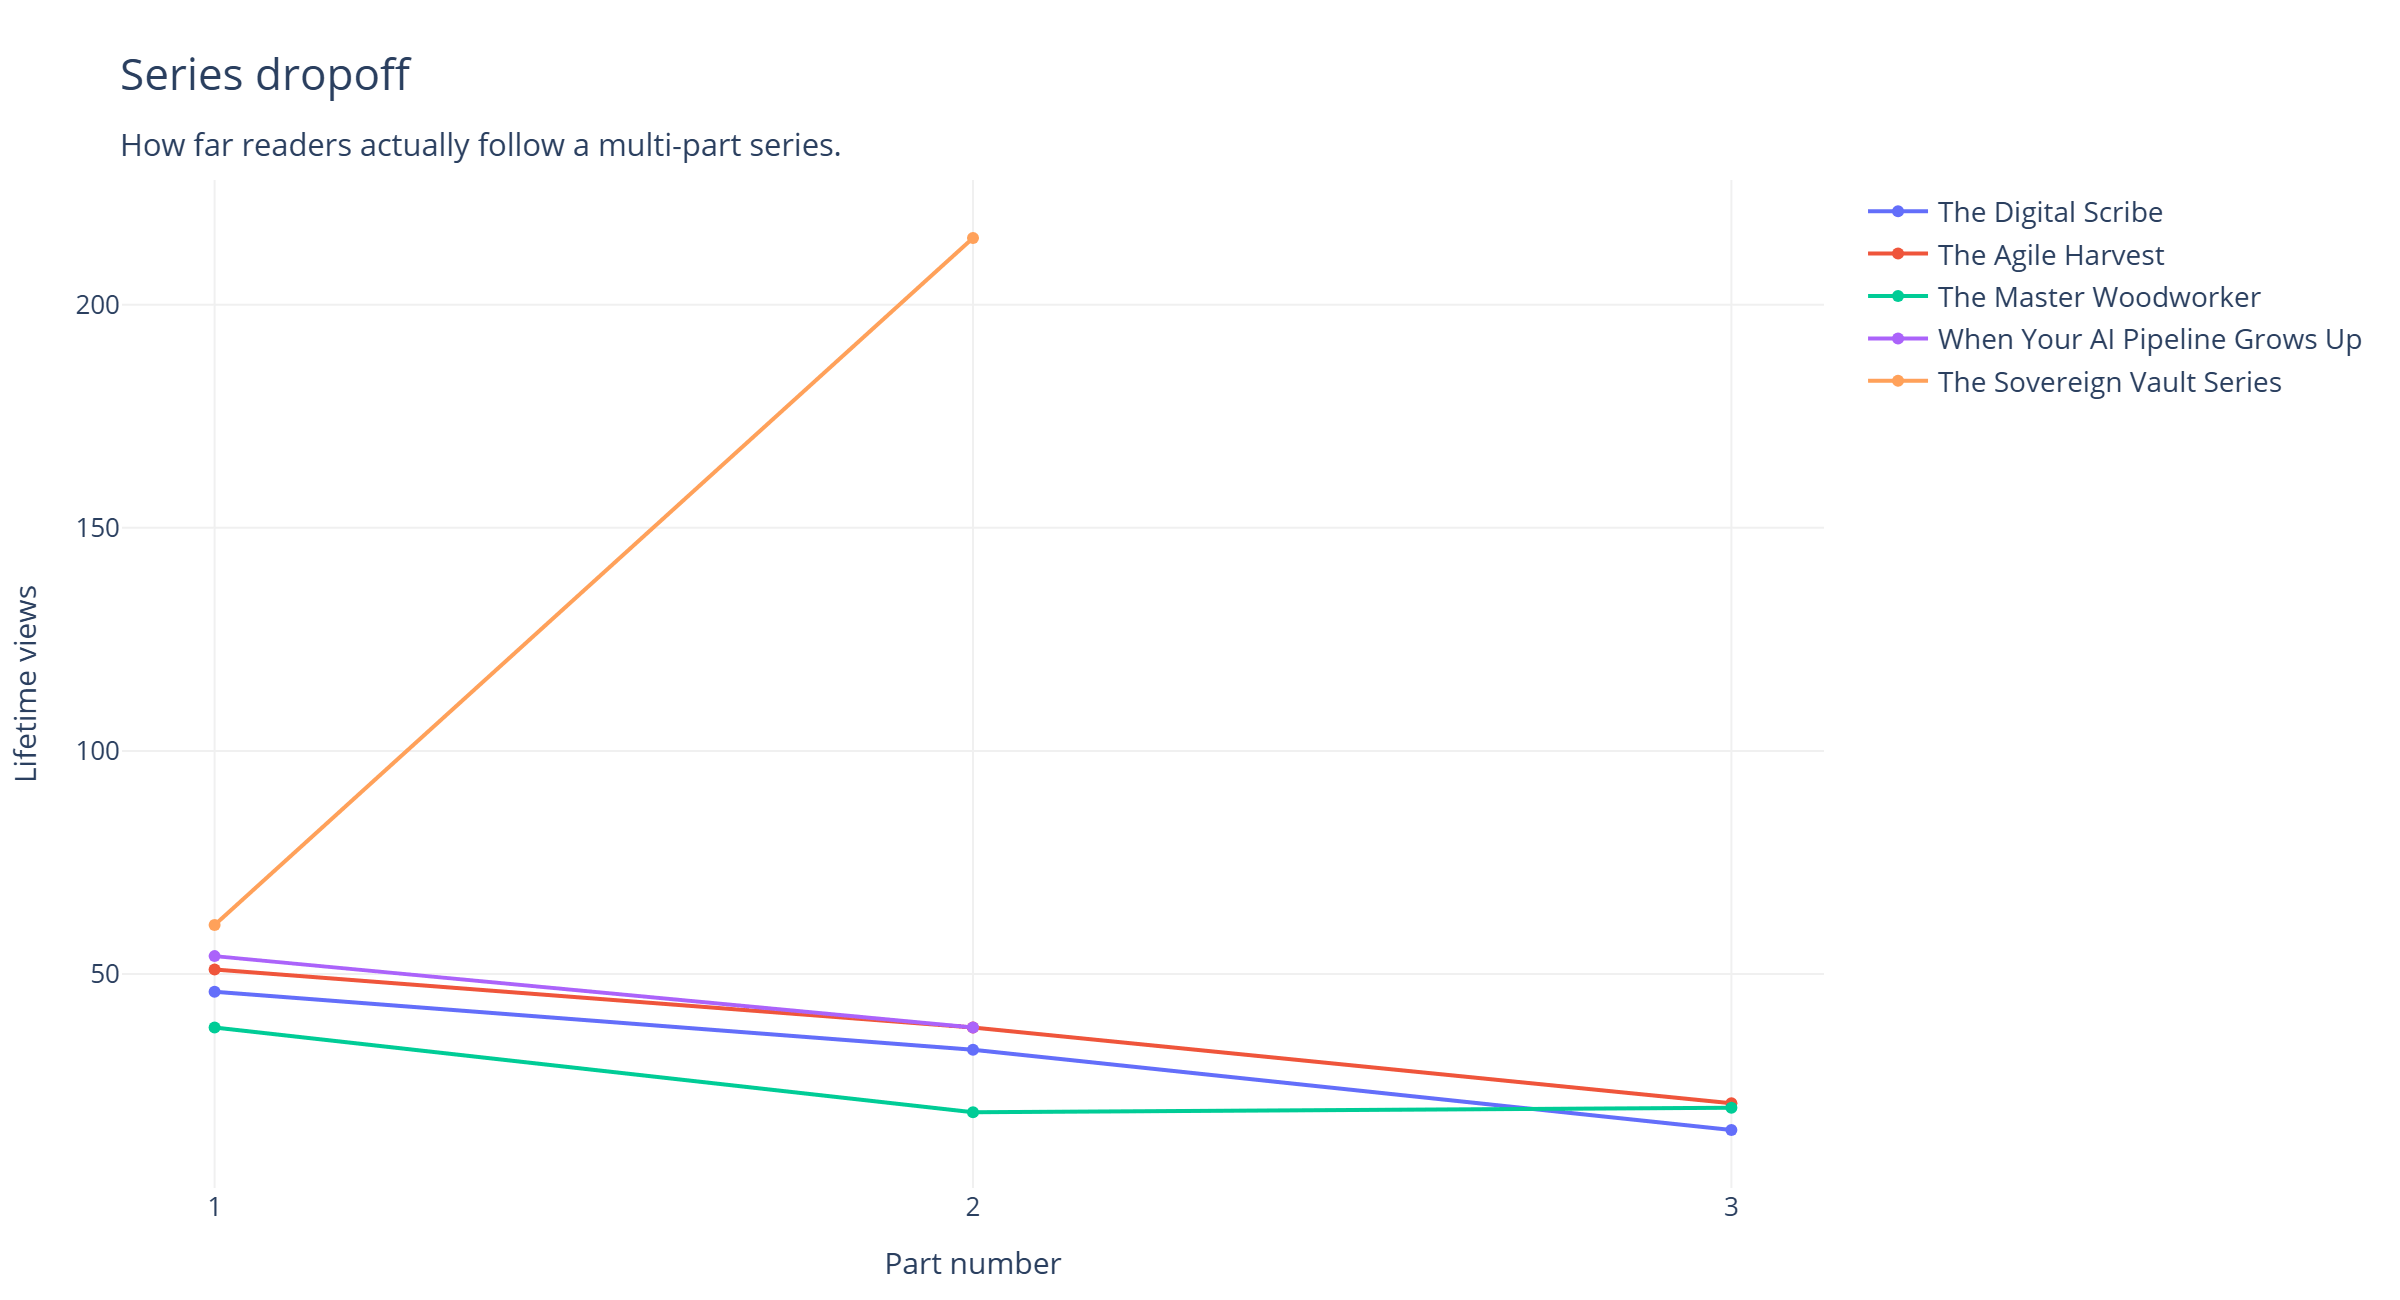
Alger는 여러 편짜리 시리즈를 쓴다. 그런데 어떤 글에서도 collection_id가 돌아오지 않았다. 시리즈를 묶으려면 당연히 찾게 되는 필드인데도 그렇다.
시리즈는 Dev.to UI에 버젓이 보인다. 글 시리얼라이저가 그 필드를 포함하지 않을 뿐이다.
대신 /api/articles/me/published는 프런트매터까지 포함한 body_markdown을 그대로 돌려준다. 시리즈 이름은 거기 들어 있다.
FRONT_MATTER_SERIES = re.compile(r"^series:\s*(.+?)\s*$", re.M)

def series_name(article):
    body = article.get("body_markdown") or ""
    if not body.lstrip().startswith("---"):
        return None
    parts = body.split("---", 2)
    if len(parts) < 3:
        return None
    match = FRONT_MATTER_SERIES.search(parts[1])
    return match.group(1).strip().strip("\"'") if match else None
여기서 챙겨갈 교훈이 하나 있다. 기대했던 필드가 JSON에 없으면 원본 문서가 같이 왔는지 확인해보자. 대개는 와 있다.
다섯 번째: 댓글은 스레드 구조로 온다 #
/api/comments?a_id={id}는 댓글을 트리 형태로 준다. 각 댓글의 답글이 children에 중첩된다. 구조 자체가 분석 작업을 대신 해주고 있는 셈이고, 깊이를 유지한 채 펼치는 데는 여덟 줄이면 충분하다.
def flatten(nodes, depth=0):
    out = []
    for node in nodes or []:
        out.append({
            "depth": depth,
            "username": (node.get("user") or {}).get("username"),
            "created_at": node.get("created_at"),
            "text": strip_html(node.get("body_html")),
        })
        out.extend(flatten(node.get("children") or [], depth + 1))
    return out
중요한 건 깊이(depth)다. 댓글 개수는 "좋은 글이네요"를 남긴 여덟 명과 네 라운드에 걸쳐 나와 논쟁한 두 명을 구분하지 못한다. 최대 스레드 깊이는 구분한다. Alger의 글 중 하나에는 35단계까지 내려간 스레드가 있다. 그건 댓글난이 아니라 긴 논쟁이고, 개수 기반 지표로는 그런 일이 벌어졌다는 사실조차 알 수 없었다.
참고로 댓글을 작성하는 엔드포인트는 없다. 답글은 여전히 브라우저에서 달아야 한다. 의도적인 설계일 가능성이 높다.
데이터가 실제로 말한 것 #
여기서부터는 프로그래밍 문제가 아니다.
팔로워 수는 독자 수가 아니다. 2026년에 팔로워가 약 1만 8천 명 늘었다. 같은 해 쓴 글들의 총 조회수는 1만 4,300회다. 조회수 1만 4천 회로 팔로워 1만 8천 명을 얻을 수는 없다. 일간 증가율은 중앙값 136명으로, 글을 썼는지 여부와 무관하게 일정했다. 사용자명의 37%가량은 자동 생성처럼 보이는 16진수나 숫자 꼬리를 달고 있었다. 맞팔 파밍이고, 만연해 있고, 그와는 아무 상관이 없다. 결국 그가 처음 만들려던 차트는 애초에 그가 던진 질문에 답할 수 없는 물건이었다.
가장 많이 읽힌 글은 9년 전 것이고, 지금은 읽히지 않는다. 2017년의 결과물은 MicroPython, NodeMCU, MongoDB 튜토리얼이었다. 2017~2019년의 44편이 3만 2,474회를 모았다. 2026년의 86편은 1만 4,300회다. 그런데 일간 시계열이 나머지 절반을 말해준다. 5,472회를 기록한 NodeMCU 글은 최근 90일간 조회수가 0이다. 130편 중 19편이 분기 조회수 0이다. 누적 카운터는 절대 줄지 않기 때문에, 숨이 멎은 지 한참 된 아카이브도 살아 있는 것처럼 보인다.
참여 지표는 완전히 뒤집힌다. 조회수가 큰 옛 튜토리얼은 조회수 1,000당 반응이 약 2회다. 2026년 에세이들은 56~72회고, 한 편은 1,000당 반응 71.6회에 댓글 63.8회를 기록했다. 시대별로 보면 옛 글 44편이 받은 댓글은 총 26개, 새 글 86편은 606개다.
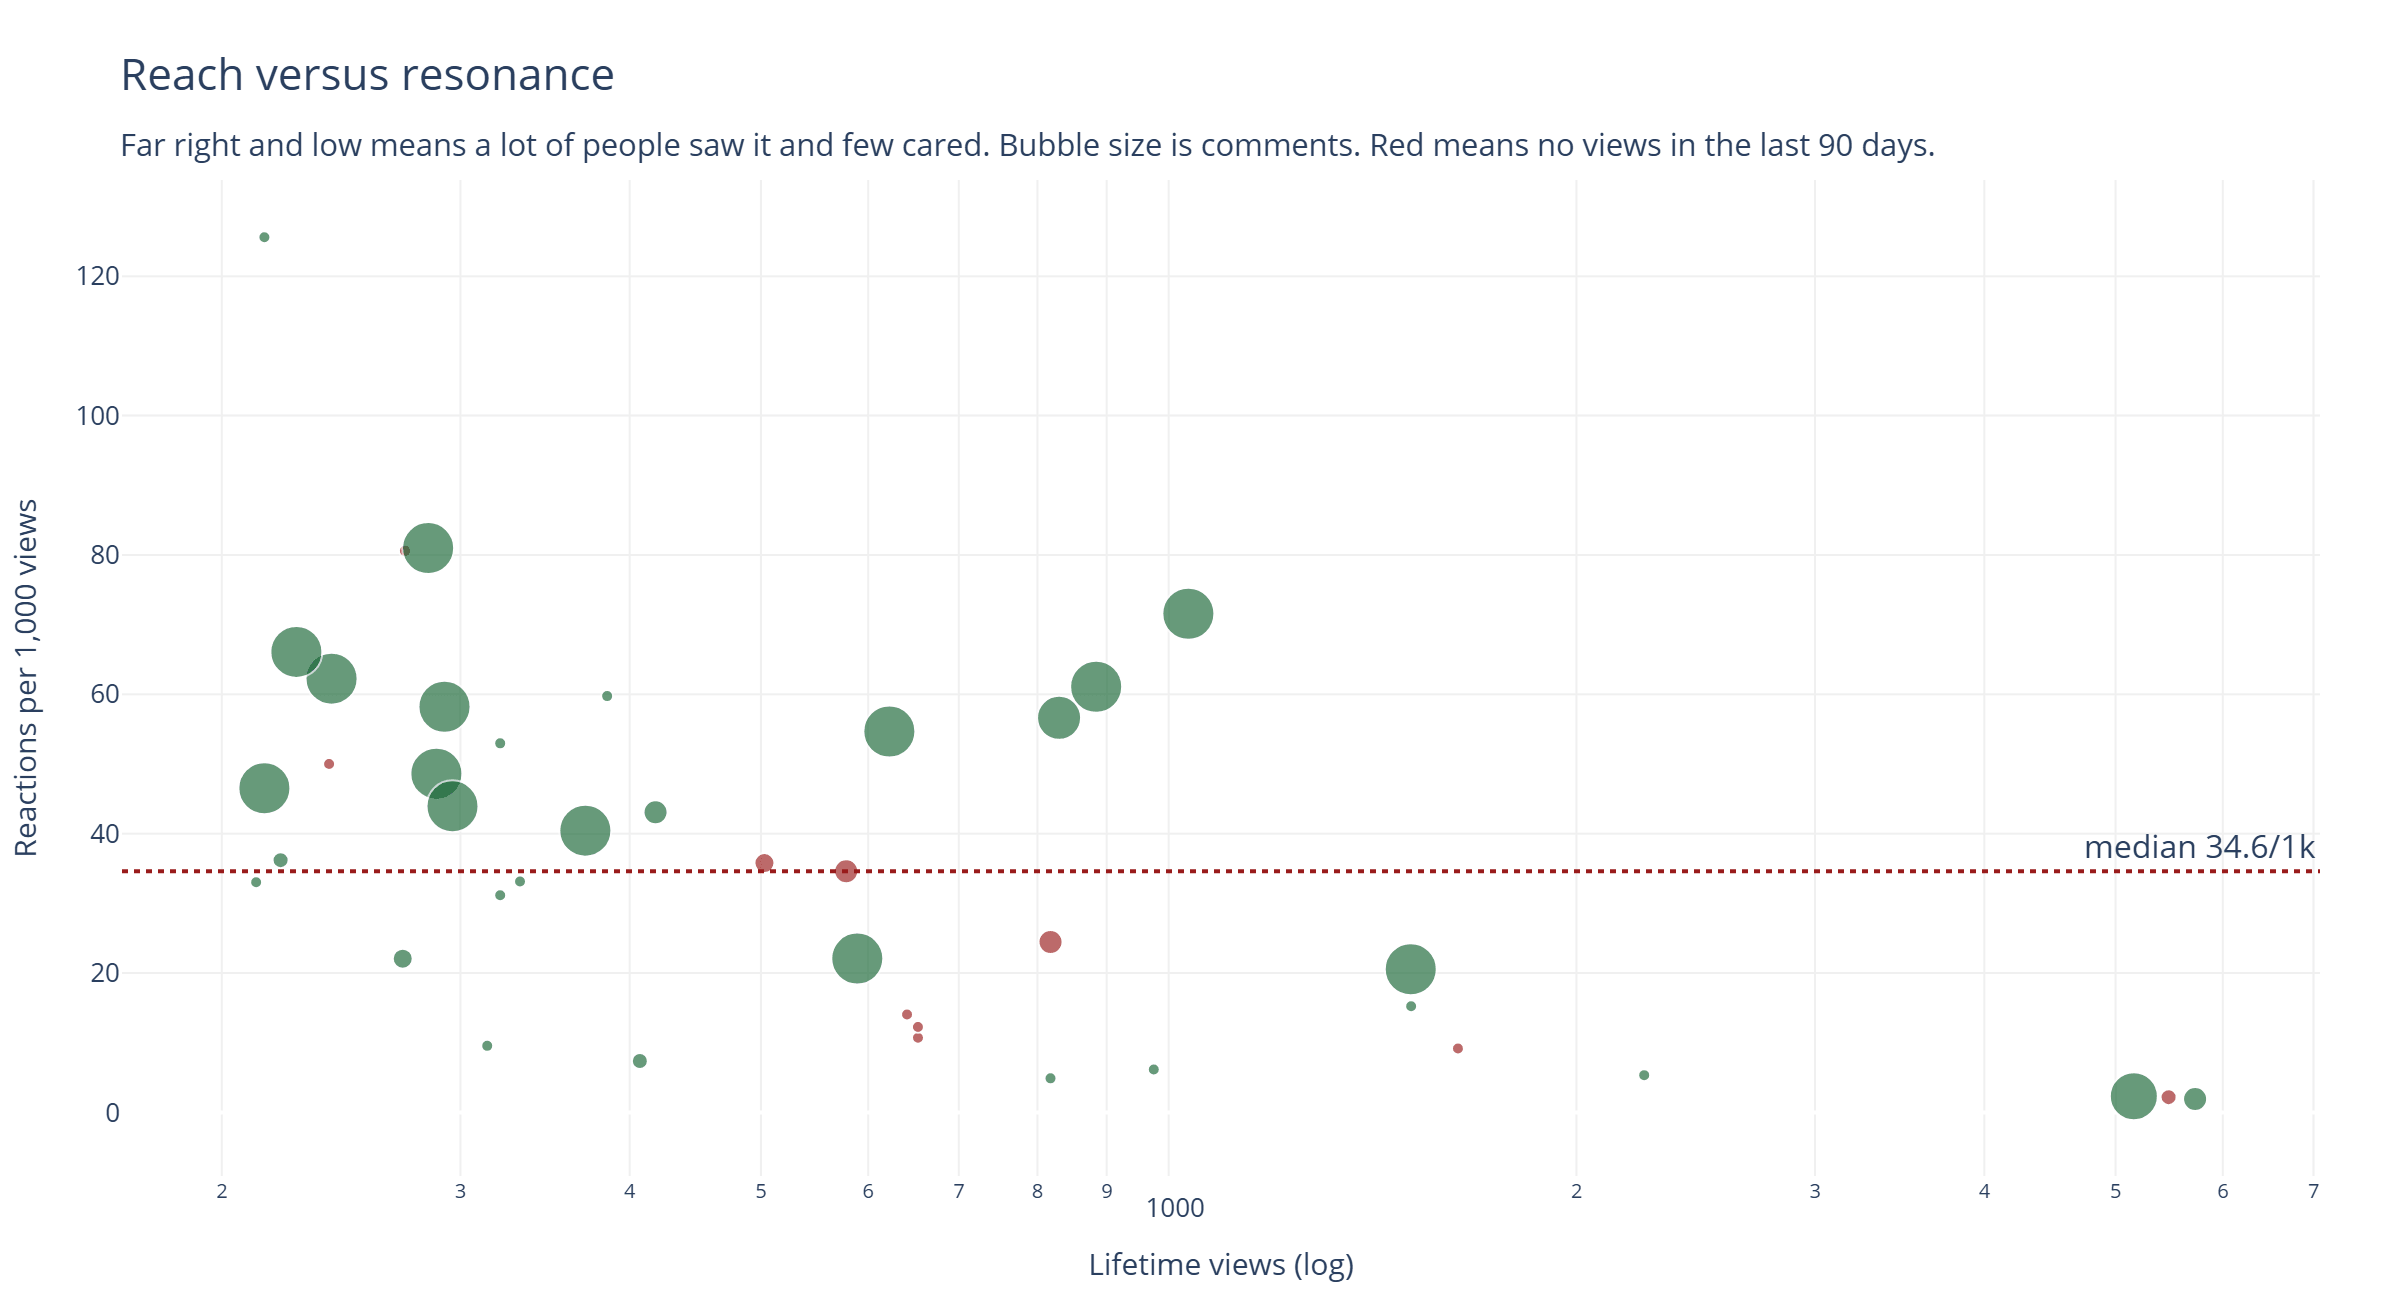
한쪽은 발견되고 훑어졌다. 다른 쪽은 읽히고 반박당한다. 서로 다른 제품인데, 그동안 같은 숫자로 평가해온 것이다.
구글 유입은 전체의 4%다. 직접 유입 또는 미상이 74.5%, Dev.to 내부가 19%였다. 가장 성적이 좋은 과거 콘텐츠가 오래 유효한 레퍼런스 문서인 사람에게, 이건 가장 보기 힘든 숫자라고 그는 적었다.
같은 걸 시작하려는 사람에게 #
팔로워는 한 번 받아서 캐시해둘 것. 기록해둘 생각조차 못 했던 수년치 역사가 그 날짜들 안에 들어 있다. 모든 분석 계산에는 데이터 커버리지 게이트를 걸 것. 불완전한 시계열은 에러 대신 자신만만한 오답을 건네준다. 댓글 개수 대신 스레드 깊이를 볼 것. 그리고 필드가 없다고 결론 내리기 전에 body_markdown을 확인할 것.
무엇보다, 유통을 재는 지표와 누군가 마음을 썼는지를 재는 지표를 분리할 것. 조회수, 팔로워 수, 노출은 앞쪽이다. 댓글 깊이, 답글률, 같은 네 사람이 내 스레드에 계속 나타난다는 사실은 뒤쪽이다.
Alger는 9년 동안 앞쪽이 점수판이라고 믿었다. API는 하룻저녁 만에 그렇지 않다고 알려줬다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.