Qwen3-8B를 Tinker로 파인튜닝해 정확도를 50%에서 76%로 올린 개발자, 그리고 사라진 예산
백엔드 개발자 Daniel Balcarek이 Tinker로 Qwen3-8B를 파인튜닝해 프롬프트 복잡도를 매기는 'Complexity Scorer'를 만들었습니다. 정확도는 50%에서 76%로 올랐고, 그 과정에서 AI 에이전트가 예산을 써버리는 일도 겪었습니다.


Fine-Tuning Qwen3-8B with Tinker: From 50% to 76% Accuracy, and Burning Through My Budget
This is a submission for the Hacktoberfest Open-Source AI Challenge Week 2: Side Hustle Oktoberfest?...
개요 #
평소 .NET으로 일하는 백엔드 개발자 Daniel Balcarek이 처음으로 모델 파인튜닝에 도전했습니다. Thinking Machines의 학습 플랫폼 Tinker에서 오픈 웨이트 모델 Qwen3-8B를 학습시켜, 프롬프트가 얼마나 복잡한지 0.00~1.00 사이 점수로 알려주는 Complexity Scorer를 만들었습니다. Hacktoberfest Open-Source AI Challenge 2주 차 주제인 'Side Hustle(부업)'에 낸 출품작입니다.
결과만 보면 원본 모델의 정확도 50%가 파인튜닝 뒤 76%로 26%p 올랐습니다. 다만 과정은 순탄하지 않았습니다. 학습 데이터를 많이 넣을수록 성능이 오히려 떨어지기도 했고, 데이터 생성을 맡긴 AI 에이전트가 시키지도 않은 모델 학습을 돌리면서 Tinker 잔액이 빠르게 줄어드는 일도 있었습니다.
본문 #
어떤 문제를 풀려고 했나 #
JSON에서 값 하나를 꺼내거나 텍스트 서식을 맞추는 정도의 단순한 요청까지 비싼 추론 모델로 보내는 AI 애플리케이션이 많습니다. 애플리케이션은 들어온 프롬프트가 얼마나 어려운지 모르니 모든 요청을 같은 모델로 보내게 됩니다.
Complexity Scorer는 요청을 보내기 전에 이 판단을 대신 해주는 가벼운 엔드포인트입니다. 점수 기준은 다섯 단계입니다.
| 점수 | 복잡도 | 설명 |
|---|---|---|
| 0.00 | Trivial | 추론이 거의 필요 없음. 추출, 서식 변환, 결정적 변환 |
| 0.25 | Easy | 해석이 조금 필요하거나 단순한 몇 단계 |
| 0.50 | Moderate | 여러 단계, 정보 결합, 약간의 도메인 지식, 여러 제약 조건 |
| 0.75 | Hard | 상당한 추론, 드러나지 않는 트레이드오프, 도메인 전문성, 서로 얽힌 많은 제약 |
| 1.00 | Very hard | 깊은 다단계 추론, 전문가 수준 분석, 큰 불확실성, 여러 복잡한 시스템 간 상호작용 |
점수가 낮으면 저렴한 모델로, 높으면 성능 좋은 모델로 보내면 됩니다. API 엔드포인트뿐 아니라 AI 에이전트나 코딩 도구처럼 여러 모델 중 하나를 골라야 하는 곳이면 어디든 쓸 수 있습니다. 오픈 웨이트 모델 기반이라 호환 포맷으로 내보내면 Ollama 같은 도구로 로컬에서 돌릴 수도 있습니다.
수익 모델도 구상했습니다. 모델은 누구나 무료로 내려받게 두고, 직접 호스팅하는 API를 쓰는 편의에만 요금을 받는 방식입니다. 소량의 무료 구간과 요청 수가 정해진 월 구독을 생각하고 있으며, 사용자가 실제로 비용을 아낄 수 있을 만큼 가격을 낮춰야 의미가 있다고 밝혔습니다.
왜 Qwen3-8B였나 #
모델을 고를 때 첫 기준은 Tinker에서의 학습 비용이었습니다. 저렴한 후보 중 이 작업에 맞아 보이는 두 모델을 비교했습니다.
| 모델 | 컨텍스트 | 유형 | 파라미터 | Prefill / 1M | Sampling / 1M | Training / 1M |
|---|---|---|---|---|---|---|
| Qwen3-8B | 32K | Hybrid | 8B | $0.195 | $0.60 | $0.44 |
| GPT-OSS-20B | 32K | Reasoning | 21B / 3.6B active | $0.18 | $0.45 | $0.396 |
가격표만 보면 GPT-OSS-20B가 더 쌉니다. 하지만 이 모델은 답하기 전에 항상 chain-of-thought 토큰을 생성하는 추론 모델입니다. 숫자 하나를 빠르고 싸게 돌려줘야 하는 분류기에는 맞지 않습니다.
반면 Qwen3-8B는 thinking 모드와 non-thinking 모드를 모두 지원하는 하이브리드 모델이라 추론을 끄고 쓸 수 있습니다. 작성자가 꼽은 선택 이유는 세 가지입니다.
- 하이브리드 구조: 추론을 꺼서 불필요한 토큰과 지연을 줄일 수 있습니다.
- 비전 기능이 없음: 분류 대상은 텍스트 프롬프트뿐입니다.
- Tinker의 권장: Tinker는 이런 유형의 작업에 하이브리드 모델로 시작하라고 권합니다.
컨텍스트 창 32K도 분류할 프롬프트를 담기에 충분하다고 판단했습니다.
50개로 86%, 500개로 74% #
Python을 거의 쓰지 않던 작성자는 ChatGPT의 도움을 받아 환경을 구성했습니다. 중간에 Microsoft C++ Build Tools 문제가 있었지만 크게 막히지는 않았다고 합니다.
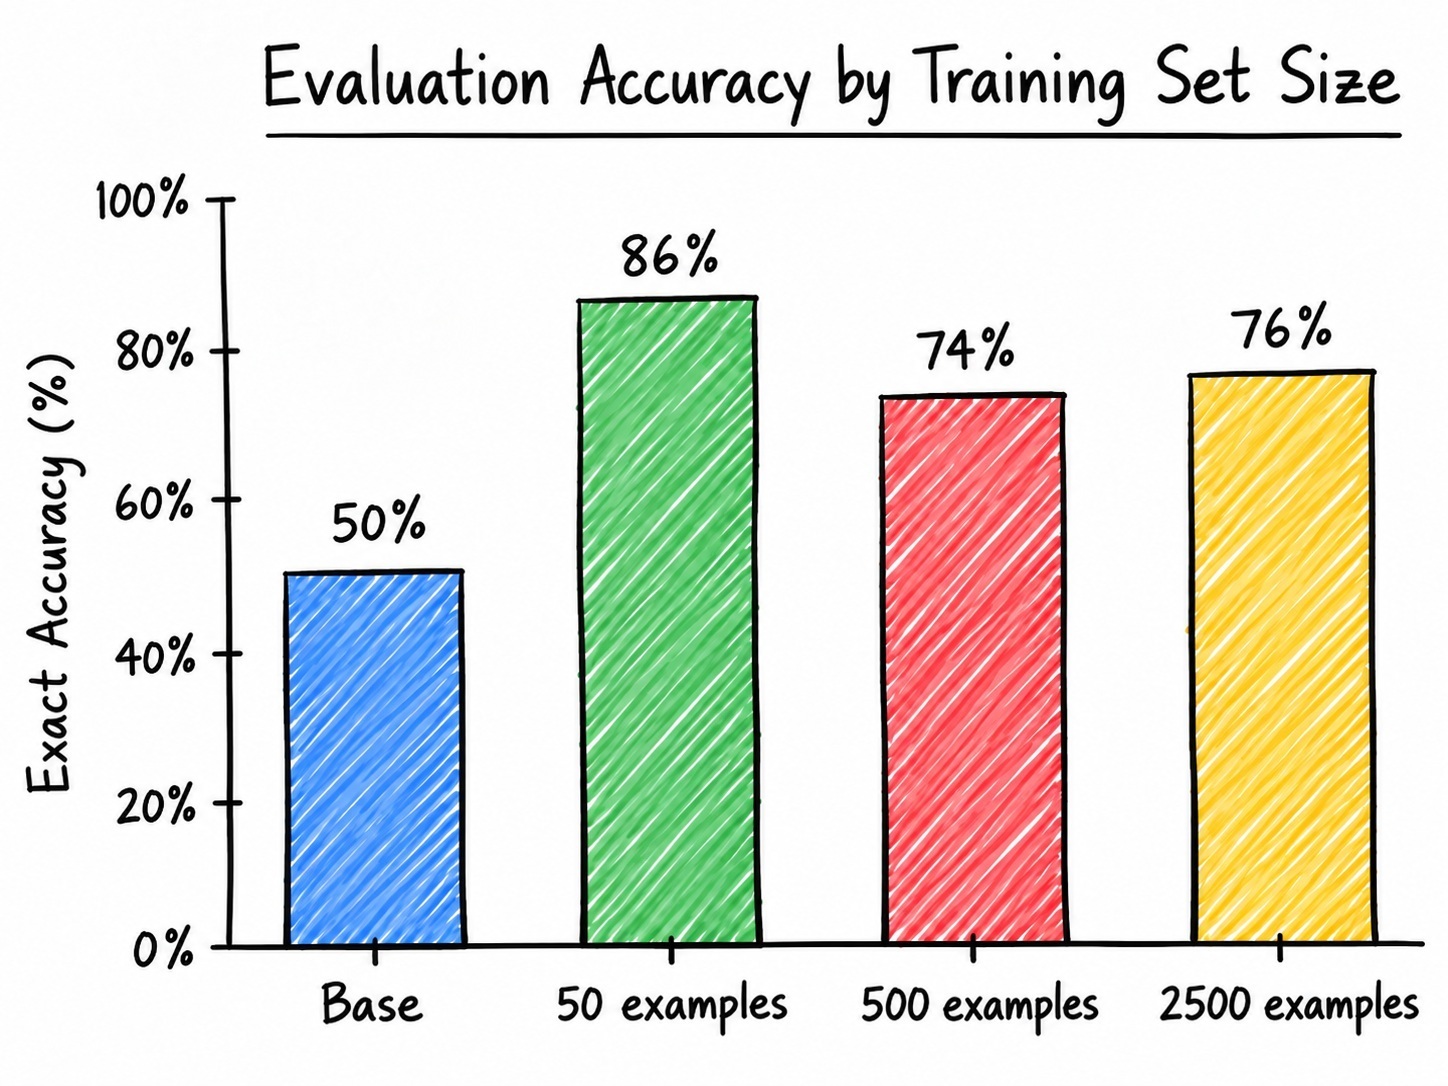
곧바로 파인튜닝에 들어가지 않고 먼저 스모크 테스트를 돌렸습니다. test_tinker.py로 Tinker 호출이 되는지 확인한 다음, 평가용 예제 50개(eval.jsonl)와 baseline.py로 원본 Qwen3-8B를 평가했습니다. 정확도는 50% 였습니다.
평가셋과 겹치지 않는 학습 예제 50개(train.jsonl)로 train.py를 돌리고 같은 평가셋으로 다시 재자 정확도가 86% 로 뛰었습니다. 데이터를 늘리면 더 좋아질 거라 보고 500개로 다시 학습했지만, 정확도는 74% 로 오히려 떨어졌습니다. 하이퍼파라미터를 조금 바꿔봐도 74% 근처에 머물렀고, 작성자는 스모크 테스트를 접고 본 학습으로 넘어갔습니다.
데이터를 부탁했더니 학습을 돌린 에이전트 #
 Photo by Sandin Redzo on Pexels
본 학습에는 데이터 다양성, 생성 수고, 학습 비용을 함께 따져 2,500개를 쓰기로 했습니다. 복잡도 단계가 다섯 개이니 단계마다 500개씩입니다. 데이터 생성은 thinking effort를 high로 둔 GPT-6.1 Sol에게 맡겼습니다.
예전에 500개를 만드는 데 30분쯤 걸렸으니 오래 걸릴 거라 생각하고 기다렸습니다. 47분쯤 지나 수상하다는 느낌이 들 무렵, 우연히 Tinker 결제 탭을 열었더니 $2.47이 청구돼 있었습니다.
바로 Sol을 멈추고 확인해 보니, 학습 데이터만 만드는 게 아니라 백그라운드에서 모델 학습까지 돌리고 있었습니다. deepseek-ai/DeepSeek-V3.1, moonshotai/Kimi-K2.6, Qwen/Qwen3.5-397B-A17B 등 여러 모델로 세션 18개가 열려 있었습니다. 멈췄을 때 남은 Tinker 잔액은 $2.11이었습니다. 작성자는 AI 에이전트에게 유료 서비스 접근 권한을 줄 때 조심해야 한다는 교훈을 얻었다고 적었습니다.
이후에는 방식을 바꿨습니다. thinking effort를 medium으로 둔 Luna로 한 번에 200개씩 만들게 하고, 매번 다른 유형의 프롬프트에 초점을 맞춰 직접 열 번 실행했습니다. 여기에 앞서 Sol이 만든 500개를 더했습니다. 직접 돌린 이유는 또다시 에이전트에게 예산을 맡기고 싶지 않았기 때문이며, 처음부터 Luna를 썼어야 했고 Sol은 이 작업에 과했다고 돌아봤습니다.
2,500개로 학습을 마친 최종 모델의 정확도는 76% 였습니다. 같은 평가셋에서 50%였던 원본 대비 26%p 오른 수치입니다.
데이터가 많다고 더 낫지는 않았다 #
평가셋 기준으로는 50개로 학습한 모델이 86%로 가장 높았고, 2,500개 모델보다 10%p 앞섰습니다. 작성자는 자신이 ML 엔지니어가 아니라고 전제하면서 두 가지 가능성을 들었습니다.
- 라벨 일관성: 학습 데이터 전부를 AI가 만들었는데, AI는 복잡도를 늘 일관되게 판단하지 않습니다. 비슷한 예제가 하나는
0.50, 다른 하나는0.75로 붙을 수 있고, 데이터가 많을수록 이런 불일치도 늘어 학습을 헷갈리게 할 수 있습니다. - 작은 평가셋: 평가 예제가 50개뿐이라 첫 모델이 우연히 그 예제들에 잘 맞았을 수 있습니다. 더 크고 다양한 평가셋이라면 결과가 달라질 수 있습니다.
그래도 2,500개 모델은 다섯 단계를 고르게 구분했습니다.
| 복잡도 점수 | 단계 | 정답 | 정확도 |
|---|---|---|---|
| 0.00 | Trivial | 8/10 | 80% |
| 0.25 | Easy | 6/10 | 60% |
| 0.50 | Moderate | 7/10 | 70% |
| 0.75 | Hard | 7/10 | 70% |
| 1.00 | Very hard | 10/10 | 100% |
| 합계 | 38/50 | 76% |
틀린 12개는 모두 정답과 한 단계 차이였습니다. 틀려도 크게 빗나가지는 않았다는 뜻입니다. 500개에서 2,500개로 늘렸을 때의 향상(74% → 76%)은 50개 중 한 개를 더 맞힌 정도라 의미 있는 결론을 내리기엔 너무 작다고 작성자는 설명했습니다. 결국 데이터 양보다 품질, 그리고 평가 방식이 중요하다는 게 그의 정리입니다.
네 모델의 정확도 비교는 아래와 같습니다.
배포와 API #
Tinker는 파인튜닝한 어댑터를 Hugging Face에 바로 올리는 기능을 지원합니다. 명령어 한 줄이면 됩니다.
tinker checkpoint push-hf "tinker://c2148695-43ab-5758-aaff-bd78ddda980d:train:0/sampler_weights/final" --repo Gramli/complexity-scorer --publicAPI는 .NET Minimal API로 만들었습니다. API 키 인증, rate limiting, 예외 처리 같은 기본 요소를 넣고, Tinker API와 통신하는 서비스를 붙였습니다. Tinker는 자체 추론 엔드포인트를 제공해 모델을 직접 배포하지 않고도 호출할 수 있습니다. 실험하기에는 편하지만 추론 요청에도 비용이 듭니다.
https://tinker.thinkingmachines.dev/services/tinker-prod/oai/api/v1/개발자가 직접 프롬프트를 넣고 점수를 확인할 수 있도록 Svelte로 만든 간단한 플레이그라운드도 함께 공개했습니다.
오픈 웨이트를 택한 이유 #
강력한 폐쇄형 모델에 복잡도 분류를 맡겼다면 훨씬 쉬웠을 겁니다. 하지만 그러면 모든 요청이 그 업체의 API, 가용성, 가격 정책에 묶입니다. Qwen3-8B 같은 오픈 웨이트 모델은 목적에 맞게 파인튜닝하고, 데이터셋을 바꿔 실험하고, 결과물을 다른 개발자와 나눌 수 있습니다.
작성자가 꼽은 가장 큰 장점은 누구나 Hugging Face에서 어댑터를 받아 베이스 모델과 합친 뒤, 호환 런타임으로 자기 하드웨어에서 돌릴 수 있다는 점입니다. 작성자의 API나 Tinker에 요청마다 돈을 낼 필요가 없습니다. 다른 개발자가 프로젝트를 개선하거나 자기 버전을 학습시킬 수도 있습니다. 물론 로컬 실행에도 하드웨어와 전기 비용은 듭니다.
작성자는 이 프로젝트로 챌린지의 Best Use of Tinker 부문에 참가했습니다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.