제미나이 3.8 Live와 3.5 Transcribe로 실시간 음성 앱 만들기
구글이 Gemini API와 AI Studio에 새 실시간 음성 모델을 추가했다. 대화를 이어가면서 작업까지 처리하는 3.8 Live, 85개 언어를 단어 오류율 4.0%로 받아쓰는 3.5 Transcribe가 핵심이다.

Build real-time voice applications with Gemini 3.8 Live and 3.5 Transcribe
Yesterday, we released new Gemini Live models in the Gemini API and Google AI Studio, expanding our...
개요 #
구글이 Gemini API와 Google AI Studio에 새 Gemini Live 모델을 공개했다. 음성을 우선으로 하는 실시간 제품을 만드는 개발자를 겨냥한 라인업이다.
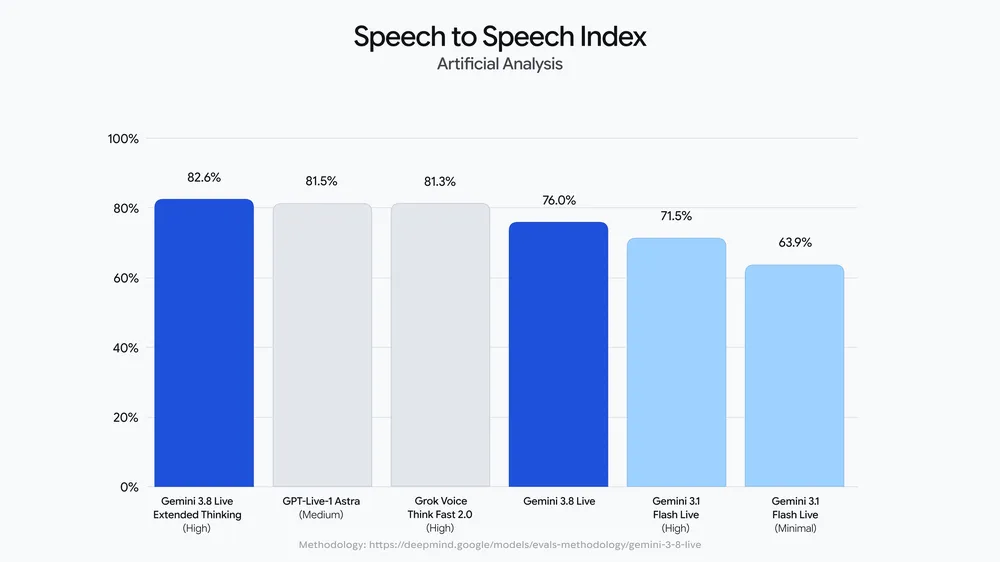
이번에 추가된 모델은 세 갈래다. Gemini 3.8 Live는 대화 흐름을 끊지 않으면서 작업을 처리하는 네이티브 음성-음성 모델이고, 3.8 Live Extended Thinking은 복잡한 요청에 더 깊은 추론을 붙인 버전이다. 후자는 Artificial Analysis의 Speech-to-Speech 리더보드에서 1위에 올랐다.
받아쓰기 전용 모델 Gemini 3.5 Transcribe도 함께 묶였다. 지난달 나온 이 모델은 85개 이상의 언어를 지원하며, 평균 단어 오류율(WER)이 스트리밍 4.0%, 비스트리밍 2.6%를 기록했다.
Gemini 3.8 Live, 대화하면서 일하는 음성 에이전트 #
기존 음성 모델과 3.8 Live를 가르는 지점은 "말하는 동안 다른 일을 할 수 있는가"다. 구글이 내세운 주요 기능은 다음과 같다.
- 비동기 함수 호출: 사용자에게 음성 응답을 계속 스트리밍하면서 백그라운드에서 API·툴 호출을 실행한다
- 시각 맥락: 실시간 영상 입력을 대화에 연결해, 사용자가 말하는 내용과 보는 화면을 함께 이해하는 에이전트를 만들 수 있다
- 영숫자 정확도: 확인 코드, 청구 번호, 기술 데이터 같은 문자열을 정확히 받아낸다
- 다국어: 97개 이상 언어를 지원하고 억양 일관성을 유지한다
- 점진적 콘텐츠 갱신: 실시간 오디오와 구조화된 데이터를 매끄럽게 합쳐 맥락에 맞는 응답을 낸다
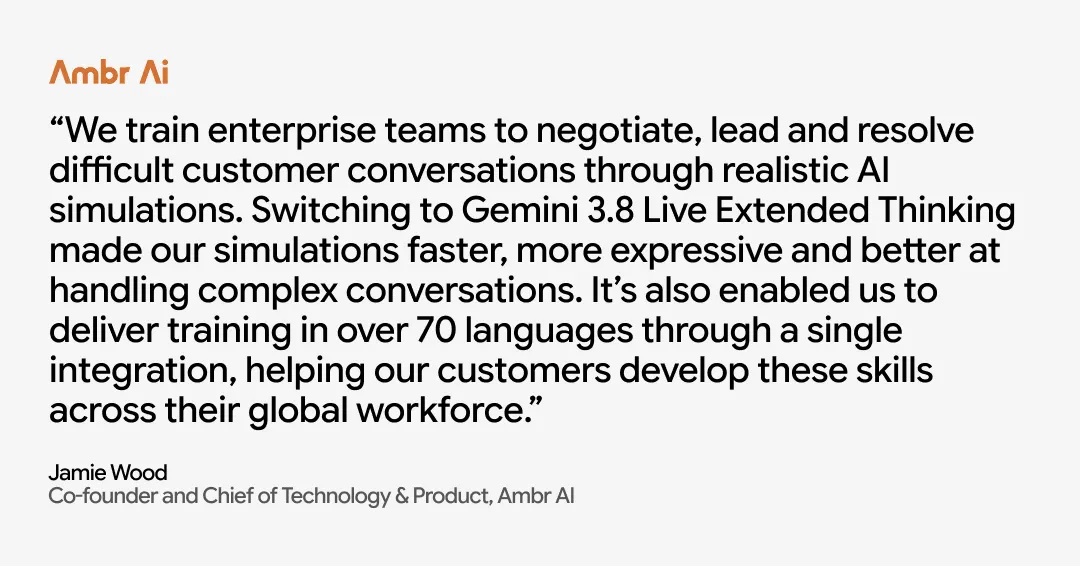
3.8 Live Extended Thinking은 여기에 설정 가능한 사고(configurable thinking)를 더했다. 여러 단계를 거쳐야 하는 추론을 백그라운드에서 처리하면서, 본 대화에서는 응답하거나 진행 상황을 설명한다. 구글은 이 모델들이 이전 라이브 모델에서 한 단계 도약한 결과이며, 여러 모델을 직렬로 잇는 캐스케이드 구조보다 간결한 대안이라고 설명했다.
두 모델 모두 Live API로 쓸 수 있다. 가격은 오디오 입력 분당 0.005달러, 오디오 출력 분당 0.018달러다.
직접 붙이는 대신 파트너 플랫폼을 거칠 수도 있다. Agora, Fishjam, LangChain, LiveKit, Pipecat, Vercel, Vision Agents가 Live API 통합 파트너로 이름을 올렸다. 실제 배포에서 골치 아픈 미디어 스트리밍 인프라를 이들이 맡는다.
Gemini 3.5 Transcribe, 흘러가는 음성을 텍스트로 #
음성 우선 인터페이스에서 실시간 음성 이해는 빠질 수 없는 조각이다. 지난달 공개된 3.5 Transcribe는 지연을 낮추면서 정확도를 끌어올린 받아쓰기 모델로, WER 4.0%를 기록했다. 딸려 오는 기능도 실용적이다.
- 자동 코드 스위칭: 문장 안팎에서 언어가 바뀌어도 별도 설정 없이 처리한다
- 커스텀 어휘 편향:
custom_vocabulary목록에 최대 1,000개 용어를 넘겨 도메인 전문 용어, 흔치 않은 은어, 회사명, 고유명사 쪽으로 인식을 유도한다 - 스마트 전사 모드: 구조화된 서식, 자기 수정, 군더더기 제거를 적용해 바로 읽을 수 있는 정돈된 전사본을 뽑는다
85개 이상 언어를 지원하고, 1초 미만 자막 생성이나 콜센터 상담, 실시간 오디오 분석처럼 상태를 유지하지 않는 작업에 잘 맞는다. Interactions API로는 최대 1시간 길이 오디오 파일을 구조화된 타임스탬프와 화자 라벨과 함께 전사할 수 있다. 자세한 내용은 개발자 가이드에 정리돼 있다.
구글이 갖춘 오디오 모델 전체 구성 #
먼저 만져보려면 ai.studio/live에서 모델을 시험하거나, GitHub의 예제 앱을 클론하면 된다. 에이전트에 Live API 스킬을 붙이는 방법도 있다.
Gemini API에서 쓸 수 있는 나머지 음성·음악 모델은 이렇다.
- Gemini 3.5 Live Translate: 70개 이상 언어 간 음성-음성 번역
- Gemini 3.1 Flash TTS: 세밀하게 설정 가능한 음성 생성(추가 업데이트 예정)
- Lyria 3.5: 프로덕션 수준 음악 생성
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.