AI는 실제로 어떻게 API를 호출하는가 — Tool Calling의 원리
모델이 직접 코드를 실행하는 게 아니라 '호출 요청서'를 넘길 뿐이라는 점에서 Tool Calling이 시작된다. Amazon Bedrock Converse API 예제로 4단계 루프와 컨텍스트 주입, 그리고 MCP로 이어지는 흐름을 정리했다.

How AI Actually Calls an API? Tool Calling Explained from Scratch
In the previous post, we taught a model to read our documents. It could search a pile of files and...
개요 #
파운데이션 모델은 학습 시점에 갇혀 있다. 문서를 검색해 답하는 RAG를 붙여도 "지금 비 오나?", "오늘 실시간 가격이 얼마야?", 심지어 "오늘 며칠이야?" 같은 질문에는 답하지 못한다. 상자 밖을 볼 창이 없기 때문이다.
AWS 커뮤니티에 올라온 Rohini Gaonkar의 글은 그 창에 해당하는 Tool Calling을 처음부터 짚는다. 도구 하나를 쥐여준 뒤 모델이 실시간 데이터를 가져오는 과정을 보여주고, 도구를 둘로 늘리면 코드 구조가 어떻게 바뀌는지, 그리고 모델에게 없는 사실을 건네는 두 가지 방식이 어떻게 갈리는지까지 이어진다. 예제 코드는 저자의 GitHub 저장소 ep07-tool-calling 폴더에 있다.
모델이 코드를 실행하는 게 아니다 #
"모델이 도구를 호출한다"는 말은 오해를 부른다. 모델이 직접 손을 뻗어 코드를 돌리는 그림을 떠올리게 되지만, 실제로 벌어지는 일은 다르다.
모델은 아무것도 실행하지 않는다. 실행할 능력 자체가 없다. 여전히 프롬프트를 읽고 텍스트를 만들어낼 뿐이다. 모델이 내놓는 건 "이 도구를 이런 입력으로 호출하고 싶다"는 구조화된 요청서다.
모델은 쪽지를 건네고, 그 쪽지를 읽어 실제 도구를 돌리는 쪽은 개발자가 작성한 코드다. 코드는 결과를 다시 모델에게 넘기고, 모델은 그걸 보고 답을 쓰거나 다음 도구를 요청한다.
판단은 모델이 하고, 손은 코드가 된다.
네 단계 루프 #
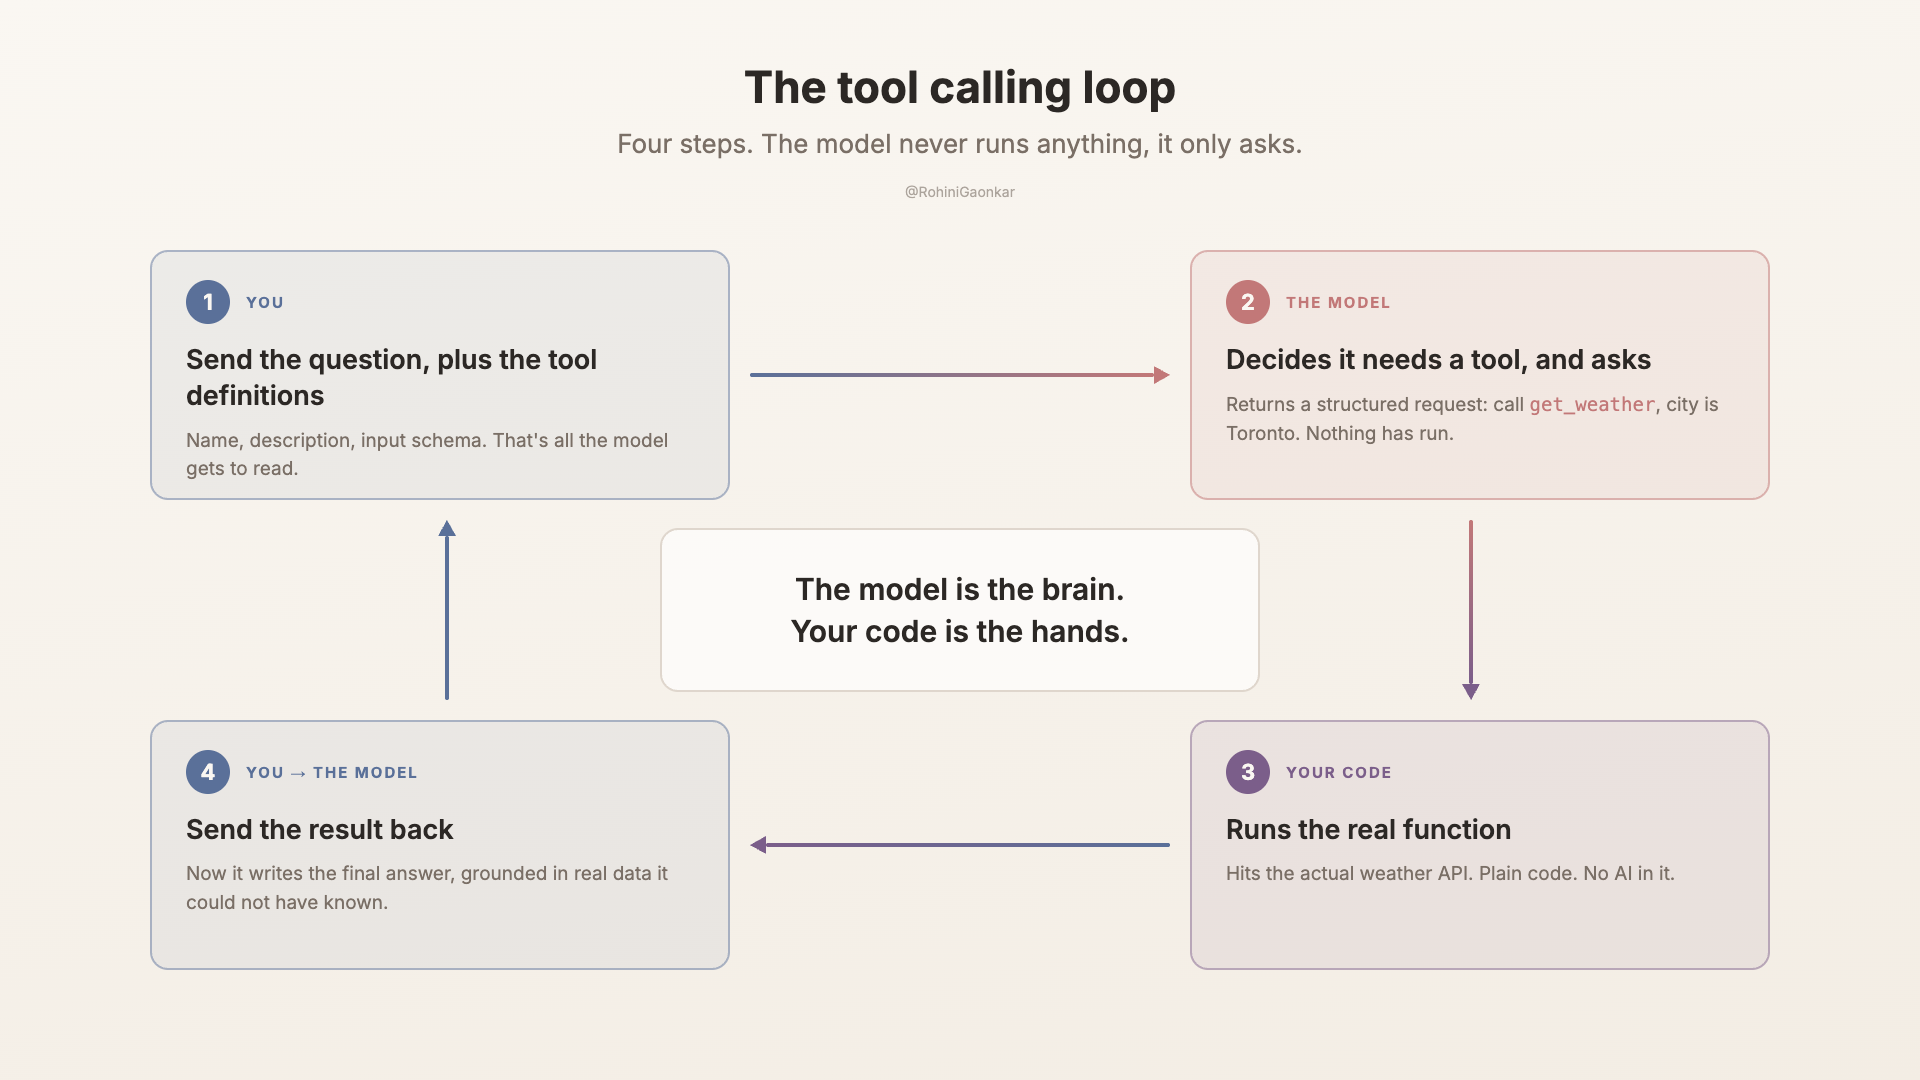
매번 반복되는 과정은 네 단계다.
- 질문과 함께, 모델이 쓸 수 있는 도구 설명을 보낸다.
- 모델이 판단한다. 내가 직접 답할 수 있는가, 도구가 필요한가. 도구가 필요하면
get_weather를 호출해, city는 Toronto같은 구조화된 요청을 돌려준다. - 코드가 그 요청을 받아 실제 함수를 돌린다. 날씨 API를 때리는 그 함수다.
- 결과를 모델에게 돌려보낸다. 이제 모델은 혼자서는 절대 알 수 없었던 실제 데이터에 근거해 최종 답을 쓴다.
 Photo by
도구를 설명하는 법 #
글에서는 Amazon Bedrock의 Converse API로 Claude 모델을 호출한다. Converse에는 도구를 위한 자리가 toolConfig라는 이름으로 마련되어 있다.
response = bedrock.converse(
    modelId=MODEL,
    messages=messages,
    toolConfig={"tools": [WEATHER_TOOL]},
    inferenceConfig={"maxTokens": 2048},
    additionalModelRequestFields=THINKING,
)
가장 단순한 도구부터 시작한다. 날씨 조회다. 도구 하나를 모델에게 설명하는 데 필요한 건 세 가지다. 이름, 평범한 문장으로 쓴 설명, 그리고 인자의 입력 스키마.
WEATHER_TOOL = {
    "toolSpec": {
        "name": "get_weather",
        "description": "Get the current weather for a single city.",
        "inputSchema": {
            "json": {
                "type": "object",
                "properties": {
                    "city": {
                        "type": "string",
                        "description": "A plain city name, e.g. Toronto or Paris.",
                    }
                },
                "required": ["city"],
            }
        },
    }
}
모델이 이 도구를 언제, 어떻게 쓸지 정할 때 읽는 건 이 설명과 스키마뿐이다. 저자는 그래서 도구 설명을 프롬프트처럼 다루라고 못 박는다.
도구 설명은 곧 프롬프트다.
실제 일을 하는 함수는 따로 있다.
import requests

# Open-Meteo returns a numeric weather_code; map the ones we need to plain words.
WEATHER_CODES = {0: "clear sky", 2: "partly cloudy", 3: "overcast", 61: "light rain", 63: "moderate rain"}

def get_weather(city: str) -> dict:
    geo = requests.get(
        "https://geocoding-api.open-meteo.com/v1/search",
        params={"name": city, "count": 1},
    ).json()["results"][0]
    now = requests.get(
        "https://api.open-meteo.com/v1/forecast",
        params={
            "latitude": geo["latitude"],
            "longitude": geo["longitude"],
            "current": "temperature_2m,weather_code,wind_speed_10m",
        },
    ).json()["current"]
    return {
        "city": geo["name"],
        "country": geo["country"],
        "temperature_c": now["temperature_2m"],
        "conditions": WEATHER_CODES.get(now["weather_code"], "unknown"),
        "wind_kph": now["wind_speed_10m"],
    }
여기에 AI는 한 줄도 없다. 키 없이 쓸 수 있는 무료 날씨 API Open-Meteo를 호출하는 평범한 코드다.
도구 하나: 직선으로 끝난다 #
질문은 이렇다. "오늘 토론토에서 우산이 필요할까?"
이 질문을 get_weather 정의와 함께 보내면 모델은 stopReason을 tool_use로 멈추고 요청서를 돌려준다.
{
  "toolUse": {
    "toolUseId": "tooluse_abc123",
    "name": "get_weather",
    "input": { "city": "Toronto" }
  }
}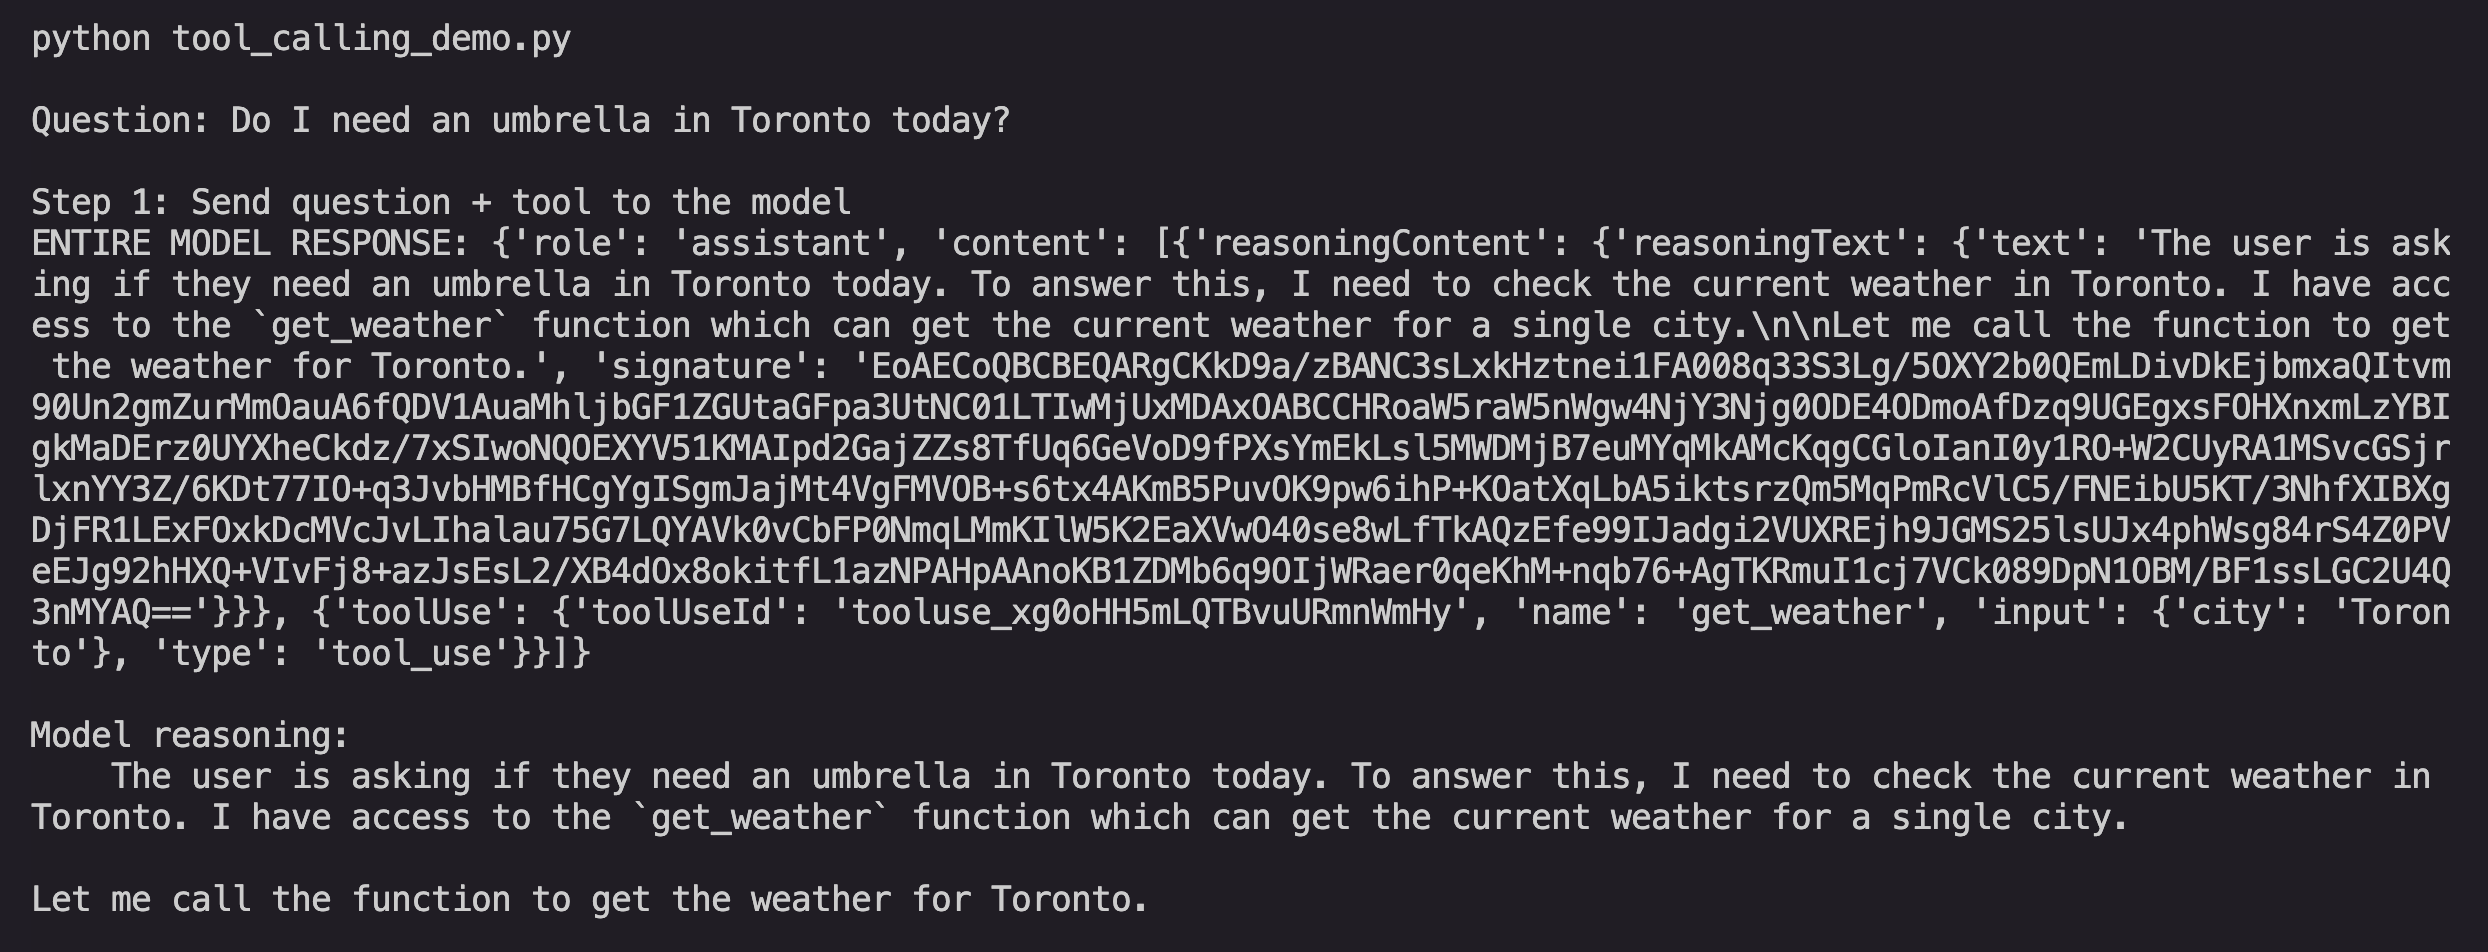
어느 도구를 쓰라고 지시하지 않았고, 인자도 알려주지 않았다. 모델은 질문 하나를 읽고 둘 다 알아냈다. 하지만 아직 실행된 건 아무것도 없다.
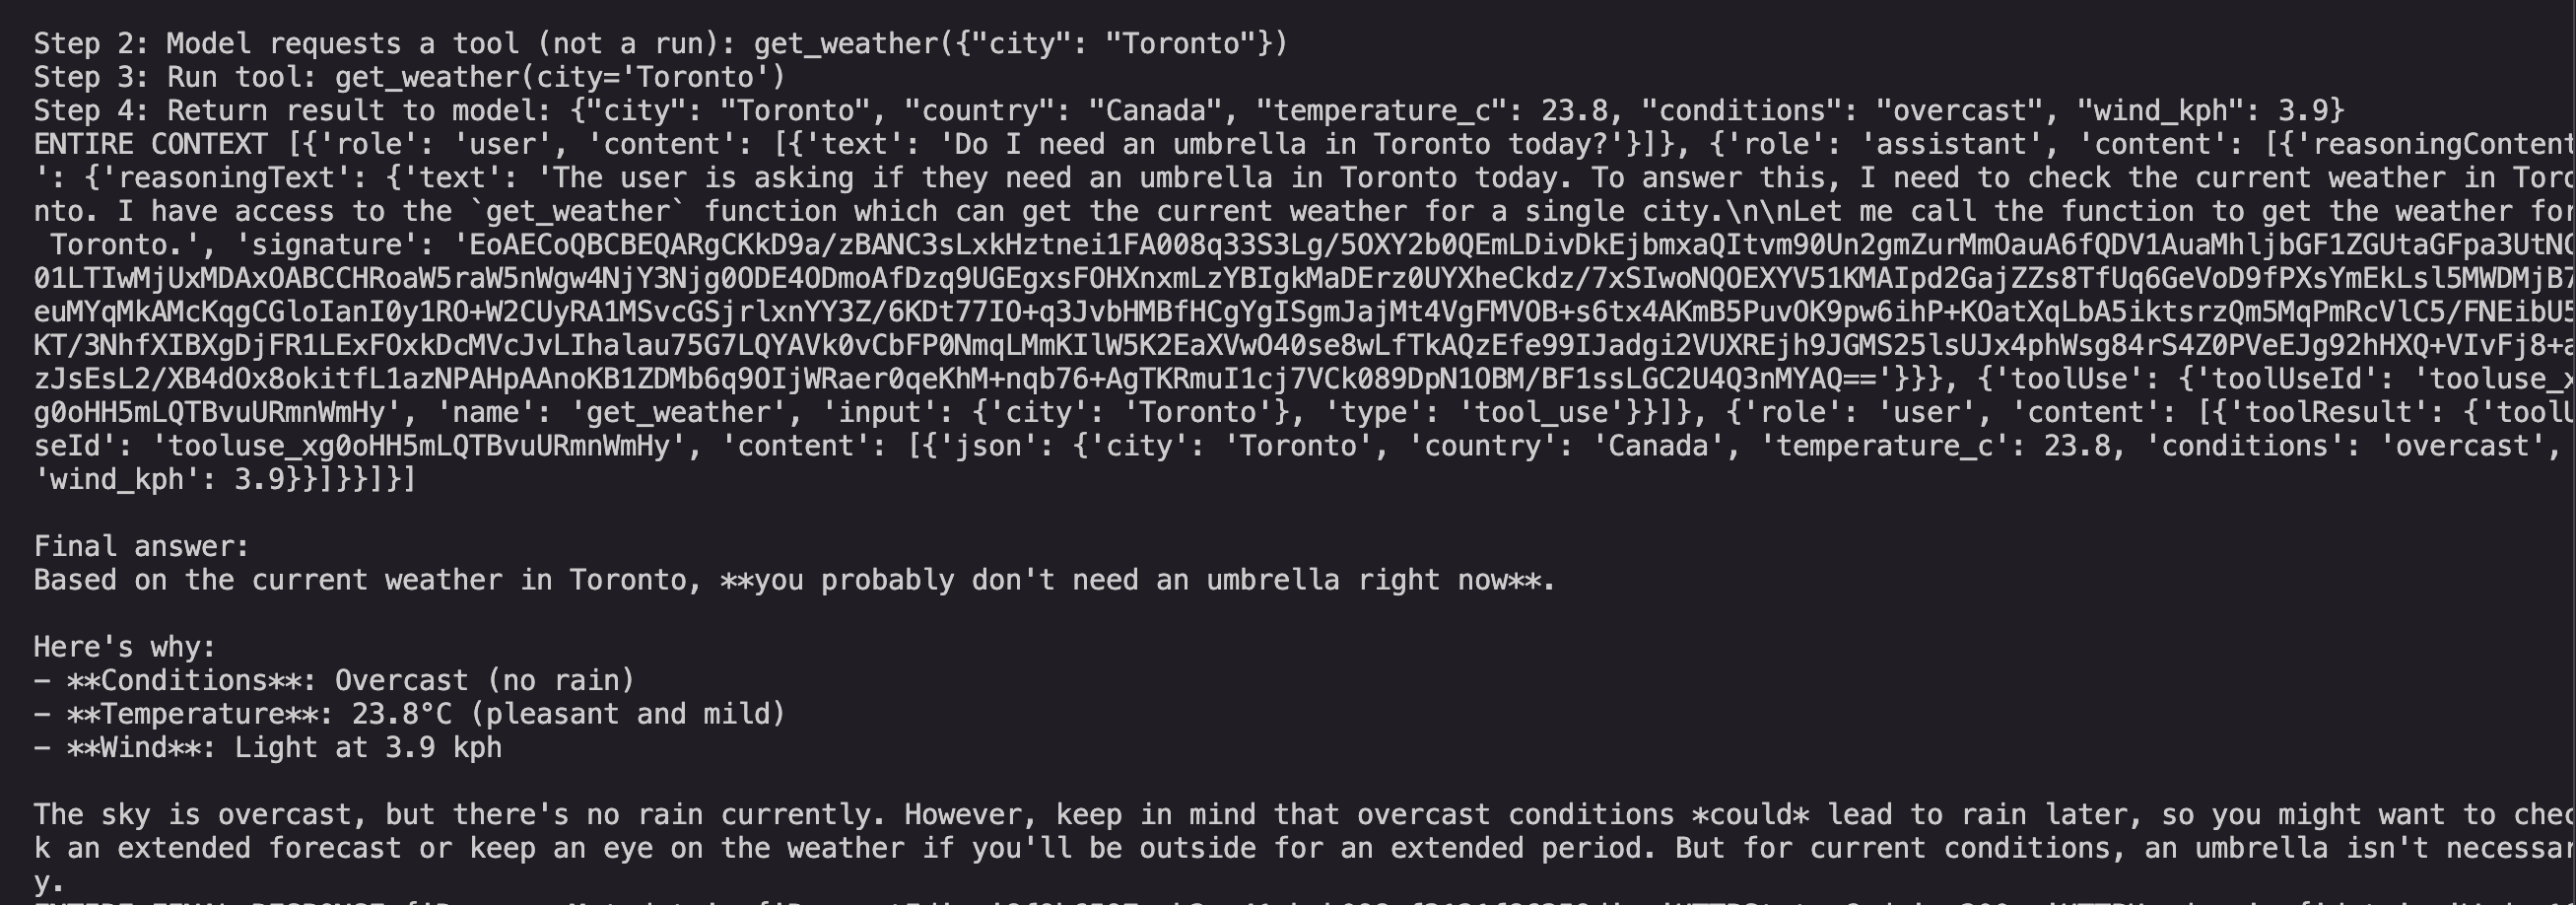
코드가 get_weather("Toronto")를 돌려 실제 날씨를 받아오고, 그 결과를 toolResult로 포장해 모델에게 돌려보낸다.
messages.append({
    "role": "user",
    "content": [{
        "toolResult": {
            "toolUseId": "tooluse_abc123",
            "content": [{"json": {
                "city": "Toronto",
                "country": "Canada",
                "temperature_c": 23.8,
                "conditions": "overcast",
                "wind_kph": 3.9,
            }}],
        }
    }],
})
도구가 하나면 전체 흐름이 직선이다. 보내고, 요청을 받고, 실행하고, 결과를 돌려보내고, 답을 받는다. 루프가 없다.
messages = [{"role": "user", "content": [{"text": QUESTION}]}]

# 1. Send the question + the tool.
response = bedrock.converse(
    modelId=MODEL,
    messages=messages,
    toolConfig={"tools": [WEATHER_TOOL]},
)
messages.append(response["output"]["message"])

# 2. The model asks for the tool. 3. Run it. 4. Send the result back.
tool_request = next(
    b["toolUse"] for b in response["output"]["message"]["content"] if "toolUse" in b
)
result = get_weather(tool_request["input"]["city"])
messages.append({
    "role": "user",
    "content": [{
        "toolResult": {
            "toolUseId": tool_request["toolUseId"],
            "content": [{"json": result}],
        }
    }],
})

# The model writes the final answer, grounded in the real data.
final = bedrock.converse(modelId=MODEL, messages=messages, toolConfig={"tools": [WEATHER_TOOL]})
왕복이 한 번뿐이라 무슨 일이 벌어질지 뻔하고, 그러니 코드에 그냥 박아넣어도 된다. 실제 데이터를 손에 넣은 모델은 이렇게 답한다. "토론토의 현재 날씨로 보면 지금 당장 우산은 필요 없을 겁니다."
이 답은 모델 안에 존재하지 않던 문장이다. 도구 호출 한 번으로 얼어붙은 지식이 현재 시점으로 옮겨왔다.
두 번째 도구, 그리고 날짜 문제 #
다음 질문은 사소해 보인다. "오늘 며칠이야?"
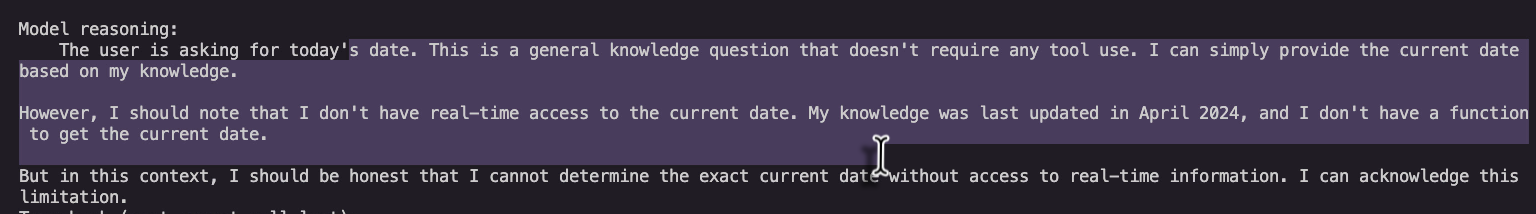
도구 호출이 돌아오지 않는다. 모델은 현재 날짜에 접근할 수 없다고 솔직하게 말한다. 가진 도구가 날씨뿐이니 날짜에 닿을 방법이 없다. 저자는 모델이 모른다고 인정하는 대목, 아는 척하지 않는 태도를 인상적으로 봤다.
도구가 없어서 못 답하는 문제라면 해법은 뻔하다. 날짜 도구를 하나 더 준다.
DATETIME_TOOL = {
    "toolSpec": {
        "name": "get_current_datetime",
        "description": "Get the current date and time.",
        "inputSchema": {"json": {"type": "object", "properties": {}}},
    }
}

def get_current_datetime() -> dict:
    from datetime import datetime
    now = datetime.now()
    return {
        "date": now.strftime("%Y-%m-%d"),
        "day_of_week": now.strftime("%A"),
        "time": now.strftime("%H:%M"),
    }
인자도 없고 AI도 없다. 오늘 날짜와 시간을 돌려주는 함수다. 이제 모델에게는 날씨와 날짜, 두 개의 도구가 있다.
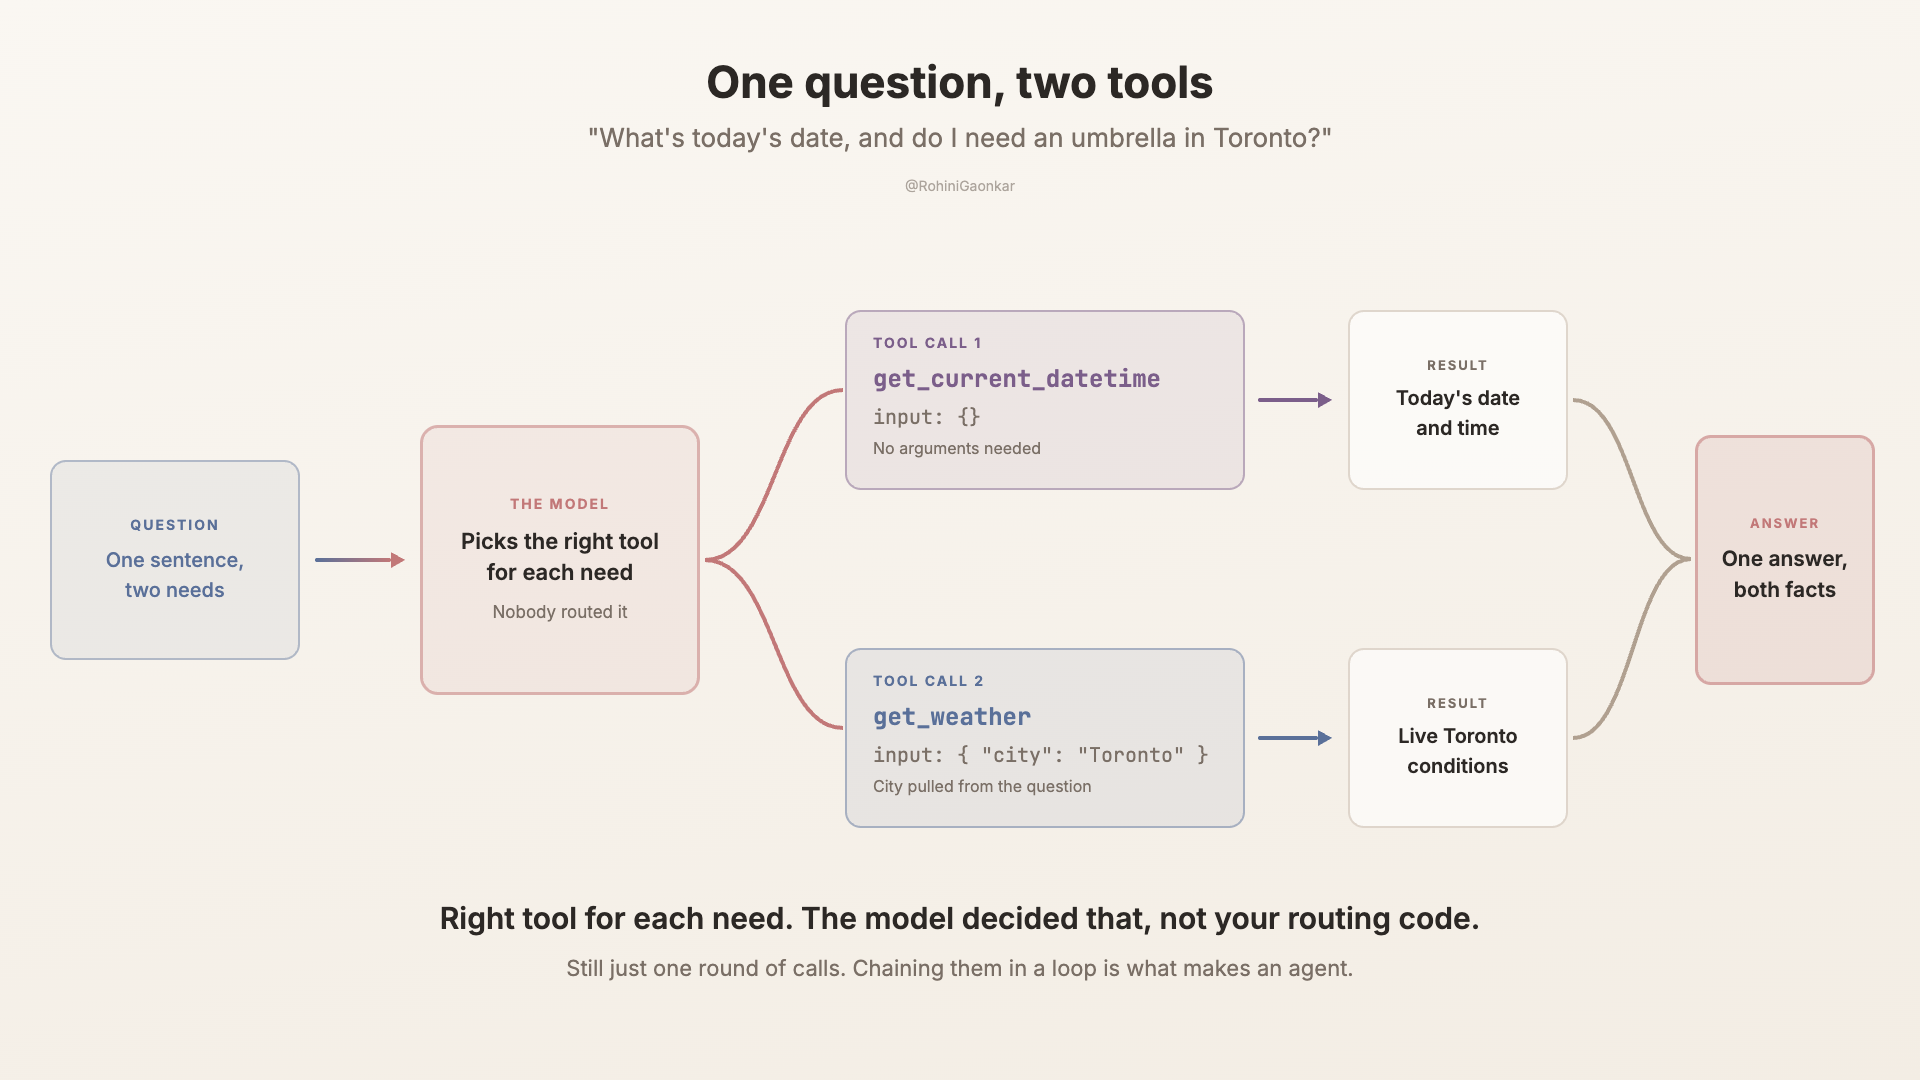
질문을 바꿔본다. "토론토에서 우산이 필요할까? 그리고 오늘 며칠이야?"
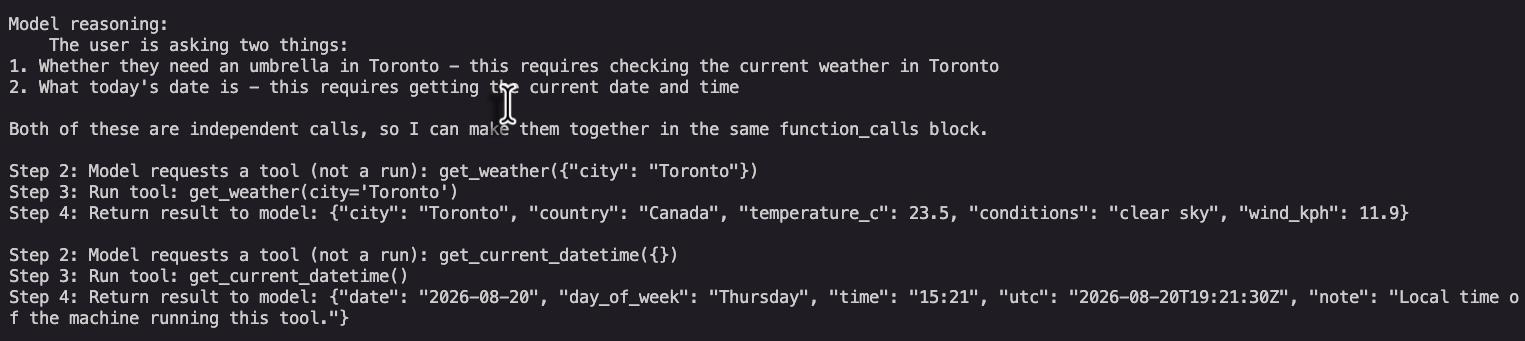
요청 두 개가 돌아온다. get_weather에 {"city": "Toronto"}, 그리고 get_current_datetime에 {}. 코드가 각각 실행하고 결과를 함께 돌려주면, 모델은 둘을 합쳐 하나의 답을 쓴다. 문장 하나, 서로 다른 요구 두 개, 각각에 맞는 도구로 알아서 갈랐다.
도구가 둘이 되면 루프가 필요해진다 #
그 깔끔한 직선은 여기서 무너진다. 도구가 하나일 때는 왕복이 정확히 한 번이라는 걸 알았다. 둘이 되면 모델이 어느 도구를 고를지, 몇 개를 고를지, 첫 결과를 본 뒤 또 요청할지 알 수 없다. 그래서 네 단계가 루프 안으로 들어간다. 모델이 도구를 계속 요청하는 동안 돌리고, 답을 쓰기 시작하면 멈춘다.
# name → the real function to run when the model asks for it.
TOOLS = {
    "get_weather": get_weather,
    "get_current_datetime": get_current_datetime,
}

messages = [{"role": "user", "content": [{"text": QUESTION}]}]

while True:
    response = bedrock.converse(
        modelId=MODEL,
        messages=messages,
        toolConfig={"tools": [WEATHER_TOOL, DATETIME_TOOL]},
    )
    assistant_message = response["output"]["message"]
    messages.append(assistant_message)

    # Done? The model stopped asking for tools and wrote its answer.
    if response["stopReason"] != "tool_use":
        answer = "".join(b["text"] for b in assistant_message["content"] if "text" in b)
        break

    # Otherwise: run every tool the model requested, send the results back.
    tool_results = []
    for block in assistant_message["content"]:
        if "toolUse" not in block:
            continue
        request = block["toolUse"]
        result = TOOLS[request["name"]](**request["input"])
        tool_results.append({
            "toolResult": {
                "toolUseId": request["toolUseId"],
                "content": [{"json": result}],
            }
        })
    messages.append({"role": "user", "content": tool_results})
저자는 이 while 루프가 모든 차이를 만든다고 본다. 도구 하나는 하드코딩 가능한 직선이었지만, 둘 이상이 되면 제어권을 모델에게 넘기고 끝날 때까지 끌고 가게 한다.
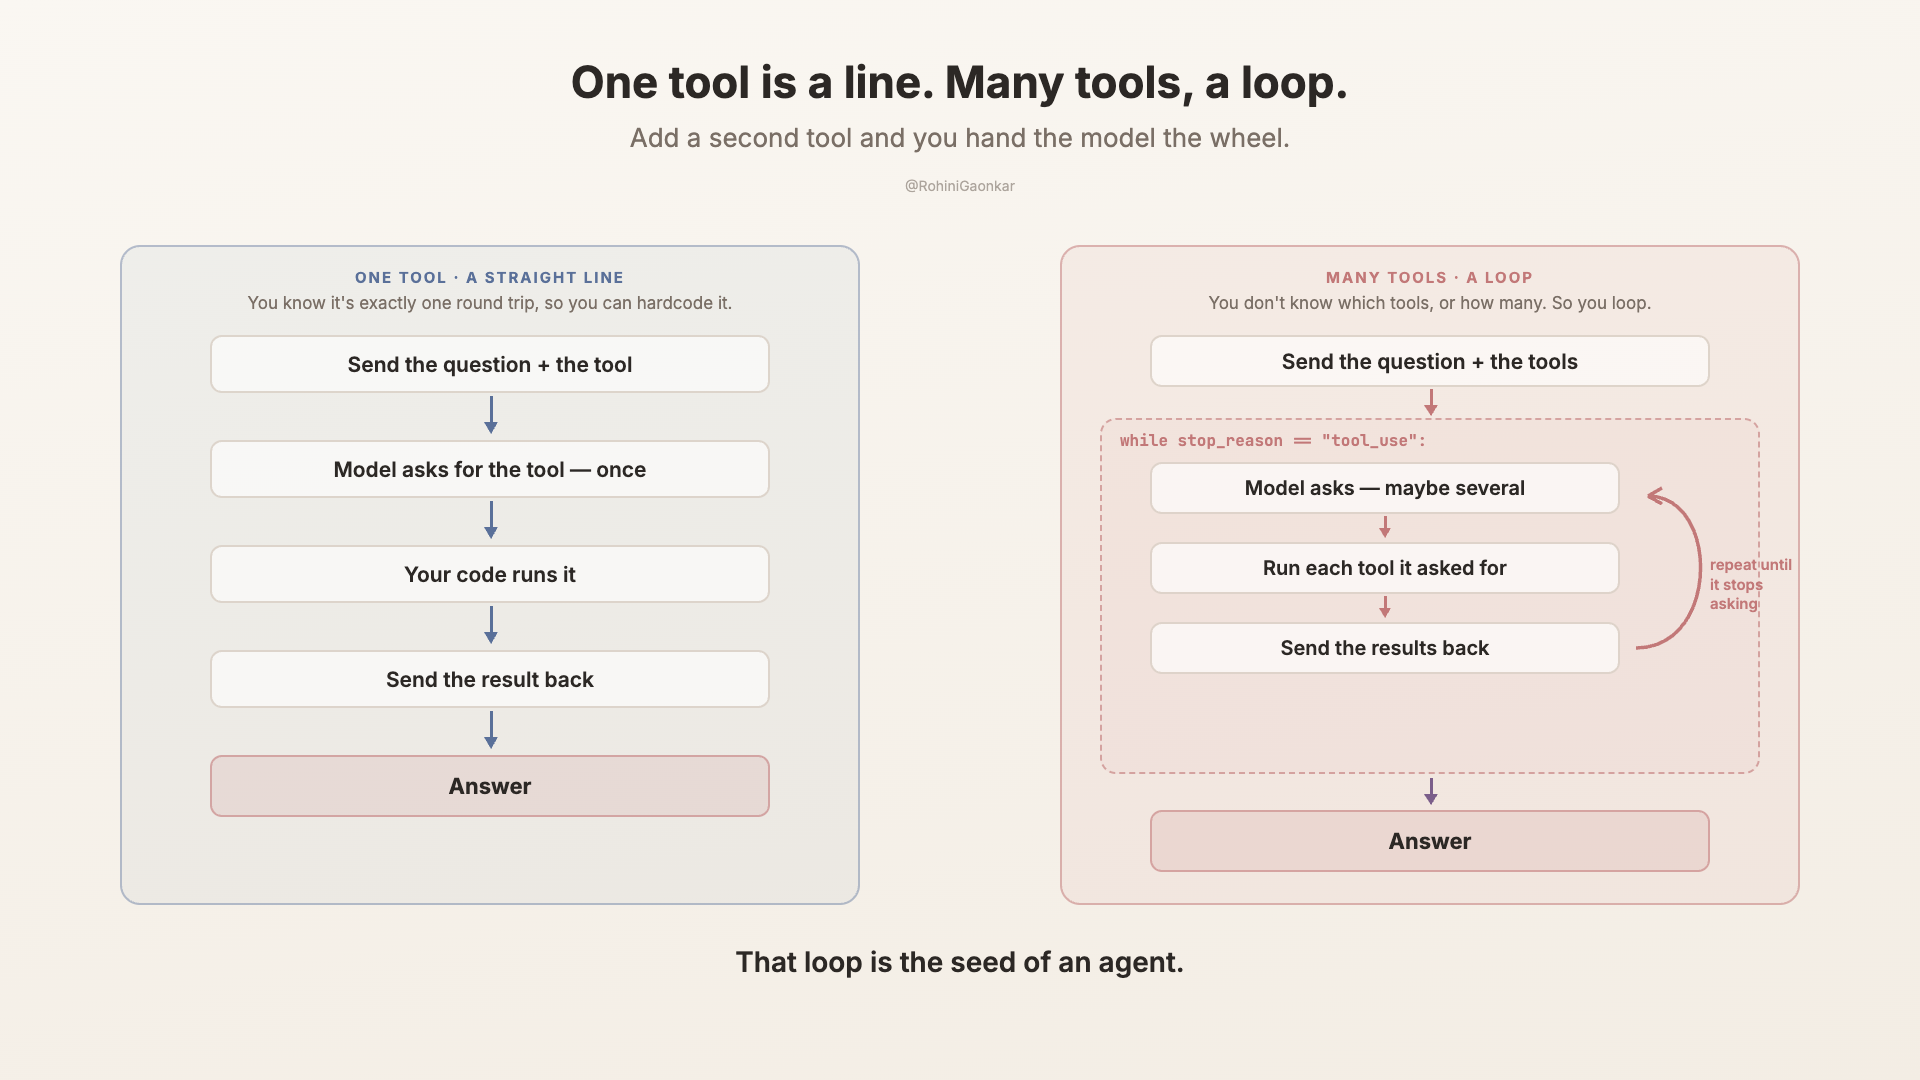
이 루프가 바로 에이전트의 씨앗이다.
ChatGPT와 Claude는 어떻게 날짜를 아는가 #
순수한 모델이 오늘 날짜를 모른다면, ChatGPT나 Claude 같은 어시스턴트는 어떻게 즉시 답하는 걸까. 매번 날짜 도구를 호출하는 걸까. 저자의 답은 아니다.
Anthropic은 Claude에 쓰는 시스템 프롬프트를 릴리스 노트로 공개하고 있다. 거기 붙은 설명에 따르면, Claude의 웹 인터페이스와 모바일 앱은 대화가 시작될 때마다 현재 날짜 같은 최신 정보를 시스템 프롬프트에 넣어준다.
도구는 돌지 않는다. 사용자 메시지가 도착하기 전에 지시문에 끼워 넣은 텍스트일 뿐이다. 모델은 날짜를 컨텍스트로 받은 것이다. 같은 걸 스크립트에서도 할 수 있다. 날짜 도구를 없애고 오늘 날짜를 시스템 프롬프트에 평문으로 붙이면 된다.
system_prompt = [{
    "text": f"Today's date is {datetime.now():%A, %d %B %Y}."
}]
"오늘 며칠이야?"라고 물으면 도구 호출 없이 정확히 답한다. 날짜를 이미 손에 쥐어줬기 때문이다.
도구냐 주입이냐 #
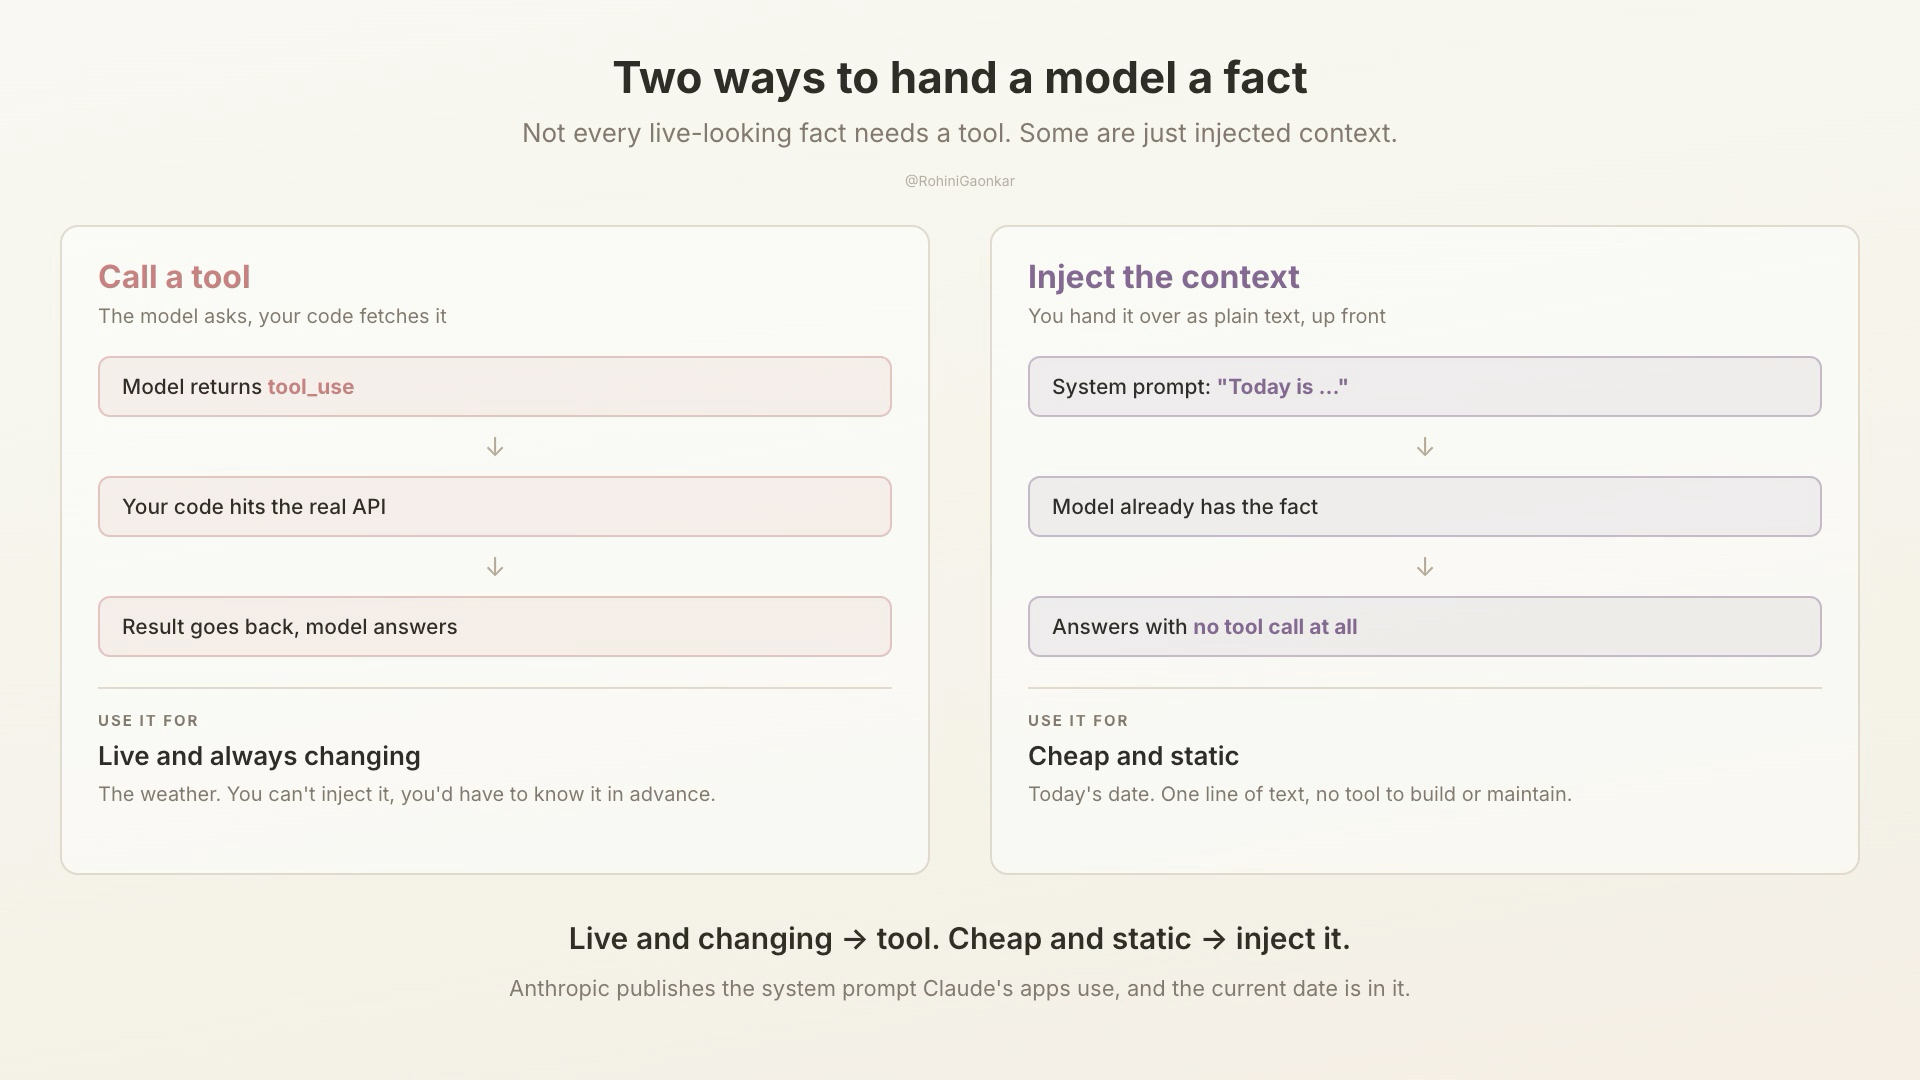
모델에게 없는 사실을 건네는 길은 두 개다. 모델이 요청하고 코드가 실행하는 도구, 아니면 프롬프트에 곧바로 밀어 넣는 컨텍스트. 기준은 이렇게 갈린다.
- 싸고 잘 안 바뀌는 사실, 예컨대 오늘 날짜라면 주입한다. 한 줄이면 되고 도구는 필요 없다.
- 실시간으로 계속 바뀌는 사실, 예컨대 날씨라면 도구를 쓴다. 날씨는 주입할 수 없다. 미리 알아야 한다는 모순에 빠진다. 도구는 모델이 물어본 그 순간에 가서 새로 가져온다.
스키마에 city만 있었다는 점도 그대로 제약이 된다. 넘길 날짜가 없으니 다음 주 날씨는 물어볼 수 없다. 예보가 필요하면 그건 다른 도구다.
하드코딩의 한계와 MCP #
도구 두 개는 이렇게 돌아간다. 문제는 현실의 시스템이 두 개로 끝나지 않는다는 데 있다. 캘린더 확인, CRM 검색, 데이터베이스 질의, 메일 발송, 파일 읽기까지 수십 개다.
지금까지 만든 방식이라면 그 하나하나를 직접 배선해야 한다. 스키마를 쓰고, 함수를 쓰고, 등록하고, 도구가 바뀔 때마다 설명을 맞춰준다. 두 개면 괜찮다. 앱 다섯 개에 걸친 도구 오십 개가 계속 바뀌는 상황이라면 유지보수가 무너진다. 게다가 AI 앱을 만드는 모두가 같은 도구를 위해 같은 접착 코드를 반복해서 쓰고 있었다.
MCP(Model Context Protocol)가 푸는 문제가 이것이다. Anthropic이 시작해 지금은 업계 전반에서 쓰이는, AI 앱과 도구가 대화하는 방식에 관한 오픈 표준이다.
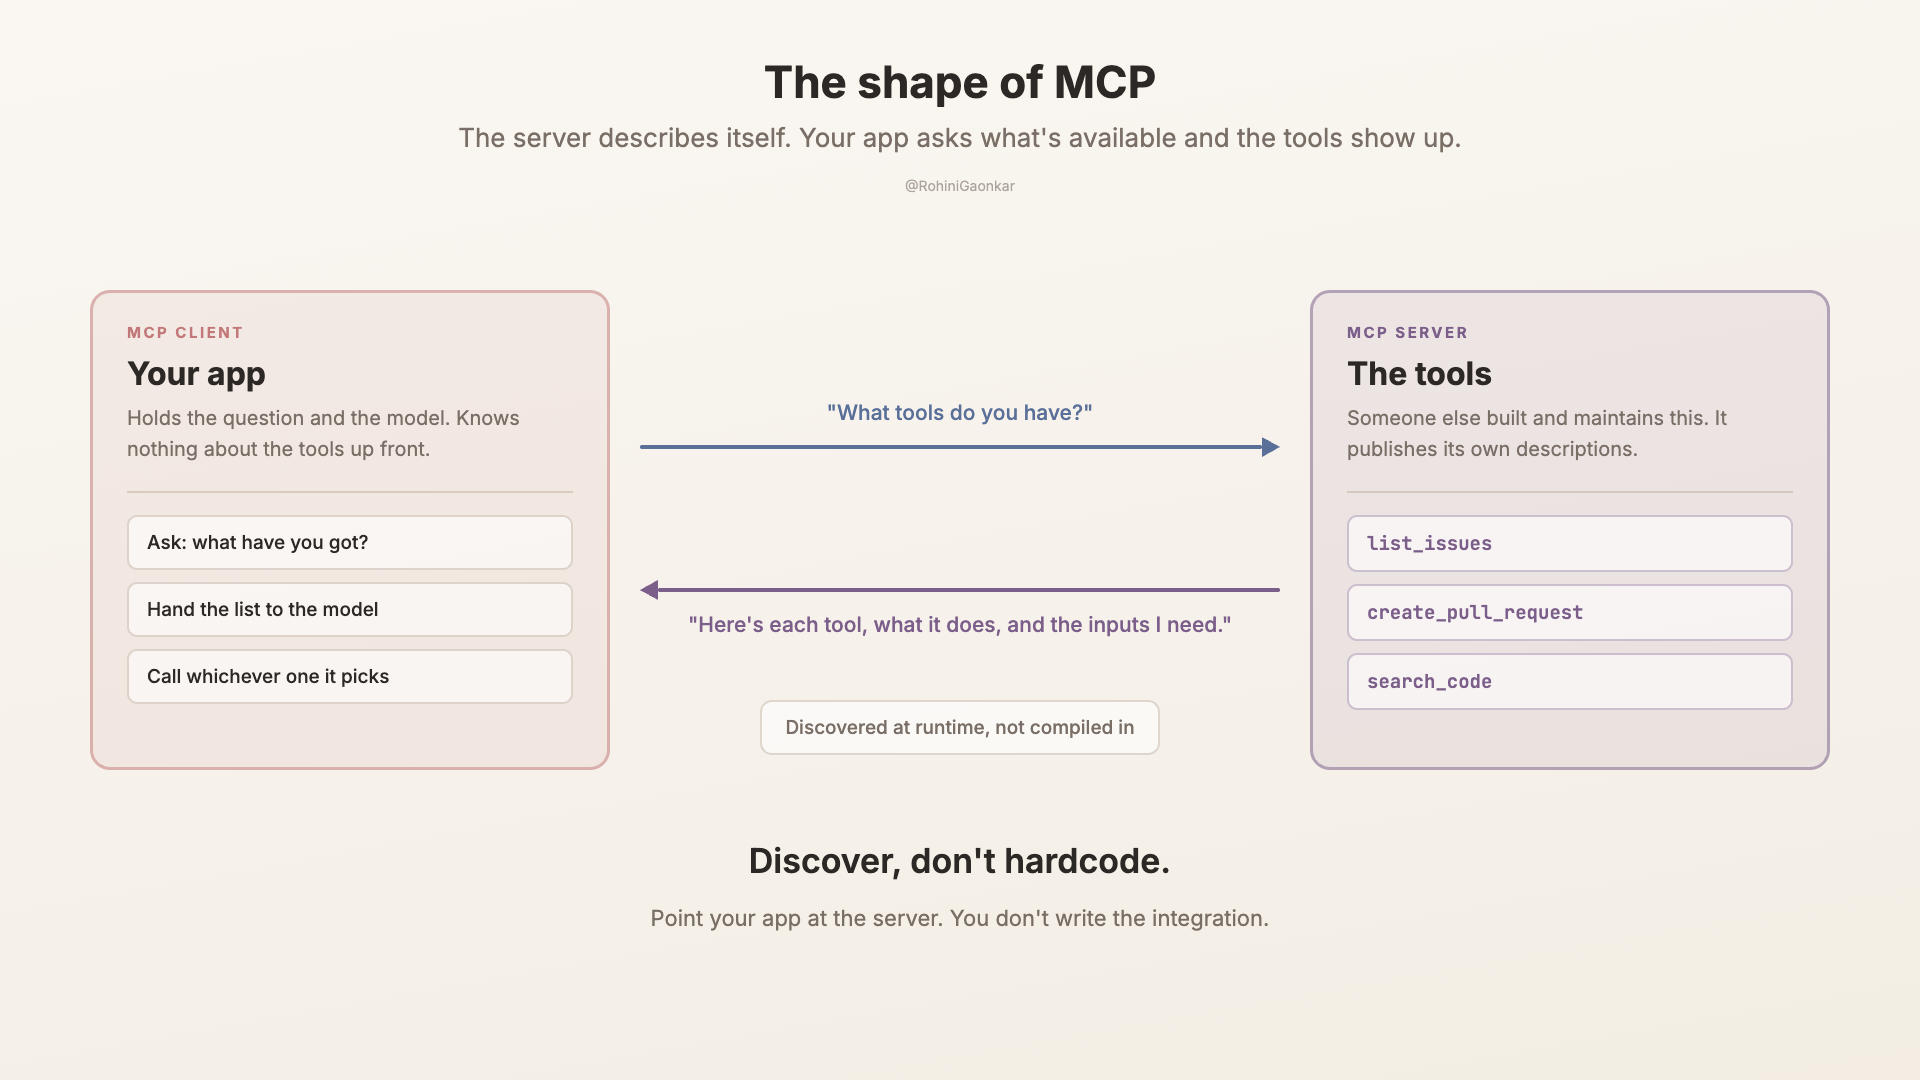
저자가 제시한 비유는 명쾌하다. MCP는 AI 도구를 위한 USB-C다. USB-C 이전에는 기기마다 고유한 케이블과 커넥터가 있었고, 케이블 뭉치가 곧 혼란이었다. USB-C는 하나의 표준 플러그다. MCP는 모델과 도구·데이터를 연결하는 쪽에서 같은 역할을 한다.
도구는 MCP 서버 뒤에 있고, 서버는 자기 자신을 설명한다. 내가 제공하는 도구는 이것들이고, 각각은 이런 일을 하며, 필요한 입력은 이렇다는 식이다. 앱은 MCP 클라이언트가 되어 "뭘 가지고 있냐"고 묻고, 서버가 답한다. 도구가 런타임에 발견된다.
그래서 누군가 GitHub이나 데이터베이스, Slack용 MCP 서버를 만들어두면 통합 코드를 직접 쓸 필요가 없다. 앱이 그 서버를 가리키게 하면 도구가 나타난다. Tool Calling은 한 모델이 도구 하나를 쓰는 방법이고, MCP는 어떤 모델이든 도구를 발견하고 쓰는 방법이다.
정리 #
저자는 독자를 두 갈래로 나눠 요점을 정리한다.
막 시작하는 쪽이라면, Tool Calling은 AI가 닫힌 상자에서 벗어나는 방법이다. 도구를 주면 말만 하는 대신 실시간 정보를 끌어오고 행동할 수 있다. 붙잡아둘 문장 하나는 모델이 두뇌, 코드가 손이라는 것.
만드는 쪽이라면, 모델이 도구를 고르고 인자를 채울 때 읽는 건 개발자가 쓴 설명과 스키마뿐이다. 그러니 프롬프트처럼 쓰고, 이 도구가 무엇을 하고 무엇을 하지 않는지 구체적으로 적어야 한다. 정적인 사실은 주입하고, 실시간 사실에는 도구를 붙인다. 그리고 도구가 두세 개를 넘기면 하드코딩을 멈추고 MCP를 본다.
다음 편의 주제는 순서가 필요한 질문이다. 캘린더를 확인하고, 그 날짜의 날씨를 보고, 메일 초안을 쓰는 식으로 모델이 계획하고 실행하고 결과를 보며 다음 단계를 정하는 루프. 저자는 그 루프를 에이전트라 부르며, Strands Agents SDK로 직접 만들어보겠다고 예고했다.
이 글은 클라우드 아키텍트가 AI를 제1원리부터 배워가는 "Learning AI Out Loud" 시리즈의 한 편이다. 시리즈 팔로우하기 →
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.