구현은 판단이 보이지 않게 숨는 곳이다 (Implementation is where judgements go to become invisible)
답장 대기자를 세는 작은 도구의 세 버전이 각각 18, 34, 2라는 다른 답을 냈습니다. 두 개발자가 두 달 동안 댓글로 주고받은 대화를 따라가며, 코드와 테스트, 측정값 안에 판단이 어떻게 조용히 묻히는지 정리했습니다.


Implementation is where judgements go to become invisible
One question, three answers I have a small tool that finds people waiting for a reply from...
개요 #
같은 질문을 던졌는데 세 버전의 도구가 18, 34, 2라는 서로 다른 답을 내놨습니다. 셋 다 버그는 없었습니다.
Dev.to 작성자 Tom Jones는 자기 답장을 기다리는 사람을 찾아 주는 작은 도구를 쓰고 있었습니다. 버전마다 '답장했다'를 다르게 정의했고, 그 정의는 코드 안에 조용히 들어가 있었습니다. 세 버전 모두 자기가 센 집합에 대해서는 정확했습니다. 문제는 셋 다 그 숫자를 "누가 기다리고 있나?"에 대한 답처럼 내놨다는 점입니다.
이 글은 Tom Jones가 Pascal Cescato와 두 달 동안 댓글로 나눈 대화를 정리한 것입니다. 한쪽이 끝난 것처럼 보이는 답을 내면, 다른 쪽이 실제로 겪은 실패 사례를 들고 와서 그 답 안에 숨은 판단을 찾아내는 식으로 대화가 이어졌습니다. 저자가 한 말이 제목이 됐습니다. 구현은 판단이 보이지 않게 숨는 곳이다.
세 개의 숫자, 하나의 질문 #
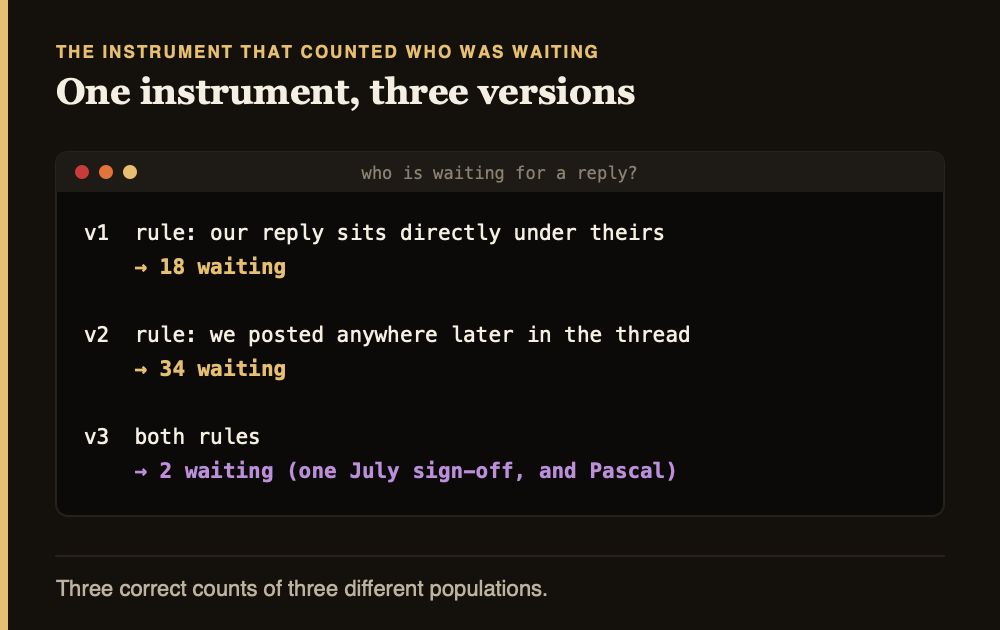
- 버전 1은 18명. 상대 댓글 바로 아래에 단 답장만 셌습니다. 그런데 Dev.to는 API로는 내려오는 댓글을 화면에 안 보여 줄 때가 있어서, 저자는 그럴 때 옆에 따로 답을 달곤 했습니다. 18명 중 9명꼴로 이미 그렇게 답을 받은 상태였습니다.
- 버전 2는 34명. 스레드 안에 저자가 나중에 단 댓글이 하나라도 있으면 답장으로 쳤습니다. 그러다 보니 다른 두 사람끼리 나눈 대화까지 세어 버렸습니다.
- 버전 3은 2명. 두 규칙을 같이 썼습니다. 한 명은 7월에 남긴 가벼운 작별 인사였고, 다른 한 명은 "이 댓글들 속에 글감이 숨어 있는 것 같다"고 한 Pascal이었습니다.
첫 번째 버전도 신중하게 만든 도구였습니다. 합리적인 판단을 코드에 담았습니다. 그런데 시간이 지나자 그게 판단으로 보이지 않게 됐습니다. 저자는 이 사건 하나에 글의 요지가 다 들어 있다고 말합니다.
대화는 7월, Calendly를 대체한 경험을 다룬 Pascal의 글 댓글란에서 시작했습니다. 처음부터 무슨 방법론이 있던 건 아닙니다. 같은 패턴이 계속 반복됐을 뿐입니다.
1. one of us has an answer that looks finished
2. the other brings back a real failure
3. the answer turns out to be hiding a judgement
테스트에 숨은 판단 #
"테스트가 통과했다" #
첫 사례는 Pascal의 글에서 나왔습니다. 두 사람이 같은 시간대를 동시에 예약하려는 상황은 Postgres에서는 실제로 경쟁 상태(race)가 됩니다. SQLite에서는 이런 일이 생기지 않습니다. 한 번에 한 쓰기 작업만 허용하기 때문입니다.
그래서 이 경쟁 상태를 잡으려는 테스트를 SQLite에서 돌리면 언제까지나 통과합니다. 버그는 그대로 Postgres 운영 환경에 나갑니다.
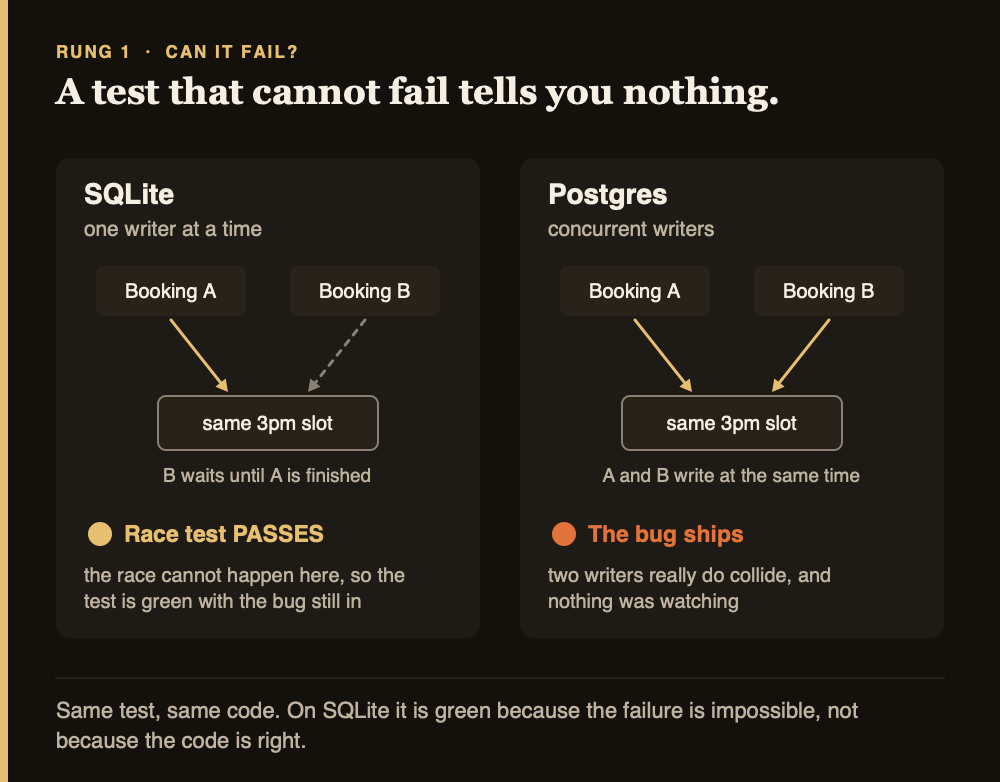
숨은 판단: 이 테스트가 애초에 실패할 수 있는가.
해결책은 단순합니다. 테스트를 쓴 다음, 테스트가 지키는 코드를 일부러 망가뜨리고 다시 돌려 봅니다. 그래도 초록불이면 그 테스트는 처음부터 아무것도 감시하지 않은 겁니다.
Pascal은 회귀 테스트의 가치를 이렇게 설명했습니다. *"실제로 일어난 실패를 나타내고, 그 조건이 다시 오면 실패한다는 걸 증명했기 때문"*이라고요. 대부분은 이 문장의 앞부분만 기억하고 뒷부분을 잊는다고 덧붙였습니다.
"테스트가 약하다" #
코드를 일부러 망가뜨려서 테스트가 알아채는지 보는 기법을 뮤테이션 테스트(mutation testing)라고 합니다. 망가뜨려도 테스트가 초록불이면 다들 테스트가 약하다고 생각합니다. 저자는 그게 네 가지 원인 중 하나일 뿐이고, 그중에서도 가장 흥미롭지 않은 원인이라고 말합니다.
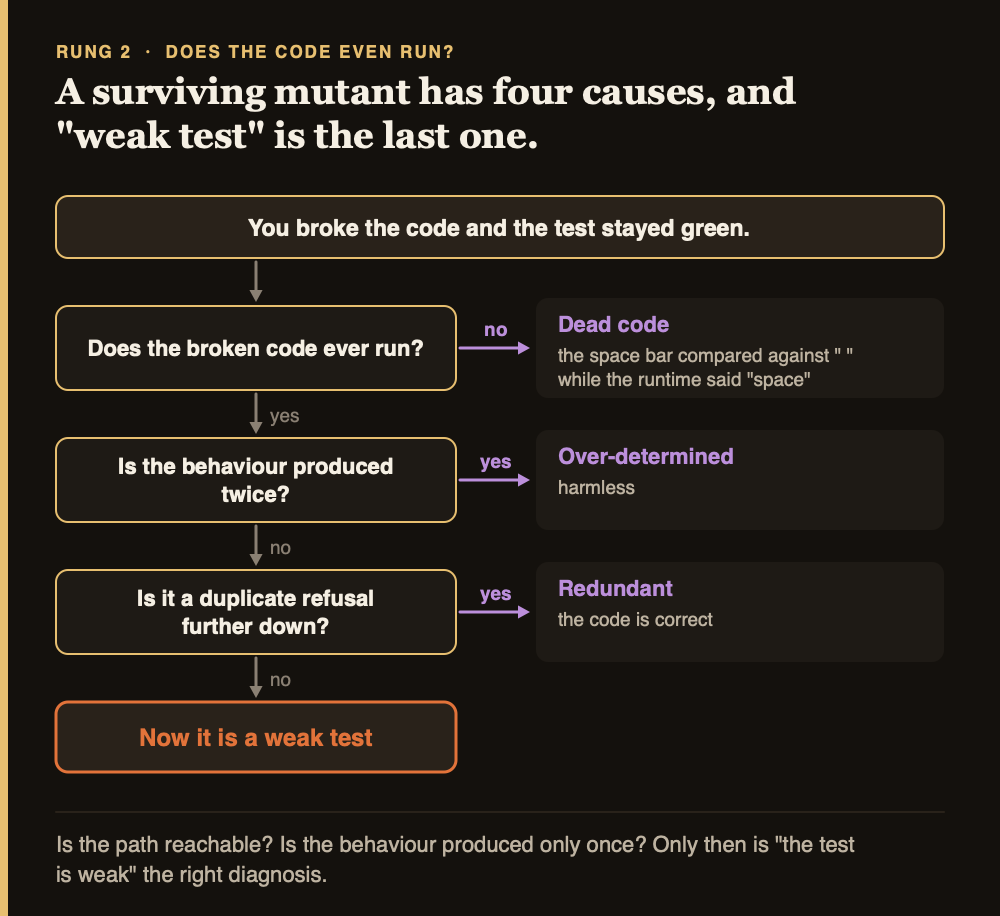
저자가 겪은 건 첫 번째 경우, 죽은 코드였습니다. 키 바인딩 코드가 입력된 키를 " "와 비교하고 있었는데, 런타임은 스페이스 바를 "space"로 넘겨주고 있었습니다. 그 분기는 파일이 생긴 뒤로 한 번도 실행된 적이 없었습니다. 저자는 그 부분에서 회귀를 일으켰다고 동료에게 이미 말해 둔 상태였는데, 사실 회귀할 기능 자체가 없었던 겁니다.
숨은 판단: 테스트 대상 코드가 실제로 실행되기는 하는가.
Pascal은 이 경우들을 점검 순서로 바꿨습니다.
- 그 경로에 실제로 도달할 수 있는가?
- 테스트가 그 동작을 관찰하는가?
- 동작을 망가뜨리면 테스트가 실패하는가?
세 가지를 모두 확인한 뒤에야 "테스트가 약하다"는 진단이 맞다는 겁니다. Pascal은 살아남은 뮤턴트가 테스트에 대한 판정이라기보다 *"코드가 스스로에 대해 하는 이야기에 이의를 제기하는 방법"*일 수 있다고도 했습니다.
검증에 숨은 판단 #
"모든 검사가 초록불이다" #
코드가 하는 이야기에는 여러 작성자가 있습니다. 코드는 자기가 뭘 하는지 말하고, 테스트는 그걸 확인해 주는 것처럼 보이고, 마지막으로 시스템을 설명한 사람도 같은 이야기를 반복합니다. 스페이스 바 사례처럼 이들이 한꺼번에 같은 방식으로 틀릴 수 있습니다.
이 합의를 깨는 건 그 이야기를 전해 듣지 않은 무언가입니다. Pascal은 이를 *"유효성이 서사가 아니라 작동으로 정의되는 산출물"*이라고 불렀고, 그 검증은 한마디로 줄일 수 있다고 했습니다. "실패를 보여 줘(Show me the failure)."
Pascal은 한 걸음 더 나갔습니다. 테스트는 누군가 떠올린 것만 확인합니다. 실제 사용자는 아무도 떠올리지 못한 걸 들고 옵니다. 그래서 운영 환경은 *"작성자를 우리가 통제하지 못하는 유일한 테스트 스위트"*라는 겁니다.
저자에게는 뼈아픈 사례가 있었습니다. 저자의 게이트웨이는 세 가지 API 포맷을 지원했고, 검사는 전부 초록불이었습니다.
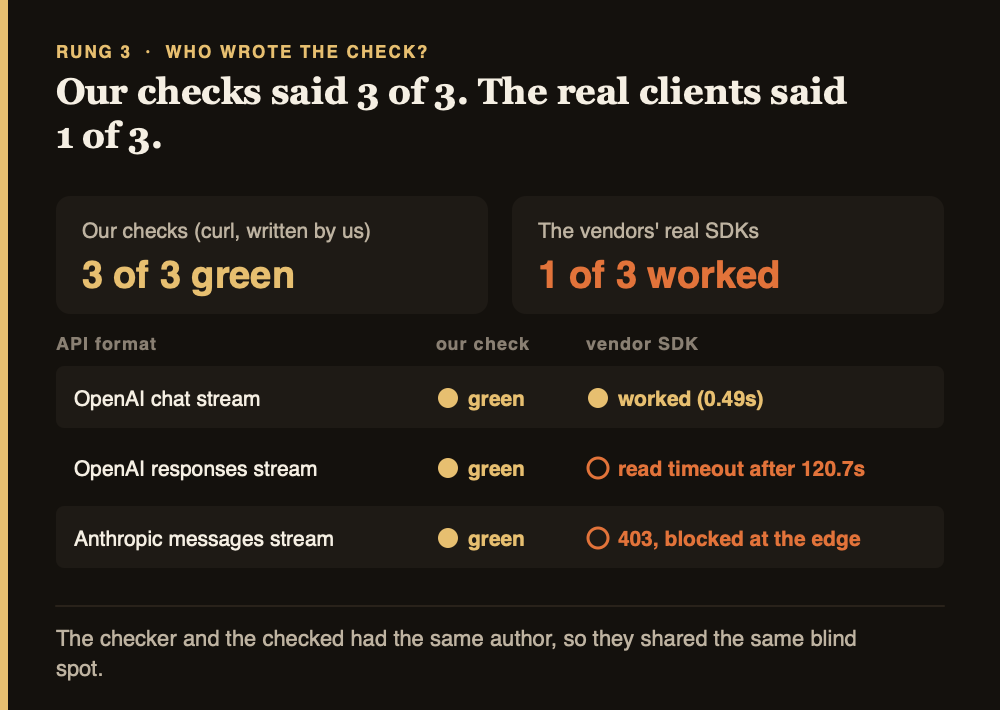
검사는 저자가 직접 짠 curl 명령이었고, 저자가 만든 포맷으로 저자의 서버와 대화했습니다. 그런데 한 벤더의 SDK는 저자의 엣지 규칙이 읽는 헤더와 다른 헤더에 키를 담아 보냈습니다. 그 요청은 처리 코드에 닿기도 전에 막혀 버렸습니다.
숨은 판단: 검사를 누가 작성했는가. 검사하는 쪽과 검사받는 쪽의 작성자가 같았고, 그래서 사각지대도 같았습니다.
"검사를 더 추가하자" #
뻔한 대응은 검사를 더 늘리는 겁니다. 하지만 검사끼리 서로 다른 결과를 낼 수 있을 때만 의미가 있습니다.
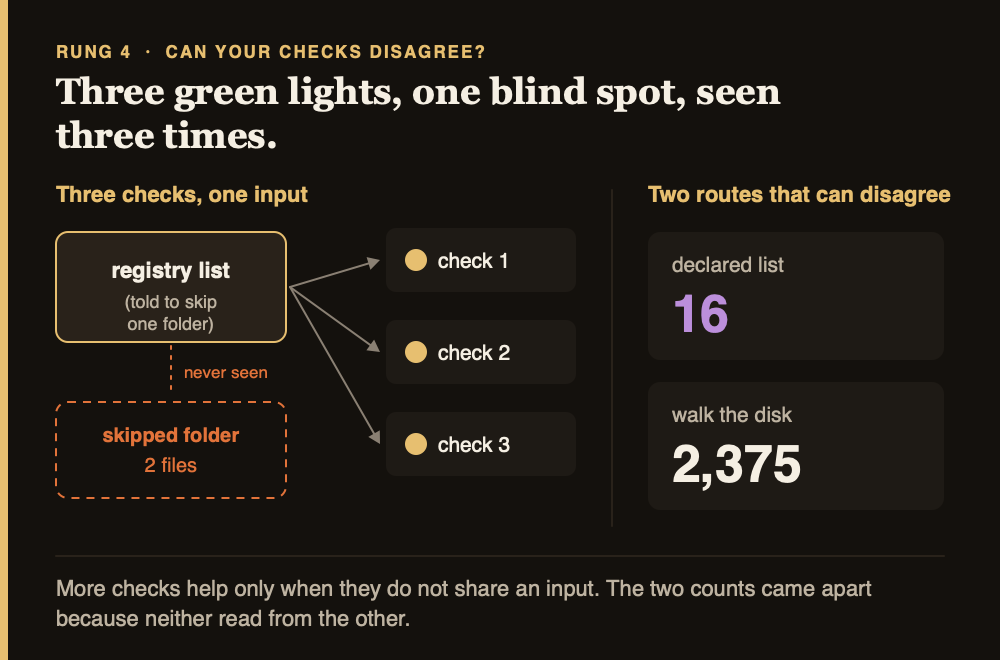
왼쪽(이전) 에는 같은 파일 레지스트리를 보는 검사 세 개가 있습니다. 코드도 다르고, 작성 시점도, 만든 이유도 달랐습니다. 셋 다 초록불이었습니다. 그런데 레지스트리가 건너뛰도록 설정된 폴더에 파일 두 개가 있었고, 세 검사 모두 그 파일들을 보지 못했습니다. 초록불 세 개가 켜졌지만, 실제로는 같은 사각지대를 세 번 본 것뿐이었습니다.
오른쪽(이후) 은 실제로 문제를 잡은 사례입니다. 두 도구가 같은 저장소를 셌는데 결과가 16과 2,375로 갈렸습니다. 한 도구는 누군가 선언해 둔 목록을 따라갔고, 다른 도구는 디스크를 직접 훑었습니다. 서로의 입력을 받아 쓰지 않았기 때문에 결과가 어긋날 수 있었고, 실제로 어긋났습니다.
Pascal은 독립성이란 *"불일치할 가능성을 남겨 두는 것"*이라고 했습니다. 코드가 다르다고 충분한 게 아니라, 검사끼리 서로 다른 방식으로 틀릴 수 있어야 한다는 뜻입니다.
측정에 숨은 판단 #
"기다리는 답장 0건" #
모든 검사는 무언가를 세고, 무엇을 셀지는 누군가 정했습니다. 대개는 아무도 정하지 않았습니다. 처음 호출한 쪽이 넘긴 집합이 그대로 굳었을 뿐입니다. Pascal은 이 문제를 한 문장으로 짚었습니다. "테스트가 무엇을 볼 수 있을지는 누가 정했나?"
저자의 야간 리포트 첫 줄에 이런 문장이 찍힌 적이 있습니다.
0 replies waiting on our own articles맞는 말이었습니다. 그런데 이 리포트를 읽은 세션은 저자를 기다리는 사람이 아무도 없다고 결론 내렸고, 그건 틀렸습니다. 다른 사람 글에 달린 답장은 다른 분류에 들어가 있었기 때문입니다.
숫자는 거짓말하지 않았습니다. 더 좁은 질문에 답하면서 더 넓은 질문에 답하는 것처럼 보였을 뿐입니다.
숨은 판단: 어떤 글을 내가 지켜볼 글로 칠 것인가. 맨 앞의 탐지기 사례와 같은 부류이고, 한 단계 앞에서 생긴 문제입니다.
저자는 검사기를 추가하는 대신 리포트를 고쳤습니다. 이제 리포트는 자기가 무엇을 보지 못했는지 밝히고, 전체 목록을 가져오지 못하면 coverage unknown을 출력합니다. 비어 있는 집합과 아무도 측정하지 않은 집합은 둘 다 0을 찍지만 뜻은 정반대이기 때문입니다.
"A 설정이 압도적으로 이겼다" #
비교에는 분모가 두 개 있고, 두 분모가 달라도 아무도 알아채지 못할 수 있습니다.
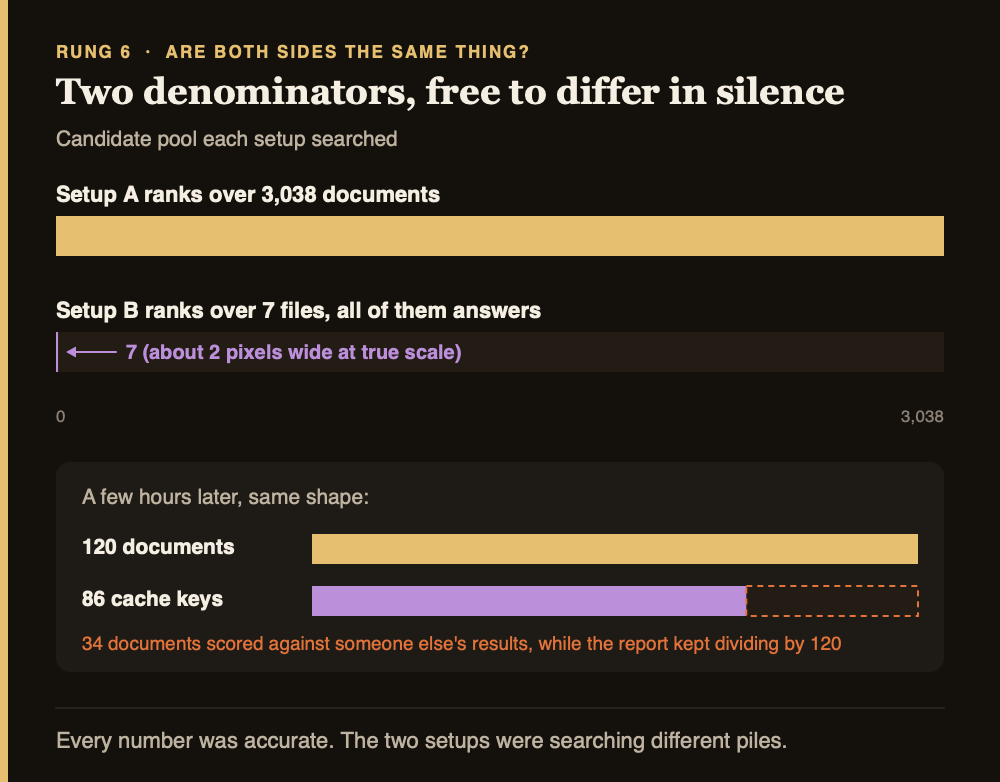
저자는 검색(retrieval) 벤치마크 결과를 정리하던 중이었고, 한 설정이 다른 설정을 큰 차이로 이겼습니다. 숫자는 모두 정확했습니다. 그런데 각 설정이 무엇을 검색했는지 보니, 한쪽은 문서 3,038개 중에서 순위를 매겼고 다른 쪽은 7개 중에서 매겼습니다. 그 7개는 모두 정답이 들어 있는 파일이었습니다. 헬퍼 함수가 과제 목록으로 인덱스를 만들었기 때문입니다.
Pascal의 답은 대화 전체에서 가장 짧은 규칙이었습니다. "바나나와 원숭이는 더하지 않는다(You don't add bananas and monkeys)."
이 규칙은 몇 시간 뒤에 다시 쓸모를 증명했습니다. 캐시가 문서를 줄인 id로 키를 잡는 바람에 문서 120개가 키 86개로 뭉쳤습니다. 34개 문서가 다른 문서의 결과로 채점됐는데, 리포트는 계속 120으로 나누고 있었습니다. 이 문제는 단 한 줄로 잡혔습니다.
assert len(cache) == len(documents)같은 한 줄이 저자의 수정본도 잡아냈습니다. 이번에는 반대 방향으로 충돌이 났기 때문입니다.
더 까다로운 경우는 두 숫자가 일치할 때입니다. 저자의 사용량 로그에는 한 제공자 이름으로 요청 2,488건이 기록돼 있었습니다. 그런데 그런 종류의 요청은 서비스가 이름은 그대로 두고 실제로는 다른 제공자로 보내고 있었습니다. 양쪽 모두 같은 라벨을 읽었으니 둘 다 2,488이 나왔습니다. Pascal의 말대로 "때로는 이름을 믿지 말고 그 이름이 가리키는 대상을 직접 봐야 합니다."
값, 범위, 처리 #
어느 지점을 넘으면 숫자는 완벽하게 정확한데도, 독자가 당연히 기대하는 질문보다 좁은 질문에 답하게 됩니다. Pascal은 이를 의미 계약(semantic contract)이 깨진 상태라고 불렀고, 이런 문제는 불변식(invariant)으로도 잡지 못할 수 있다고 했습니다.
Pascal이 내놓은 답은 측정값을 *"값 + 범위 + 처리(value + scope + treatment)"*로 보자는 것이었습니다. 범위나 처리를 바꿨을 때 숫자의 의미가 바뀔 수 있다면, 그 정보를 숫자 옆에 같이 적어야 한다는 겁니다.
완성된 답처럼 보였습니다. 저자는 여기에 빠진 항목을 하나 더 짚었습니다. 방금 그 문제로 호되게 당했기 때문입니다. 무엇과 비교했는지도 처리의 일부라는 겁니다.
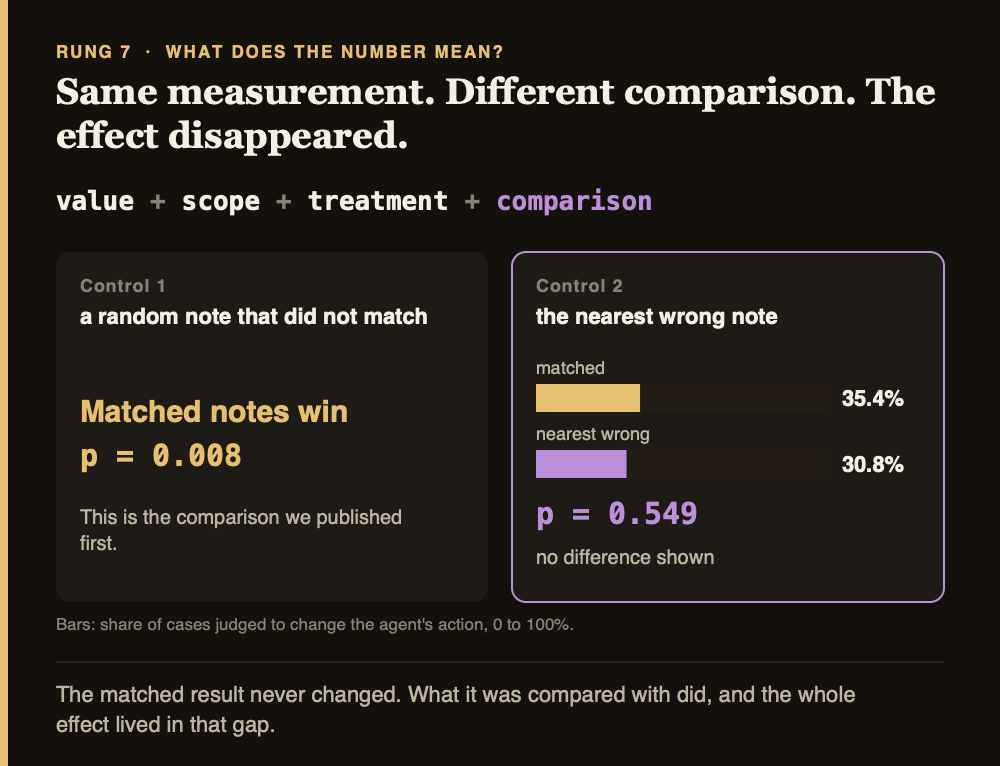
저자는 자기 시스템이 에이전트에게 보내는 노트가 에이전트의 행동을 바꾼다는 결과를 발표한 적이 있습니다. 비교 대상은 무작위 노트였습니다. 그런데 공개 벤치마크 방식대로 대조군을 다시 만들어서, 무작위 노트 대신 가장 비슷하지만 틀린 노트와 비교했더니 효과가 사라졌습니다. 35.4% 대 30.8%, p=0.549였습니다.
측정값은 그대로였습니다. 비교 대상만 바뀌었습니다.
숨은 판단: 숫자를 무엇과 비교했는가. 그래서 범위, 처리, 비교 대상을 모두 숫자 옆에 적어야 합니다.
질문 자체에 숨은 판단 #
"모든 주장에 근거가 있다" #
이 문제는 다른 사람의 방법론을 읽다가 찾아냈습니다. 저자의 검사 중 어느 것도 이를 잡지 못했습니다. 저자의 게이트는 모든 주장에 근거가 있는지 확인하는데, 그 주장에도 근거는 있었습니다.
Pascal은 이 빈틈을 짚었습니다. 아무것도 *"이게 맞는 질문이라고 왜 믿는가?"*를 묻지 않았다는 겁니다.
저자는 한 시간도 안 돼 그 사례를 겪었습니다. 저자는 노트 전달 방식이 "시끄럽다(noisy)"고 생각해서 노이즈를 꼼꼼히 측정하고 수정안까지 만들었습니다. 아무것도 바뀌지 않았습니다.
그러다 동료가 실제로 안에서 보면 어떠냐고 물었고, 저자는 평균값 대신 실제 세션 하나를 들여다봤습니다. 시끄러운 건 없었습니다. 다만 노트 두 개가 다른 노트에 밀려 끝내 전달되지 않았습니다. 하필 저자가 그날 저녁 내내 고생하며 다시 배운 바로 그 두 가지 내용이었습니다.
Pascal의 표현으로는, 지식 베이스는 "완전하면서도 기능적으로는 불완전할 수 있습니다."
외부 검토도 같은 방식으로 실패했습니다. 두 번째 모델에게 저자의 결정을 검토하게 했는데, 날카롭고 대체로 옳았습니다. 다만 저자가 효과 없는 결과(null result)를 내놨다고 결론 내린 부분은 틀렸습니다. 반대 근거가 있었는데 저자가 검토 요청서(brief)에 빠뜨렸기 때문입니다.
Pascal은 이 둘을 깔끔하게 구분했습니다. 그 검토자는 추론은 *"독립적(independent)"*이었지만, "독립적으로 정보를 얻지는(independently informed)" 못했다는 겁니다.
숨은 판단: 어떤 질문이 물어볼 가치가 있었는가, 그리고 외부 검토자가 무엇을 볼 수 있었는가.
"무작위 배정기는 문제없다" #
저자는 노트의 10%를 무작위로 보류해서, 노트가 있을 때와 없을 때를 비교하고 있었습니다. 그런데 막상 결과를 계산해 보니 두 그룹의 로그가 파이프라인의 서로 다른 지점에서 찍히고 있었습니다.
held back   logged the moment it was held
delivered   logged only if it survived several later filters
68일 치 데이터가 한 그룹 전체와 다른 그룹의 생존자를 비교하고 있었던 겁니다. 무작위 배정기에는 아무 문제가 없었습니다. 누군가 예전에 로그 두 줄을 어디에 넣을지 정했고, 그 결정이 조용히 코드가 돼 있었습니다.
숨은 판단: 로그를 어디에 찍었는가.
저자는 답글에 "구현은 판단이 보이지 않게 숨는 곳"이라고 썼고, Pascal이 그 생각을 이어받아 마무리했습니다. 판단은 *"의식적인 선택으로 시작해서 필드가 되고, 로그 지점, 기본값, 모집단 경계, 대조군, 정렬 결정이 된다"*는 겁니다. 그리고 여섯 달쯤 지나면 그냥 원래 시스템이 그렇게 돌아가는 것처럼 보입니다.
다시 18, 34, 2로 #
둘이 이 결론에 동의하던 바로 그때, 맨 앞의 탐지기에서 같은 일이 또 일어났습니다. 대화 전체를 거친 뒤 다시 보면 이렇습니다.
| 버전 | 숫자 | '답장했다'를 조용히 어떻게 정의했나 |
|---|---|---|
| 1 | 18 | 내 답장이 상대 댓글 바로 아래에 있음 |
| 2 | 34 | 스레드에 내가 나중에 단 댓글이 하나라도 있음 |
| 3 | 2 | 두 규칙을 함께 적용 |
정확한 측정 세 개가 서로 다른 모집단 셋을 셌고, 질문은 하나였습니다.
대화에서 나온 내용 상당수가 이 표에 들어 있습니다. 버전 1은 옆에 단 답장을 볼 수 없었으니 자기가 그 답장을 놓쳤다는 사실도 알아챌 수 없었습니다. 버전마다 누군가 한 번 정한 모집단을 셌습니다. 숫자는 각각 맞았지만, 읽는 사람은 다른 질문에 대한 답으로 받아들였습니다. 그리고 단어 하나에 대한 판단이 코드 속에서 원래 시스템이 그렇게 돌아가는 것처럼 자리 잡고 있었습니다.
정리해 보면 나오는 아홉 가지 질문 #
대화가 끝난 뒤에는 이 내용을 목록으로 정리할 수 있었습니다. 저자도 초고에서 실제로 그렇게 했습니다.
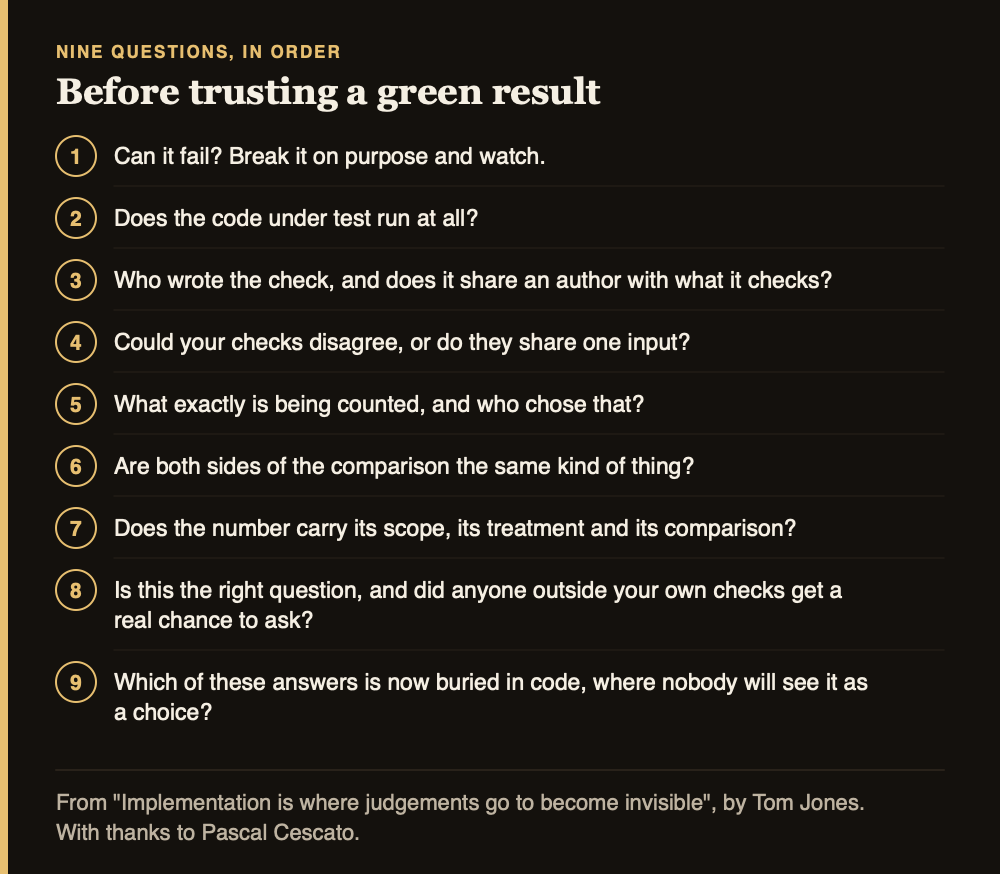
- 실패할 수 있는가? 일부러 망가뜨려 보고 지켜본다.
- 테스트 대상 코드가 실행되기는 하는가?
- 검사는 누가 작성했고, 검사 대상과 작성자가 같은가?
- 검사끼리 서로 다른 결과를 낼 수 있는가, 아니면 같은 입력을 공유하는가?
- 정확히 무엇을 세고 있고, 그건 누가 정했는가?
- 비교하는 양쪽이 같은 종류의 대상인가?
- 숫자에 범위, 처리, 비교 대상이 같이 적혀 있는가?
- 이게 맞는 질문인가? 내 검사 바깥의 누군가가 제대로 물어볼 기회를 얻었는가?
- 이 답들 중 무엇이 이미 코드 속에 묻혀서 아무도 선택이라고 보지 않게 됐는가?
초고를 검토한 Pascal이 문제를 짚었습니다. 두 사람은 아홉 가지 질문을 먼저 정해 놓고 아홉 사례에 적용한 게 아닙니다. 끝난 것처럼 보이는 답을 찾고, 그 안에 숨은 판단을 찾아내는 일을 계속 반복했을 뿐입니다.
깔끔한 목록은 이 글이 경계하는 바로 그런 종류의 도구입니다. 목록을 쓰되, 목록도 무언가를 숨기고 있을 거라고 생각해야 한다는 게 저자의 당부입니다.
쓸모 있는 항목들은 대부분 코드 한 줄이면 됩니다. 결과 옆에 개수를 찍고, 두 모집단이 일치하는지 assert를 걸고, 뮤턴트를 한 번 돌려 보면 됩니다. 어려운 항목들은 자동화한다고 사라지지 않습니다. 판단이 더 보기 힘든 곳으로 옮겨 갈 뿐입니다.
다음 단계 #
무작위 배정 사례의 로깅은 이제 고쳐서 양쪽이 같은 지점에서 기록됩니다. 저자가 다음에 할 일은 노트 단위 분석입니다. 노트마다 그 노트가 경고하는 특정 실수가 얼마나 자주 일어나는지를, 노트가 전달됐을 때와 보류됐을 때로 나눠 비교할 계획입니다. 그러면 "노트가 필요한 순간에 도착했는가"라는 질문을 계산으로 확인할 수 있습니다.
다만 탐지할 실수를 제대로 골랐는지는 이 계산으로도 알 수 없습니다. 그건 여전히 판단이고, 저자는 그 판단도 로그 위치처럼 코드 속에 숨어들 거라고 예상합니다.
저자는 둘 중 누구도 혼자서는 이 문제들 대부분을 찾지 못했을 거라고 말합니다. 이 글 자체가 Pascal Cescato와 두 달 동안 나눈 대화에서 나왔고, 초고 검토도 Pascal이 맡았습니다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.