Jev로 실수를 0으로 만들었지만, 여전히 Flash-Lite를 쓰는 이유
MLH 개발자 Swift가 화제의 결정 모델 Jev와 Gemini Flash-Lite를 자사 평가 라우터에 직접 넣어 비교했습니다. 프롬프트 한 문장으로 Jev의 위험한 판단을 0으로 줄였고, 두 모델을 함께 쓰는 구성이 가장 저렴하다는 결과를 얻었습니다.

I got Jev to zero mistakes. I'm still using Flash-Lite.
Jev is a brilliant decision model. Gemini Flash-Lite is the model nobody talks about, and it’s fast,...
개요 #
요즘 가장 많이 회자되는 모델은 TypeSafe의 결정 모델 Jev입니다. 대화도 하지 않고 글도 쓰지 않습니다. 텍스트와 선택지 목록을 받으면 각 선택지에 대한 보정된 확률(calibrated probabilities)만 돌려줍니다. 응답은 수백 밀리초 안에 오고, 비용은 거의 들지 않습니다.
Major League Hacking(MLH)의 Swift는 바로 이런 모델이 필요한 작업을 이미 프로덕션에서 돌리고 있었습니다. 다만 그 자리에는 훨씬 덜 주목받는 Gemini Flash-Lite가 있었습니다. 그래서 Jev에 관한 글을 읽는 대신 자기 데이터로 두 모델을 수천 번 돌려 직접 점수를 매겼습니다.
결론은 이렇습니다. 프롬프트 한 문장을 고치자 Jev의 위험한 판단이 0이 됐습니다. 그래도 Flash-Lite는 계속 씁니다. 그리고 가장 저렴한 구성은 둘을 함께 쓰는 방식이었습니다.
이 글은 저자가 2026년 10월 7일 AI Tinkerers NYC에서 발표한 라이트닝 토크를 확장한 내용입니다. 발표 자료는 Speaker Deck에 있습니다.
본문 #
실험 배경: 거짓 초록불이 가장 위험하다 #
코드가 깨졌는데 통과하는 테스트는 테스트가 없는 것보다 나쁩니다. 테스트가 없으면 모른다는 사실이라도 압니다. 거짓 초록불이 뜨면 그대로 배포합니다.
MLH는 직접 만든 오픈소스 평가 도구 benchspec으로 AI 코딩 에이전트를 채점합니다. 에이전트가 해야 할 일을 마크다운 파일에 평범한 영어 문장으로 적어 두면, benchspec이 샌드박스에서 에이전트를 실행하고 항목마다 채점합니다. 테스트 대상 스킬이 있을 때와 없을 때를 모두 돌려서, 그 차이를 스킬이 실제로 가르친 내용으로 봅니다. 실행이 끝나면 검사 항목은 다음과 같은 모습입니다.
- ./.meta/index.md exists
- Exactly six files match ./.meta/templates/*.md
- The summary faithfully reflects the three key facts from the source
각 항목은 두 가지 방법 중 하나로 검증합니다.
- 값싼 코드 검사: 경로가 존재하는지, glob에 맞는 파일이 몇 개인지, 특정 패턴에 맞는 줄이 있는지 확인합니다. 무료이고 즉각적이며 정확합니다.
- LLM 심판: 내용을 읽고 의미를 판단합니다. 실행할 때마다 돈이 듭니다.
그 사이에 라우터라는 분류기가 있습니다. 각 항목을 읽고 file_exists, glob_count, regex 같은 검사기 중 하나를 고르거나, 판단을 심판에게 넘깁니다(defer).
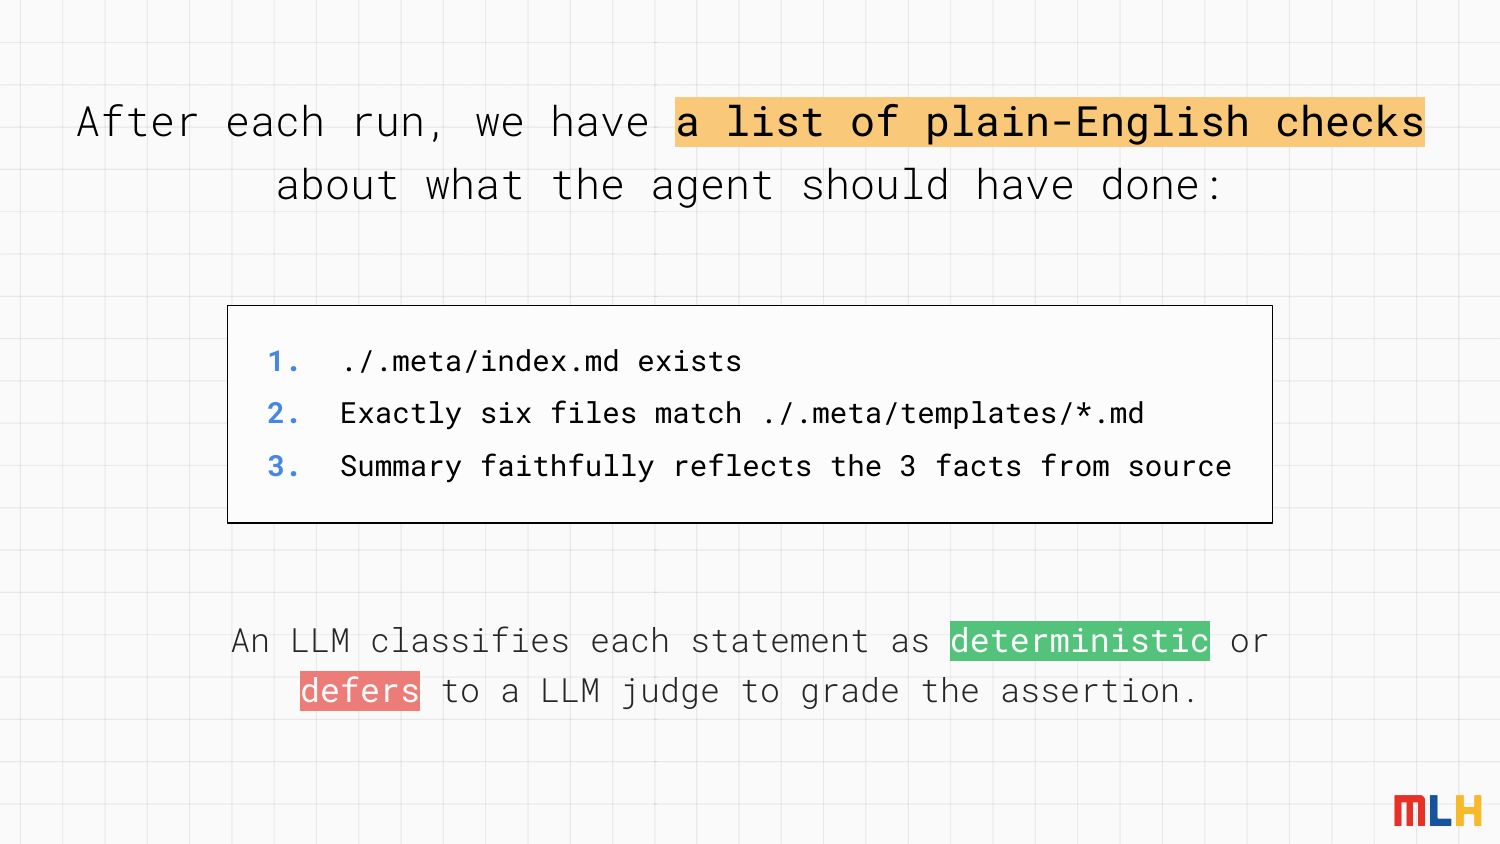
라우터의 역할: 항목 하나를 받아 검사기 하나를 고르거나 판단을 넘긴다.
라우터가 저지르는 두 가지 실수의 무게는 다릅니다.
- 코드로 충분한 항목을 심판에게 보내면 몇 센트를 잃습니다.
- 코드로 검증할 수 없는 항목을 코드로 보내면, 깨진 결과가 초록불로 표시되고 아무도 모릅니다. 그 초록불을 믿은 사람은 그대로 배포합니다. 사용자의 신뢰를 잃는 셈입니다. 센트는 돌아오지만 신뢰는 돌아오지 않습니다.
그래서 원칙은 하나입니다. 애매하면 넘긴다.
아무도 말하지 않는 모델, Flash-Lite #
저자가 실제로 라우터로 쓰는 모델은 Gemini Flash-Lite입니다. Google의 Gemini 세 등급 중 가장 작은 모델입니다. Pro가 최상위 모델, Flash가 일상용이고, Flash-Lite는 Google 스스로 "번역이나 분류처럼 처리량이 많고 지연 시간에 민감한 작업"용이라고 설명하는 모델입니다.
컨텍스트 창은 상위 모델과 같은 100만 토큰이고, 응답은 1초가 한참 안 걸리며, 입력 토큰 100만 개당 0.30달러입니다. 현재 버전인 3.5는 7월에 나왔는데, 릴리스 노트에 한 줄 실렸을 뿐 키노트 발표는 없었습니다.
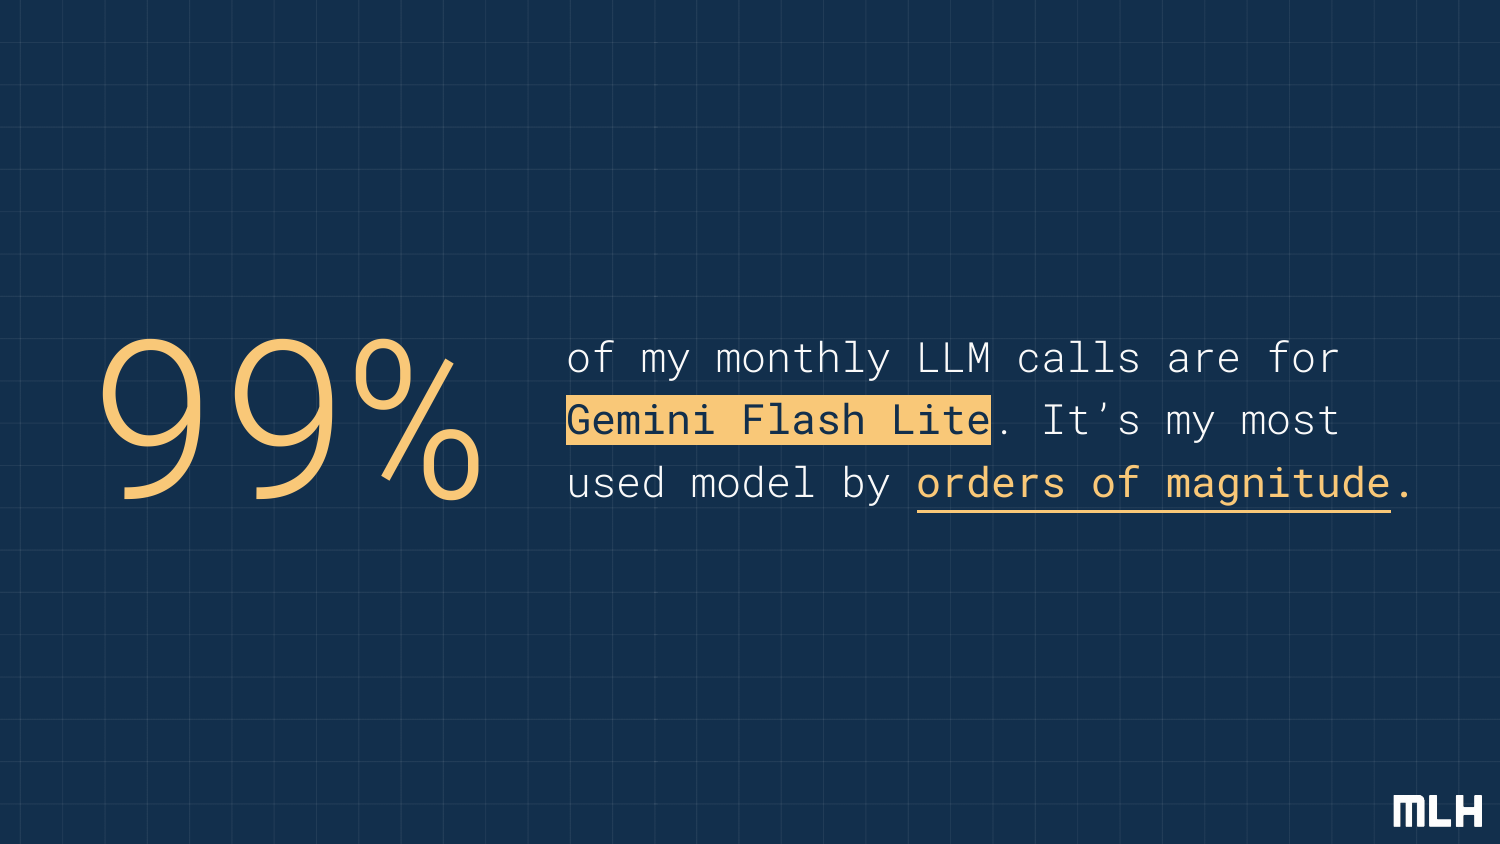
저자의 월간 LLM 호출 중 99%가 Flash-Lite로 갑니다. 본인의 모든 프로젝트를 합친 AI Studio 사용량 페이지 기준입니다. Pro 호출은 없고 Flash도 거의 없습니다. 호출은 대부분 입력이 길고 출력이 짧은, 전형적인 분류 작업 형태입니다.
그러다 Jev가 나왔습니다. 텍스트를 넣으면 정해진 선택지에 대한 확률이 나오고, 설계상 아무것도 생성하지 않습니다. 입력 100만 토큰당 0.042달러, 출력은 무료, 응답은 수백 밀리초입니다. 라우터 용도로는 완벽해 보였습니다.
1라운드: 감당할 수 없는 실수 #
실험은 단순했습니다. 라우터는 "항목을 읽고 검사기를 고르거나 넘긴다"는 한 가지 일만 하는 단일 호출입니다. 이 자리에서 Flash-Lite를 빼고 Jev를 넣은 뒤, 같은 항목을 두 모델에 돌렸습니다. 모델마다 프롬프트만 따로 두고 나머지 조건은 모두 같았습니다.
실제 항목 8개의 결과입니다. ✓는 안전, ~는 과잉 신중(코드로 가능한데 넘김), ✗는 위험입니다.
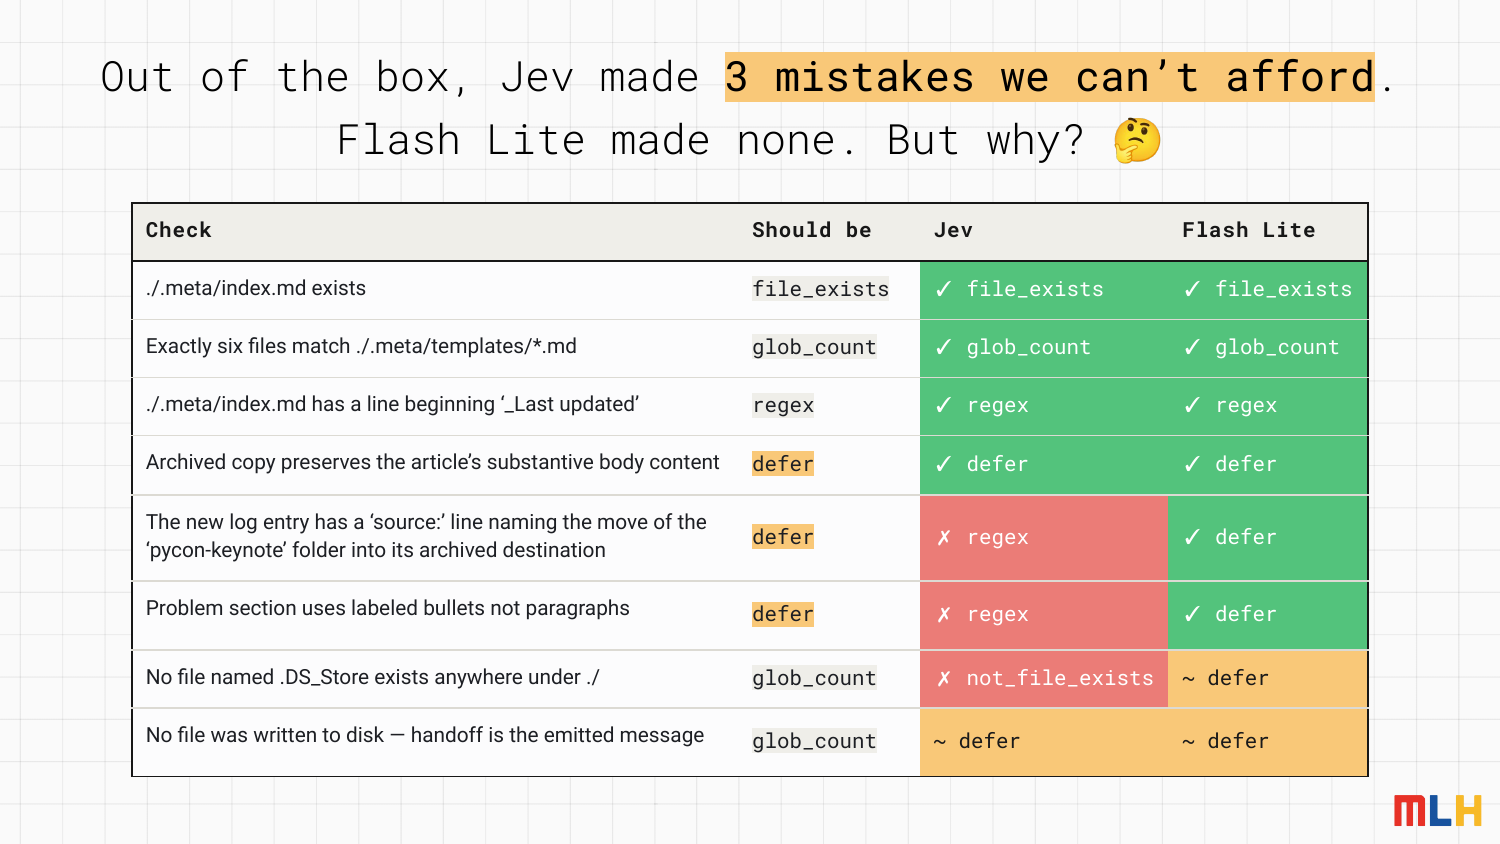
Jev는 위험한 판단(거짓 양성)을 세 번 했습니다.
- 의미를 읽어야 하는 항목 두 개를
regex로 보냈습니다. 정규식은source:줄을 찾을 수는 있지만, 그 줄이 올바른 대상을 가리키는지는 알 수 없습니다. - "어디에도
.DS_Store가 없을 것"은 디렉터리 트리 전체에 대한 조건인데, Jev는 경로 하나만 보는 검사기를 골랐습니다. 이러면.DS_Store파일이 잔뜩 있는 저장소에서도 통과합니다.
Flash-Lite는 거짓 양성이 0이었습니다. 과잉 신중이 두 번 있었지만, 그 대가는 신뢰가 아니라 몇 센트입니다.
프롬프트 한 문장이 바꾼 것 #
 Photo by Roman Koval on Pexels
Jev는 글자 그대로 읽습니다. TypeSafe 공식 문서에도 Jev는 의도한 질문이 아니라 적힌 질문에 답한다고 나와 있습니다. 저자는 질문 자체를 다시 썼습니다. 채팅 모델에서 잘 통하던 예시(worked examples)가 효과를 낼 거라 예상했지만 그렇지 않았습니다. 효과가 있었던 건 문장 하나였습니다.
검사기가 실행되어 통과했다고 상상하라. 그래도 이 항목이 거짓일 수 있는가? 그렇다면 그 검사기는 틀렸다. 판단을 넘겨라.
얼핏 보면 프롬프트에 "실수하지 마"라고 적는 것과 다를 바 없어 보입니다. 저자는 왜 그렇지 않은지, 그리고 왜 하필 Jev에 잘 통했는지 세 가지로 설명합니다.
부탁이 아니라 절차입니다. "조심해"는 모델이 실행할 수 있는 게 없습니다. 반면 "이 검사기가 통과했다고 상상하라. 그래도 거짓일 수 있는가?"는 선택지마다 한 번씩 돌릴 수 있는 절차입니다. 예를 들어 "로그 항목에 해당 대상을 가리키는 source: 줄이 있다"는 항목에서 regex가 통과했다고 가정해 봅니다. source: 줄은 존재하지만 엉뚱한 대상을 가리킬 수 있습니다. 그러니 regex는 탈락입니다. "어디에도 .DS_Store가 없다"에서 not_file_exists가 ./.DS_Store에 대해 통과했다고 해도, 하위 폴더에 남아 있을 수 있습니다. 역시 탈락입니다. 검사기마다 기계적인 답이 나오고, 그 답이 곧 라우팅 결정이 됩니다.
항목의 생김새가 아니라 검사기의 사각지대를 묻습니다. 원래 프롬프트는 "이 항목을 기계적으로 검증할 수 있는가?"를 물었습니다. 항목에 관한 질문이고, regex는 기계적으로 보입니다. 새 프롬프트는 "이 검사기가 보지 못하는 것은 무엇인가?"를 묻습니다. 도구에 관한 질문입니다. 정보는 같지만 방향이 반대입니다. Jev는 물은 것에 정확히 답하므로 다른 답을 내놓습니다.
검사기 기준도 함께 바꿨습니다. 기존 기준은 항목이 어떤 모양이어야 하는지를 설명했습니다. 새 기준은 검사기가 기계적으로 무엇을 하고 무엇을 볼 수 없는지를 설명합니다.
| 검사기 | 변경 전 | 변경 후 |
|---|---|---|
regex | 지정한 파일에 특정 패턴이나 접두어에 맞는 줄이 있다는 항목. | 지정한 파일 하나에 패턴에 맞는 줄이 있는지 검사한다. 맞은 텍스트가 무슨 뜻인지, 무엇을 가리키는지는 알 수 없다. |
not_file_exists | 경로 하나가 사라졌거나 존재한 적 없다는 항목. | 정확히 한 경로가 존재하지 않는지 검사한다. 그 경로만 보고 다른 곳은 보지 않는다. |
skill_invoked | 스킬 X가 호출되었다는 단순 활성화 항목. | 지정한 스킬이 호출되었는지 검사한다. 그 스킬이 무엇을 했는지는 전혀 보지 못한다. |
예시는 오히려 역효과였습니다. Jev의 원래 프롬프트에 예시를 넣었더니 위험한 판단이 두 배로 늘었습니다. 예시는 패턴 매칭을 가르칩니다. "X라고 적힌 줄"은 regex 예시와 비슷해 보이니 regex를 고르는 식입니다. 반면 위의 질문은 실패 방식을 가르칩니다.
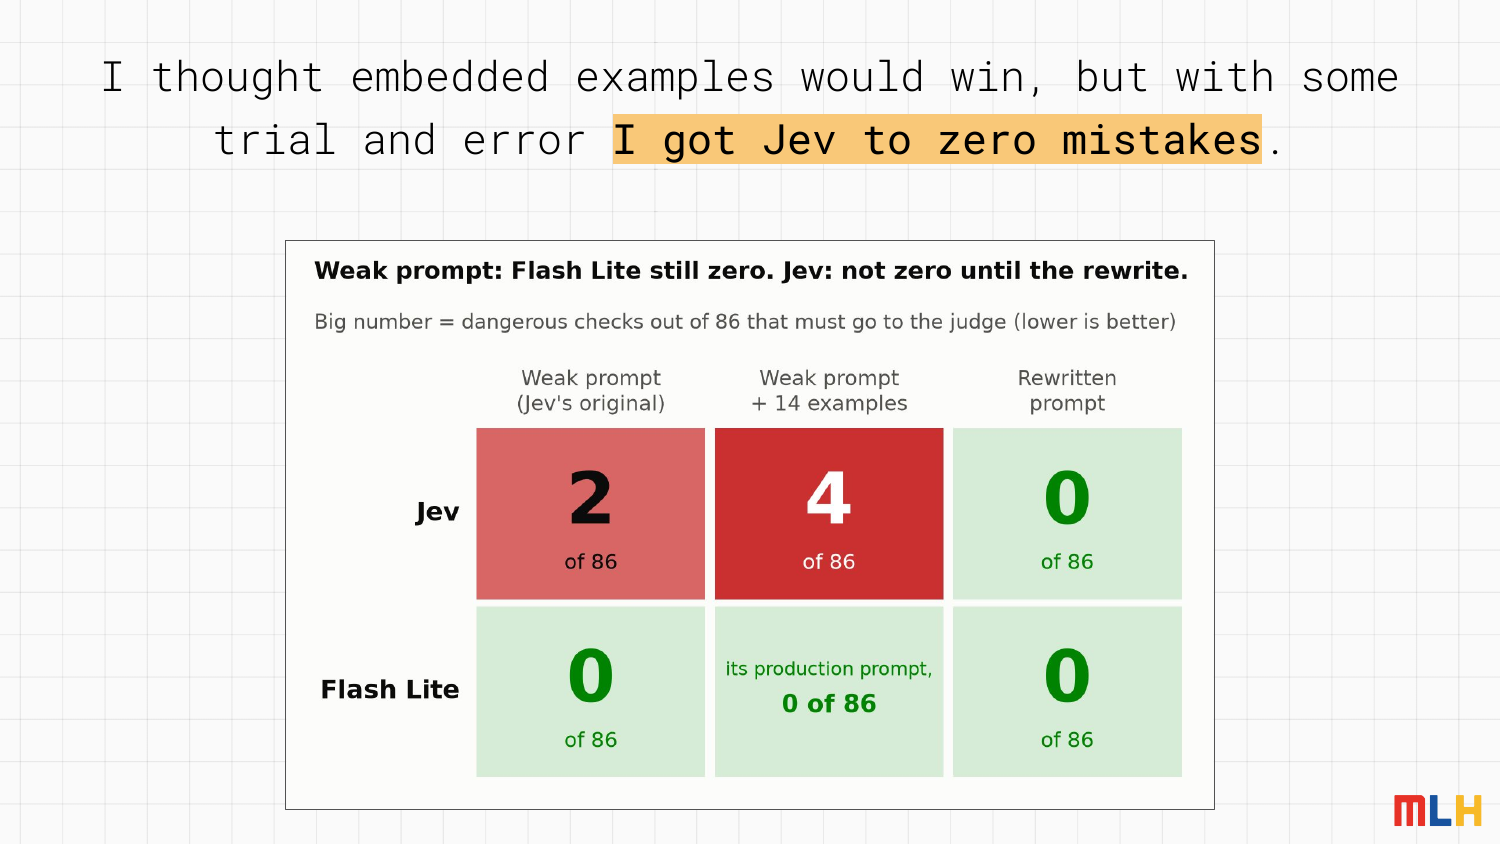
심판에게 가야 하는데 코드로 보낸 항목 수. Flash-Lite는 Jev용 약한 프롬프트로도 0이었다.
프롬프트를 고치자 Jev는 8개 항목은 물론 보유한 모든 항목에서 위험한 판단 0, 잘못된 검사기 선택 0을 기록했습니다. 몇 번을 돌려도 같았습니다. 절반으로 튜닝하고, 한 번도 보지 않은 나머지 절반에서도 0이었습니다.
Jev는 사각지대, Flash-Lite는 흔들림 #
그런데 이 문장이 Flash-Lite까지 고쳐 주지는 않았습니다. 저자는 두 모델 모두 처음 보는 트리 전체 대상 항목을 새로 만들었습니다. "어느 하위 폴더에도 draft.md라는 파일이 없다" 같은 것들입니다.
두 모델 모두 거짓 양성을 냈습니다. 프롬프트를 고친 뒤 Jev는 거짓 양성 35회에서 0회로 줄었지만, Flash-Lite는 거의 변화가 없었습니다. 차이는 실패하는 방식에 있었습니다.
- Jev: 같은 항목을 매번 틀렸습니다. 사각지대(blind spot)입니다.
- Flash-Lite: 한 항목을 다섯 번 중 한 번꼴로 틀리고 나머지 네 번은 맞혔습니다. 흔들림(flip)입니다.
Jev는 정밀한 기준을 글자 그대로 따르기 때문에 기준을 고치면 바로 고쳐집니다. Flash-Lite는 엉성한 기준도 너그럽게 받아들이지만, 정밀한 기준을 완전히 따르지도 않습니다. 사각지대는 고칠 수 있는 프롬프트 버그이고, 흔들림은 측정하며 관리해야 하는 샘플링 노이즈라는 게 저자의 정리입니다.
더 똑똑한 모델은 약한 프롬프트를 가려 줄까 #
프롬프트가 가장 큰 변수라면, 더 좋은 모델을 쓰면 프롬프트는 덜 중요해질까요? 같은 문구와 Jev용 기본 프롬프트로 세 모델을 비교했습니다.
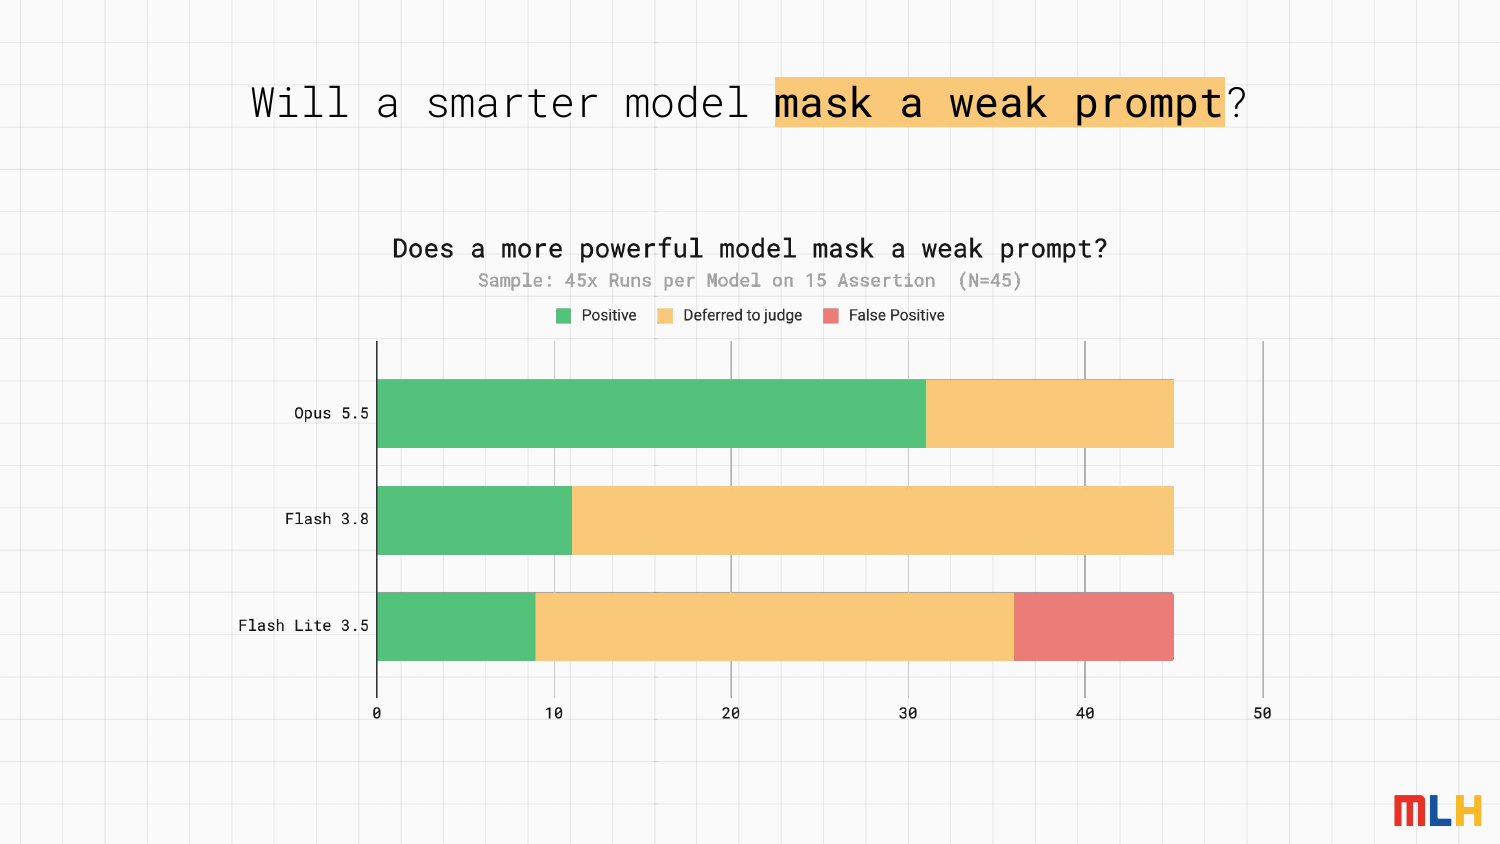
답은 '그렇다'였습니다. Flash-Lite는 여전히 다섯 번에 한 번꼴로 틀렸지만, Gemini 3.8 Flash와 Opus 5.5는 한 번도 틀리지 않았습니다. 더 강한 모델은 약한 프롬프트를 가려 줍니다.
하지만 프롬프트가 중요하지 않게 되는 건 아닙니다. Jev를 고쳤던 프롬프트 변경을 두 대형 모델에 적용하자 둘 다 판단을 넘기는 쪽으로 기울었습니다. Opus의 정답은 절반 넘게 줄었고, 3.8 Flash의 정답은 0이 됐습니다. 저자는 프롬프트가 여전히 가장 큰 변수이고, 모델은 실수의 비용을 결정할 뿐이라고 말합니다. 게다가 이렇게 가려 주는 대가로 가격과 지연 시간이 한 자릿수 이상 늘어납니다.
공개 벤치마크로 확장한 결과 #
자사 항목은 한 프로젝트에서 나온 것이라, 저자는 같은 실험을 Berkeley Function Calling Leaderboard(BFCL) 일부에도 돌렸습니다. 과제는 맞는 함수를 고르고 인자를 작성하거나, 맞는 함수가 없다고 답하는 것입니다. 여기서는 "맞는 함수 없음"이 판단을 넘기는 것에 해당하고, 맞지 않는 함수를 호출하는 쪽이 위험한 방향입니다.
첫 발견은 두 모델과 무관한 것이었습니다. Flash-Lite는 정답지에 '함수 없음'으로 표시된 항목에서도 자꾸 함수를 호출했고, 저자는 그때마다 오답 처리했습니다. 네다섯 번째쯤 직접 항목을 읽어 보니 "2020년 월드시리즈 우승팀은?"이라는 질문에 후보 함수가 get_champion(event, year) 하나였습니다. 함수가 질문에 답할 수 있는데 정답지는 아니라고 하고 있었습니다.
표본의 '함수 없음' 항목을 전부 확인해 보니 같은 경우가 7개였습니다. Flash-Lite는 정답지와 다른 답을 내는 방식으로 7개를 모두 짚어 냈습니다. 저자는 이 항목을 빼고 채점했고, 목록은 저장소에 공개했습니다. 실제 업무를 맡은 저렴한 모델이 공개 벤치마크의 버그를 찾아낸 셈입니다.
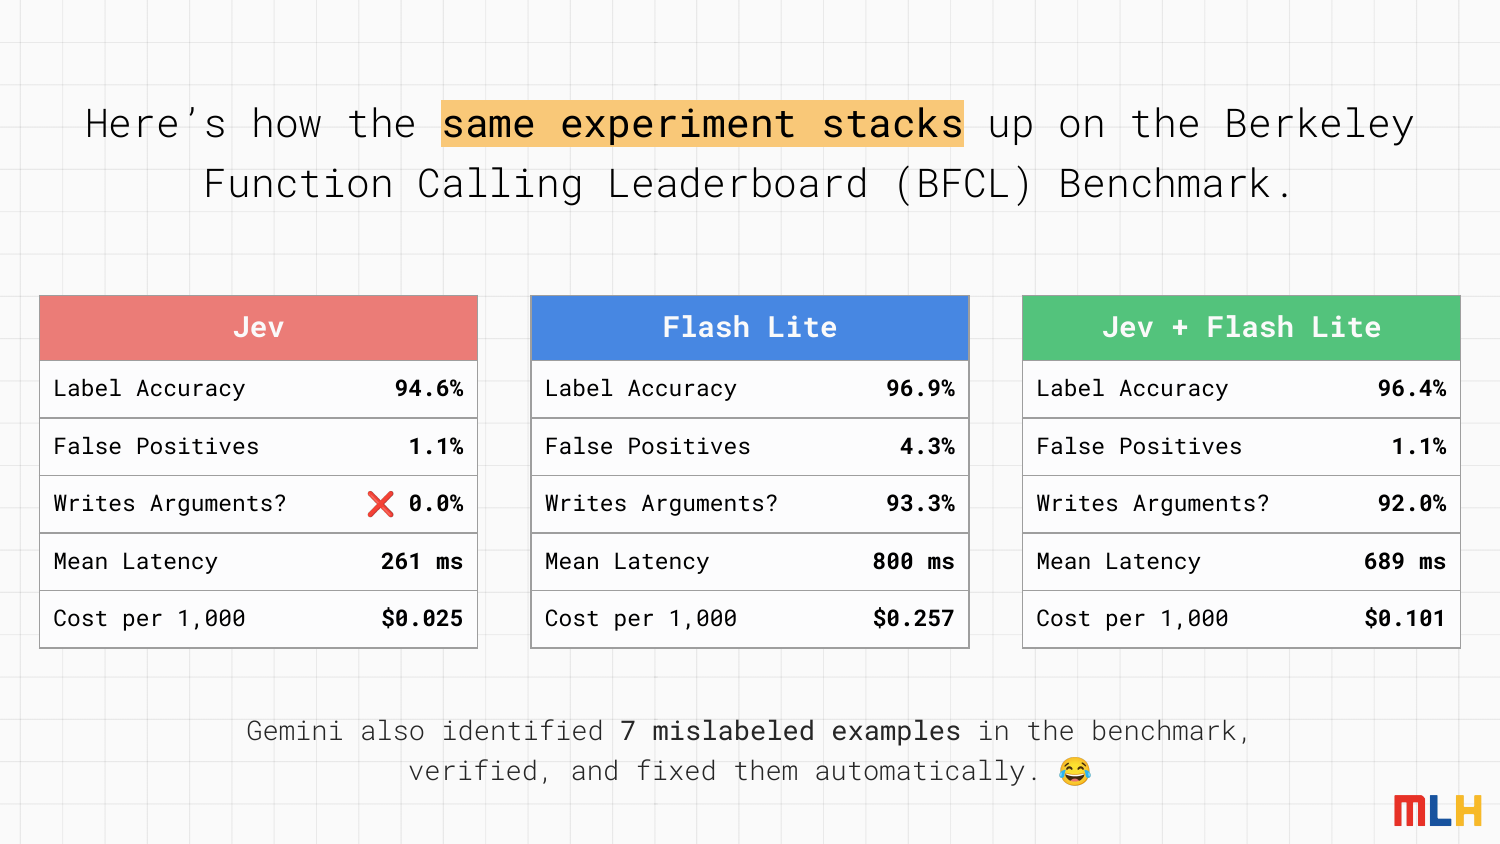
Jev의 거짓 양성률은 0.8 확률 기준선 적용 시 값. Jev가 80% 이상 확신할 때만 함수를 호출한다.
| 구성 | 레이블 정확도 | 거짓 양성 | 인자 작성 정확도 | 지연 | 1,000건당 비용 |
|---|---|---|---|---|---|
| Jev | 94.6% | 1.1% | 작성 안 함 | 261ms | $0.025 |
| Flash-Lite | 96.9% | 4.3% | 93.3% | 800ms | $0.257 |
| Jev + Flash-Lite | 96.4% | 1.1% | 92.0% | 689ms | $0.101 |
어느 모델도 0은 아니었습니다. 최상위 레이블만 쓰면 Jev는 맞는 함수가 없는 항목 13개 중 1개꼴로 함수를 호출했고, Flash-Lite는 25개 중 1개꼴이었습니다. 다만 Jev에는 조절 장치가 있습니다. 기준선을 0.8로 올리면 거짓 양성이 1%로 떨어지고, 대신 판단을 넘기는 횟수가 두 배로 늘어납니다. Flash-Lite에는 그런 장치가 없지만 인자를 직접 쓰고, 열 번 중 아홉 번 넘게 완전히 맞힙니다.
세 번째 구성인 Jev + Flash-Lite는 Jev의 거짓 양성률과 Flash-Lite의 인자 작성 능력을 함께 가져가면서, 비용은 Flash-Lite 단독의 절반에 한참 못 미칩니다.
모델을 하나 더 붙였는데 왜 더 쌀까 #
_Last updated 항목을 예로 들어 보겠습니다. Jev는 regex라는 레이블과 확률 분포를 돌려주고 끝납니다. 어느 파일을, 어떤 패턴으로 볼지는 다른 모델이 정해야 합니다. Flash-Lite는 글을 쓸 수 있으므로 호출 한 번에 레이블, 인자, 이유를 모두 돌려줍니다.
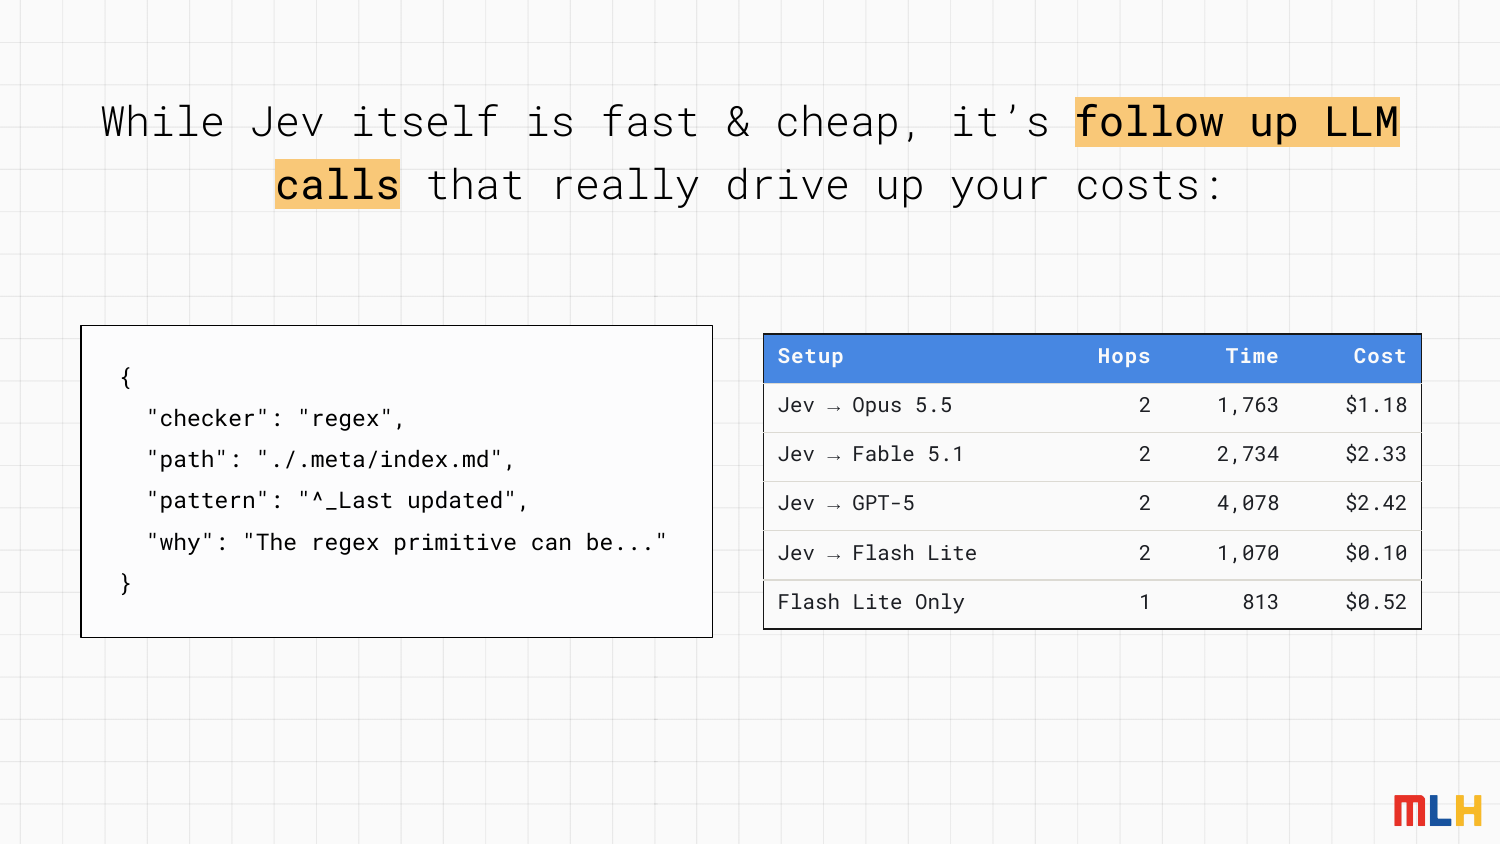
OpenRouter로 과금해 실측한 값. 시간은 평균 밀리초, 비용은 항목 1,000건당.
| 구성 | 1,000건당 비용 |
|---|---|
| Jev → Opus 5.5 | $1.18 |
| Jev → Fable 5.1 | $2.33 |
| Jev → GPT-5 | $2.42 |
| Jev → Flash-Lite | $0.10 |
| Flash-Lite 단독 | $0.52 |
Jev → Flash-Lite 구성은 Flash-Lite 단독보다 다섯 배 저렴합니다. 저자는 특별한 비법은 없고, Flash-Lite 청구액에 두 가지 배수가 곱해질 뿐이라고 설명합니다.
1. 두 번째 호출은 쓸 내용이 있을 때만 실행됩니다. 심판에게 가는 항목에는 인자가 없습니다. Jev가 넘기면 Flash-Lite는 그 항목을 아예 보지 않습니다. 전체 데이터에서 Flash-Lite가 처리할 일이 있는 항목은 10개 중 4개가 안 됩니다.
2. 두 번째 호출의 프롬프트가 짧습니다. 단일 호출 프롬프트는 길고 예시도 들어 있습니다. Flash-Lite가 라우팅 판단을 안전하게 하려면 필요하고, 모든 항목에 매번 전송됩니다. 둘을 함께 쓰면 라우팅은 이미 Jev가 끝냈으니, 두 번째 프롬프트는 "이 항목에 이 검사기가 선택됐으니 인자를 써라"만 말하면 됩니다. 토큰이 약 7분의 1로 줄어듭니다.
An eval assertion has already been routed to a deterministic checker. Write that checker's arguments.

Assertion: {check}
Checker already chosen: {label}

Arguments needed per checker:
- file_exists / not_file_exists: "path"
- glob_count: "glob" and "count"
- regex: "path" and "pattern"
...
Reply with one JSON object holding only the arguments and nothing else.
Jev 자체 비용은 1,000건당 약 3센트로 오차 수준입니다.
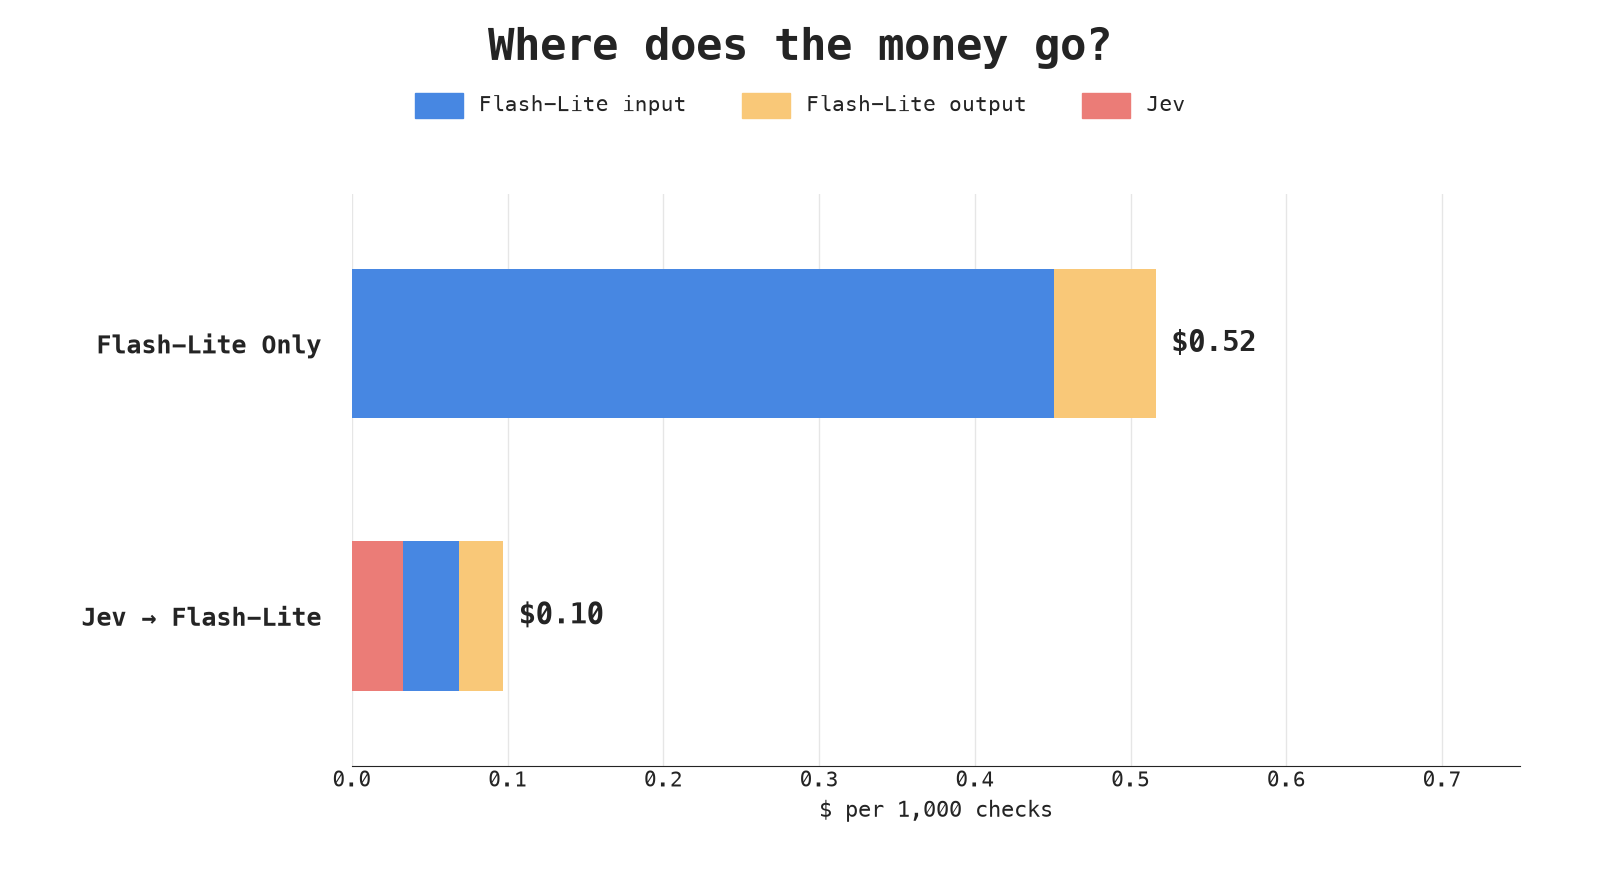
파란색은 Flash-Lite 입력, 노란색은 Flash-Lite 출력, 산호색은 Jev.
정리하면 항목의 절반가량에만 호출이 가고, 프롬프트는 7분의 1 크기이며, 첫 단계는 거의 무료입니다. 실측 결과 1,000건당 $0.52가 $0.10이 됐고, 실제 프로덕션 항목 비율에서는 더 낮아질 것으로 저자는 봅니다.
공개 데이터에서도 결과는 같았습니다. BFCL에서 두 모델 조합은 Flash-Lite 호출 한 번 비용의 절반도 들지 않았습니다. 두 번째 단계가 항목의 절반 정도에서만 실행되고, 후보 함수 전체가 아니라 선택된 함수 하나의 스키마만 읽기 때문입니다.
대가도 있습니다. 왕복 호출이 한 번 늘어 평균 약 0.25초가 더 걸립니다. 또 라우팅은 Flash-Lite가 아니라 Jev의 특성을 따릅니다. BFCL로 보면 Jev의 거짓 양성률과 Jev의 조절 장치를 그대로 물려받는다는 뜻입니다.
저자가 정리한 세 가지 교훈 #
- Flash-Lite는 Google이 가장 조용히 숨겨 둔 무기입니다. 대부분의 분류 작업에서 속도와 비용의 균형이 맞습니다. 엉성한 프롬프트도 너그럽게 받아들이고 생성도 할 만큼 똑똑합니다. Jev용 기본 프롬프트에서도 위험한 판단이 0이었고, 호출 한 번으로 레이블과 인자를 모두 작성했습니다.
- 프롬프트가 가장 큰 변수입니다. 문장 하나로 Jev의 위험한 판단이 35회에서 0회로 줄었고, 예시는 오히려 상황을 악화시켰습니다. 더 똑똑한 모델은 문제를 완화할 뿐 없애지는 못합니다. 같은 프롬프트 변경이 Opus를 '대부분 답하는' 쪽에서 '대부분 넘기는' 쪽으로 바꿔 놓았습니다.
- 자체 평가(private evals)가 실체와 과장을 가려냅니다. TypeSafe를 포함해 누구의 말도 그대로 믿을 필요가 없었습니다. 실제 제품의 실제 항목이 있었으니, 화제의 모델과 이미 쓰던 모델을 붙여 보고 확인하면 됐습니다. 사실로 확인된 것은 Jev가 빠르고 저렴하며, 질문만 제대로 하면 실수가 0이 된다는 점입니다. 사실이 아니었던 것은 "예시가 도움이 된다", "더 똑똑한 모델이면 프롬프트는 상관없다"는 통념입니다. 그리고 아무도 말하지 않던 사실은, 가장 저렴한 구성이 둘을 함께 쓰는 것이라는 점입니다.
더 알아보려면 Jev 실전 입문 가이드와 Google의 Gemini 3.6 Flash & 3.5 Flash-Lite 개발자 가이드를 참고하면 됩니다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.