기억은 학습이 아니다: AI 에이전트가 같은 실수를 반복하는 이유 (Memory Isn't Learning)
AI 에이전트에 맥락을 더 많이 넣는다고 판단력이 좋아지지는 않습니다. Sparsh Jain은 사실과 경험을 나누고, 기억을 학습 루프로 설계해야 한다고 말합니다.

Memory Isn’t Learning: Why AI Agents Keep Making the Same Mistakes
Have you ever told your AI agent something important, only to realize a few conversations later that...
개요 #
AI 에이전트에게 중요한 내용을 알려줬는데 몇 번 대화하고 나니 까맣게 잊어버렸던 경험, 한 번쯤 있을 겁니다. 그래서 또 알려주고, 또 알려줍니다.
Sparsh Jain은 이 문제를 "기억"이 아니라 "학습"의 문제로 봅니다. 업계는 에이전트에 더 긴 컨텍스트 창과 벡터 데이터베이스를 붙이는 데 집중하고 있지만, 그가 직접 평가해 보니 맥락을 늘린다고 성능이 꾸준히 좋아지지는 않았고 오히려 떨어지는 설정도 있었습니다. 그가 던지는 질문은 하나입니다. 우리는 더 많이 기억하는 에이전트를 만드는가, 실제로 나아지는 에이전트를 만드는가?
본문 #
팀원이 바뀌면 처음부터 다시 #
글쓴이는 몇 달 전 한 헤지펀드 디렉터와 나눈 대화를 소개합니다. 그 디렉터의 고민은 이랬습니다.
"에이전트를 학습시키지 못하는 게 문제가 아닙니다. 팀의 다른 사람이 쓰기 시작하면 모든 게 0으로 돌아간다는 게 문제죠."
사람은 이렇게 일하지 않습니다. 시니어 애널리스트가 매일 아침 백지에서 출발하던가요? 어려운 사례를 다루고, 실수하고, 결과를 지켜보는 시간이 몇 년 쌓이면 정보보다 훨씬 값진 것이 생깁니다. 바로 판단력입니다. 어떤 신호가 중요한지, 어떤 접근이 대개 실패하는지, 그럴듯해 보이는 결정이라도 언제 한 번 더 따져봐야 하는지를 압니다.
반면 에이전트는 작업을 수천 건 처리하고도 내일 똑같은 실수를 저지를 수 있습니다.
맥락을 늘렸더니 오히려 나빠졌다 #
 Photo by Markus Winkler on Pexels
요즘 에이전트 AI를 다루다 보면 어디서나 같은 답을 듣습니다. 기억(memory)을 붙이라는 겁니다. 컨텍스트 창을 늘리고, 벡터 DB를 연결하고, 대화와 도구 호출, 실행 이력, 과거 결정을 저장합니다. 이전에 일어난 일을 모두 볼 수 있으면 더 나은 결정을 내리리라는 가정입니다.
글쓴이 팀도 처음엔 그렇게 믿었습니다. 과거 사례, 이전 실행 기록, 검색한 문서, 쌓아둔 지식을 에이전트에 계속 넣었고, 그다음 독립적인 평가를 돌렸습니다.
결과는 예상과 달랐습니다. 맥락이 많아진다고 성능이 꾸준히 오르지 않았고, 어떤 설정에서는 성능이 떨어졌습니다. 맥락을 손으로 다듬고, 지시문 구조를 바꾸고, 에이전트가 볼 내용을 신중하게 골라 봐도 마찬가지였습니다. 더 완전해 보이는 설정이 단순한 설정보다 못한 경우도 있었습니다. 그리고 정보를 하나씩 빼 나가다가 직관에 어긋나는 사실을 발견했습니다.
에이전트를 더 똑똑하게 만드는 가장 좋은 방법은, 때로는 기억할 거리를 줄여주는 것이다.
사실과 경험은 다르다 #
여기서 글쓴이는 중요한 구분 하나를 내놓습니다. 사실(facts)과 학습(learnings)은 근본적으로 다르다는 것입니다.
사실은 세상이 어떤 상태인지 알려줍니다. 어떤 고객의 계약이 다음 달에 끝난다, 어떤 API는 인증이 필요하다, 특정 저장소에 결제 서비스가 있다 같은 것들입니다. 이런 정보는 데이터베이스나 지식 그래프, 문서 저장소에 두면 됩니다.
학습은 어떻게 행동해야 하는지 알려줍니다. 예를 들면 이렇습니다.
- 운영 장애를 조사할 때는 상관없는 컴포넌트를 디버깅하기 전에 최근 배포 변경부터 확인한다.
- 두 출처가 서로 다르면, 의미상 가장 비슷한 문서보다 최근에 검증된 출처를 따른다.
단순한 사실이 아니라 경험에서 다듬어진 판단입니다. 경험이 되려면 어떤 행동을 했는지, 결과가 어땠는지, 왜 그런 결과가 나왔는지, 그 교훈을 앞으로의 결정에 반영해야 하는지까지 이해해야 합니다. 실행 로그는 에이전트가 무엇을 했는지만 말해줍니다. 경험 기억(experiential memory)은 다음번에 무엇을 왜 다르게 해야 하는지를 알려줍니다.
기억은 학습 루프로 설계해야 한다 #
쓸모 있는 기억 시스템에는 완결된 생애 주기가 필요하다고 글쓴이는 말합니다.
포착(Capture) → 평가(Evaluate) → 통합(Consolidate) → 검색(Retrieve) → 갱신(Update)
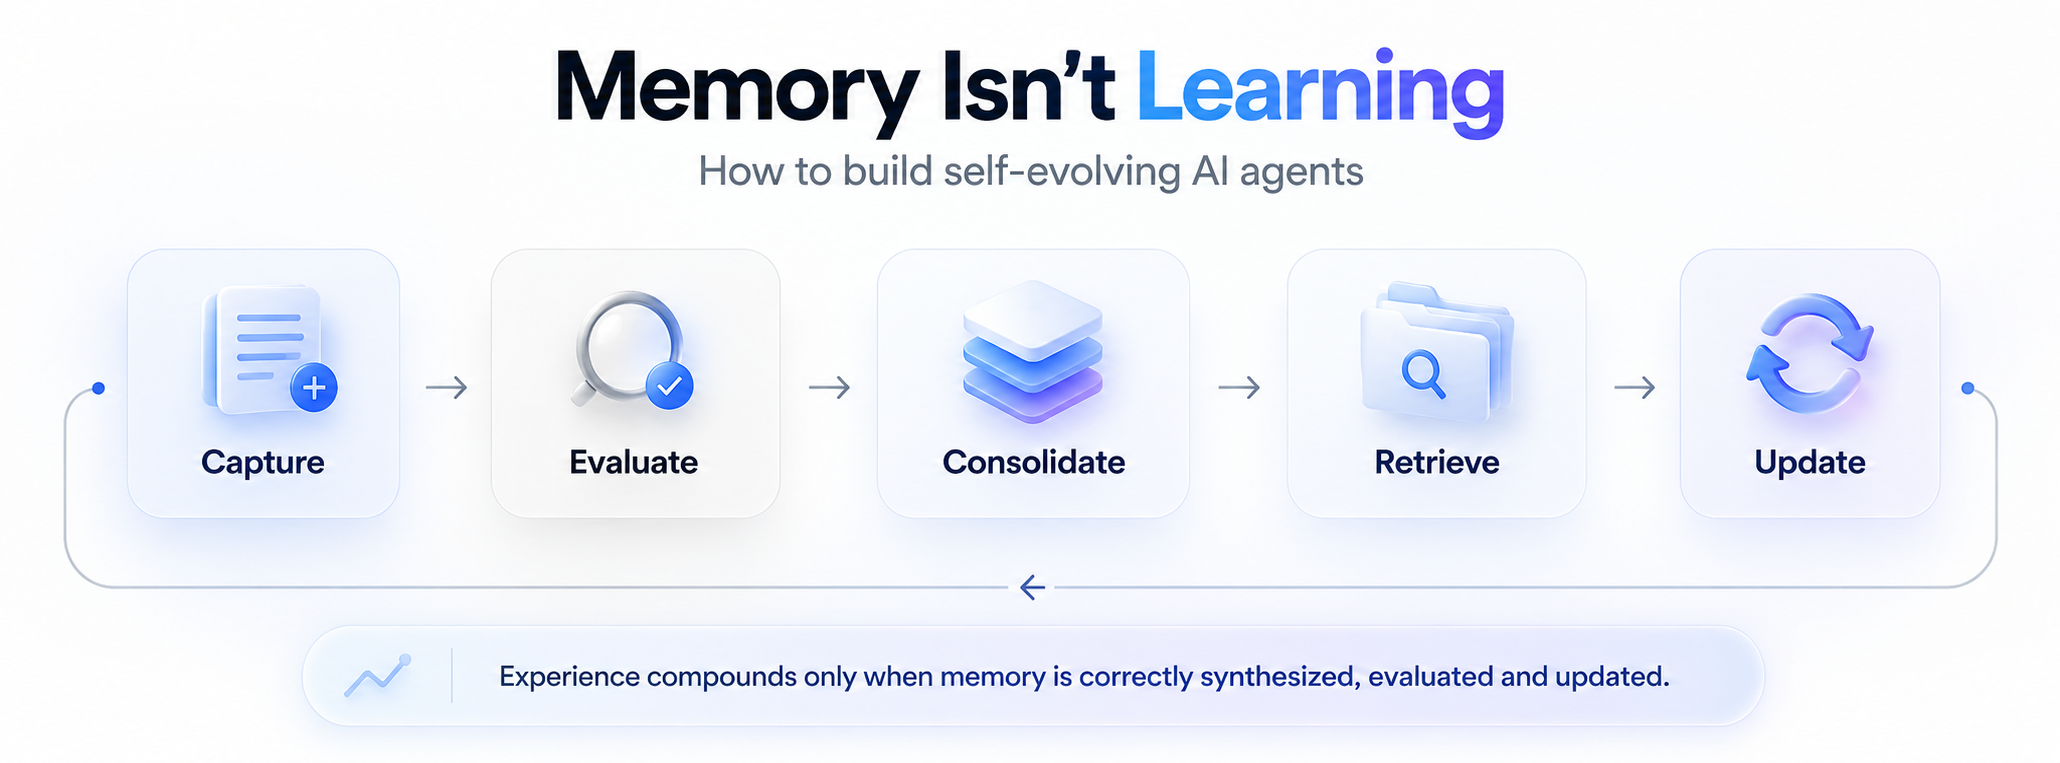
- 포착: 모든 상호작용이 아니라 의미 있는 경험만 기록합니다.
- 평가: 전략이 통했는지, 그 결과를 독립적으로 검증했는지 따집니다.
- 통합: 반복되는 경험을 재사용 가능한 교훈으로 묶습니다. 비슷한 실패 열 번이 기억 열 개로 남아서는 안 됩니다.
- 검색: 에이전트가 관련 상황을 만났을 때 맞는 교훈을 꺼내 줍니다.
- 갱신: 환경이 바뀌면 기억을 고치거나 지웁니다.
석 달 전에 잘 통하던 전략도 API나 정책이 바뀌면 위험해질 수 있습니다.
정확한 기억이라도 엉뚱한 때 꺼내면 역효과가 납니다. 그래서 글쓴이 팀은 **점진적 공개(progressive disclosure)**를 고민하기 시작했습니다. 지금 내려야 할 결정에 꼭 필요한 최소한의 정보만 주고, 추가 맥락은 필요할 때만 드러내는 방식입니다. 목표는 최대한 많이 떠올리는 게 아니라, 알맞은 순간에 알맞은 정보로 더 나은 결정을 내리는 것입니다. 글쓴이는 이런 상황에서 점진적 공개가 놀라울 만큼 잘 먹힌다고 말합니다.
기억하는 에이전트에서 나아지는 에이전트로 #
업계는 기억을 에이전트 시스템의 필수 요소로 빠르게 받아들이고 있고, 글쓴이도 여기에 동의합니다. 다만 기억 자체가 종착점은 아니라고 봅니다. 진짜 과제는 경험이 복리처럼 쌓이는 시스템을 만드는 일입니다.
에이전트가 작업을 실행하고, 결과를 관찰하고, 교훈을 뽑아내고, 검증한 뒤, 다음 결정에 적용합니다. 쓸모 있는 교훈은 더 강해지고, 낡거나 해로워진 교훈은 시스템이 고치거나 지웁니다. 시간이 지나면 에이전트는 정보를 더 쌓는 데서 그치지 않고 더 믿을 만한 의사결정 패턴을 갖추게 됩니다.
글쓴이 팀은 이 방향을 "루프 엔지니어링(Loop Engineering)"이라고 부릅니다. 평가와 기억, 피드백을 따로 떨어진 부품이 아니라 하나로 이어진 시스템으로 다루는 접근입니다.
글쓴이의 결론은 이렇습니다. 목표는 지금까지 저지른 실수를 전부 기억하는 에이전트가 아닙니다. 같은 실수를 두 번 할 필요가 없는 에이전트, 경험이 쌓일수록 나아지는 시스템을 만드는 것입니다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.