PHP 배열에 키 하나를 추가했더니 메모리 25MB가 날아갔다
PHP 8.4에서 100만 개의 정수를 담은 배열은 16.8MB지만, 문자열 키 하나를 끼워 넣는 순간 41.9MB가 된다. packed 배열과 해시 테이블의 구조 차이, 그리고 행 데이터를 담는 가장 싼 방법을 실측했다.


I Added One Key to a PHP Array. It Cost 25 MB of Memory
I was recently refactoring some legacy PHP code and noticed that the same data array was being used...
개요 #
PHP 8.4에서 100만 개의 정수를 배열에 담으면 16.8MB를 쓴다. 여기에 $a['x'] = 0; 한 줄을 실행하면 25MB가 더 붙는다. 키 하나에 25MB다.
Nazar Boyko는 레거시 PHP 코드를 리팩터링하다가 같은 데이터 배열이 전혀 다른 방식으로 쓰이고 있는 걸 발견했고, 그 차이를 파고들어 100만 개짜리 배열을 만들어가며 memory_get_usage()를 찍었다. 결론은 이렇다. PHP 배열은 packed 리스트로 남아 있는 동안에는 대단히 효율적인 자료구조지만, 해시 테이블로 바뀌는 순간 메모리가 튄다. 그리고 큰 데이터셋에서 연관 배열은 같은 데이터를 담은 타입 선언 객체보다 거의 두 배를 먹는다.
측정 환경은 공식 php:8.4-cli 도커 이미지의 PHP 8.4.21, 64비트 리눅스, memory_limit는 -1. 버전이 중요한 항목은 8.1.34에서도 같은 스크립트를 돌렸다. 수치는 memory_get_usage() 델타이며, 매뉴얼대로 할당자 단위로 올림되므로 마지막 자릿수는 오차로 봐야 한다.
정수 하나에 16바이트, 키 하나를 넣기 전까지는 #
측정 코드는 단순하다. 배열을 만들고, memory_get_usage() 두 번의 차이를 원소 수로 나눈다.
<?php
declare(strict_types=1);

const N = 1_000_000;

function report(string $label, int $bytes, int $n): void
{
    printf("%-42s %14s bytes  %6.2f bytes/elem\n", $label, number_format($bytes), $bytes / $n);
}

$before = memory_get_usage();
$a = [];
for ($i = 0; $i < N; $i++) {
    $a[] = $i;
}
report('packed list, keys 0..N-1 in order', memory_get_usage() - $before, N);

$before = memory_get_usage();
$r = [];
for ($i = N - 1; $i >= 0; $i--) {
    $r[$i] = $i;
}
report('same keys, filled in reverse order', memory_get_usage() - $before, N);
두 루프는 같은 키에 같은 값을 넣는다. 하나는 올라가며 세고, 하나는 내려가며 센다.
PHP 8.4.21 (Linux)
packed list, keys 0..N-1 in order          16,781,392 bytes   16.78 bytes/elem
range(0, N-1)                              16,781,392 bytes   16.78 bytes/elem
same keys, filled in reverse order         41,943,120 bytes   41.94 bytes/elem
SplFixedArray of N ints                    16,003,192 bytes   16.00 bytes/elem
거꾸로 채웠다는 이유 하나로 같은 정수 100만 개에 메모리를 두 배 반 썼다.
첫 번째 배열은 엔진이 packed라고 부르는 형태다. 키가 0, 1, 2 순서대로니까 PHP는 키를 아예 저장하지 않는다. 슬롯 하나가 16바이트 zval 하나, 그게 전부다. 역순으로 채운 배열은 키는 같지만 순서가 뒤엉킨 채 들어왔으므로 진짜 해시 테이블이 된다. 키와 해시와 인덱스까지 슬롯당 약 40바이트다.
그다음이 저자를 놀라게 한 대목이다. packed 100만 개짜리에 문자열 키 하나를 준다.
$a['x'] = 0;after adding one string key to packed list +25,161,728 bytes
after adding key -1 to packed list +25,161,728 bytes
after unset of that string key +25,161,728 bytes (nothing came back)키 하나에 25MB. 게다가 그 키를 지워도 되돌아오지 않는다. unset 경로에는 해시 테이블을 packed로 되돌리는 코드가 없기 때문이다(sort()는 되돌리고 array_values()는 새 packed 배열을 만든다. 하지만 맨 unset은 값만 해제하고 레이아웃은 그대로 둔다). 음수 키도 문자열 키와 똑같이 동작한다. unsigned로 보면 엄청나게 큰 수니까 당연하다면 당연하다.
 Photo by
packed는 평평한 zval 배열, 해시는 버킷 더하기 인덱스 #
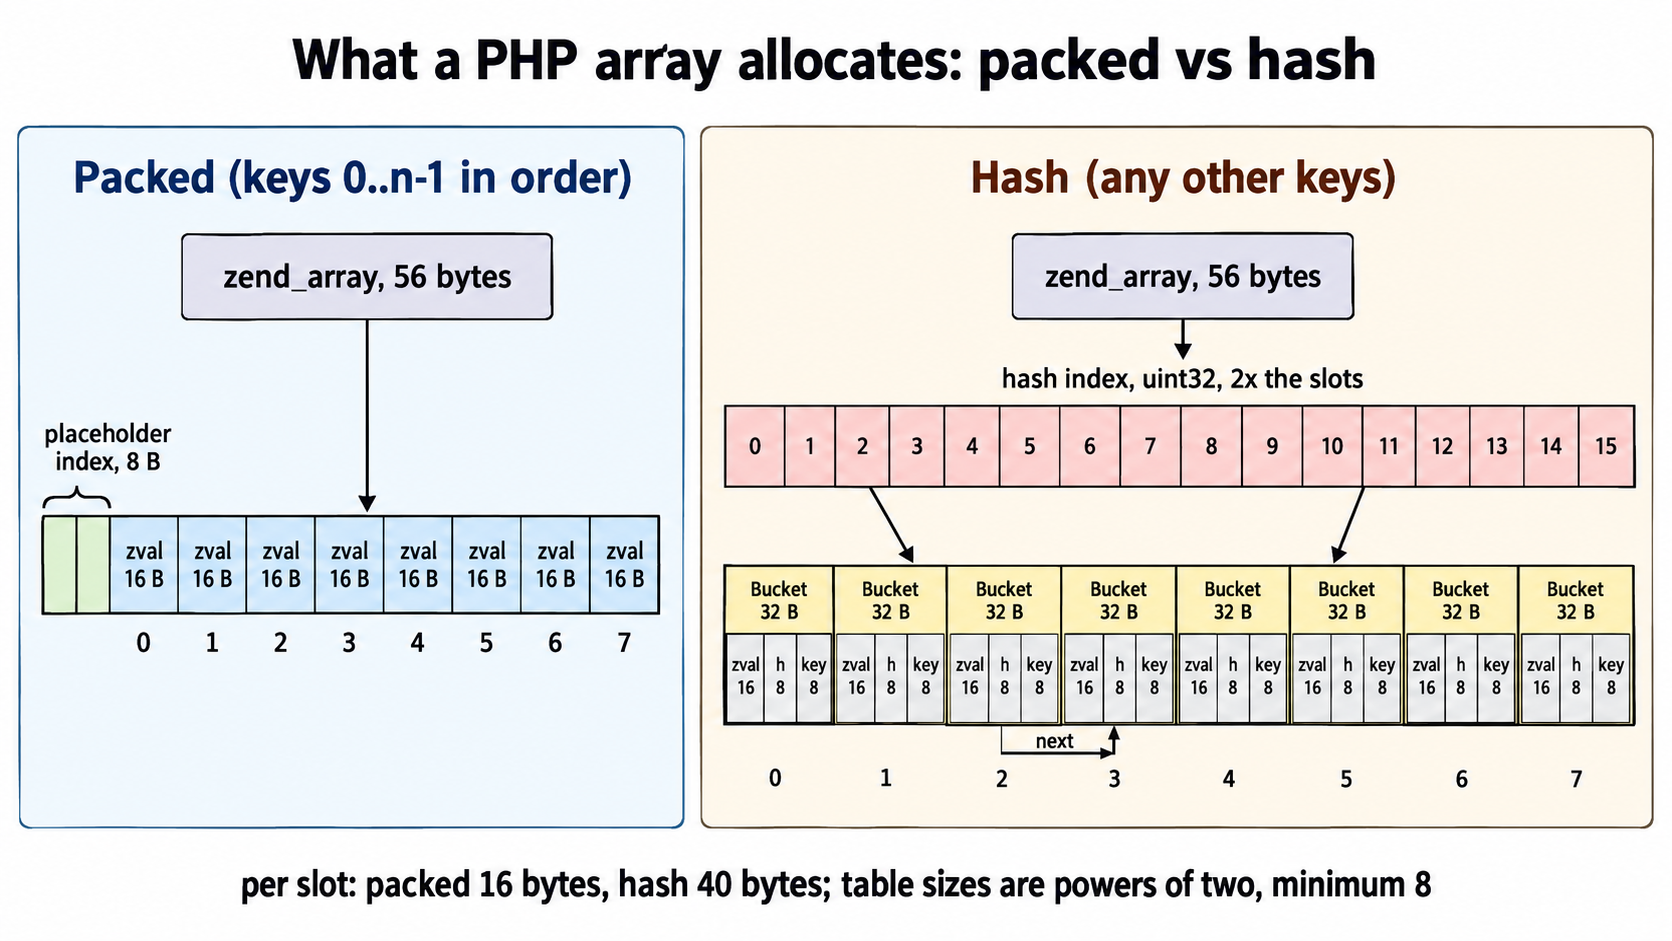
모든 PHP 배열은 zend_array이고 C 코드는 이걸 HashTable이라고도 부른다. 64비트에서 56바이트다. 대부분은 관리 정보(refcount 헤더, 플래그, 테이블 크기, 원소 수, 다음 정수 키, 소멸자 포인터)이고, 데이터를 가리키는 포인터가 하나 있다. 그 포인터가 union이고, union이 이야기의 전부다.
union {
    uint32_t     *arHash;
    Bucket       *arData;
    zval         *arPacked;
};
해시 모드에서 데이터 블록은 두 부분이다. 앞쪽에 해시 인덱스가 있는데 uint32_t 슬롯이 버킷 개수의 두 배다(마스크가 -(nTableSize + nTableSize)). 버킷당 인덱스 8바이트인 셈이다. 그 뒤에 32바이트짜리 버킷이 늘어선다.
typedef struct _Bucket {
    zval              val;   /* 16 bytes: the value */
    zend_ulong        h;     /* 8 bytes: the integer key, or the string key's hash */
    zend_string      *key;   /* 8 bytes: NULL for integer keys */
} Bucket;
조회는 키를 해싱해 마스킹하고, 인덱스에서 버킷 번호를 읽고, 충돌이 있으면 zval 안에 들어 있는 next 체인을 따라간다. 순회는 인덱스를 건드리지 않고 버킷을 앞에서 뒤로 훑는다. 버킷은 삽입 순서대로 붙으니 foreach가 삽입 순서를 공짜로 보장하는 이유가 여기 있다.
그래서 해시 슬롯 하나가 32 + 8 = 40바이트다. 100만 개면 테이블 크기가 1,048,576슬롯이고(이건 잠시 뒤에), 거기에 40을 곱하면 측정값에서 80바이트가 모자란다. 그 80이 56바이트 구조체와 할당자가 이만한 블록을 추적하려고 쓰는 24바이트다.
packed 모드에는 인덱스가 없다(자리만 두 슬롯, 총 8바이트). 데이터는 zval *arPacked, 16바이트 값이 늘어선 순수 C 배열이고 위치가 곧 키다. 같은 테이블 크기에 16을 곱하면 측정된 16.8MB보다 4KB쯤 적다. 슬롯만 작아졌을 뿐 계산 방식은 같다.
저자가 몰랐다고 밝힌 부분은 packed 배열이 이렇게 싸진 게 PHP 8.2부터라는 것이다. 그전에는 해시 배열과 똑같은 32바이트 버킷을 쓰면서 인덱스만 건너뛰었다. h에는 슬롯 위치가 반복해 들어가고 key는 모든 슬롯에서 NULL이었다. Dmitry Stogov의 PR #7491("Use more compact representation for packed arrays")이 2021년 11월 병합됐고 2022년 12월 8.2.0에 실렸다. 내부 구현 변경이라 8.2 UPGRADING 문서에는 언급조차 없다. 8.1에서 돌린 결과는 이렇다.
PHP 8.1.34 (Linux)
packed list, keys 0..N-1 in order          33,558,608 bytes   33.56 bytes/elem
same keys, filled in reverse order         41,943,120 bytes   41.94 bytes/elem
릴리스 하나로 애플리케이션 안 모든 리스트의 슬롯 메모리가 절반이 됐다. Tideways도 8.2가 나왔을 때 10만 원소 리스트로 같은 걸 측정해 4.3MB에서 2.3MB로 줄었다고 보고했다. 아직 8.1에 머물러 있다면 이것만으로도 올릴 이유가 된다.
알아둘 만한 또 하나의 규칙은 증가 방식이다. 테이블 크기는 최소 8에서 시작하는 2의 거듭제곱이고, 가득 차면 두 배가 된다(zend_hash_do_resize의 nSize = ht->nTableSize + ht->nTableSize). 그래서 100만 개는 1,048,576슬롯짜리 테이블에 산다. 그 말은 이렇다.
packed list of 1,048,576 ints              16,781,448 bytes   16.00 bytes/elem
packed list of 1,048,577 ints              33,558,664 bytes   32.00 bytes/elem
원소 하나 더 넣었더니 메모리가 두 배다. 반대로는 안 간다. 100만 개 중 99만 9천 개를 unset했더니 memory_get_usage()는 정확히 0바이트 움직였다. 값이 정수라 해제할 게 없었고, 테이블 자체는 줄어들지 않는다. 배열은 자기가 가장 컸을 때를 기억한다. 큐 워커에서 메모리가 올라가기만 하는 이유 중 하나가 이거다.
packed를 유지하는 조건은 array_is_list()보다 까다롭다 #
변환 로직은 Zend/zend_hash.c의 _zend_hash_index_add_or_update_i에 있다. 지금 packed인 배열에 정수 키가 들어오면 이런 순서를 밟는다.
- 최고 수위보다 작은 키, 슬롯이 차 있음. 제자리 덮어쓰기. packed 유지.
- 최고 수위보다 작은 키, 슬롯이 구멍. 해시로 변환. 소스의 주석이
/* we have to keep the order :( */인데, 이게 이 모든 일의 진짜 이유다. PHP 배열은 삽입 순서 순회를 약속하고 packed 배열은 "오름차순"만 표현할 수 있으니, 오름차순을 깨는 삽입은 전체 구조를 강제한다. - 현재 테이블 크기 안에 드는 키. 이어 붙이고 빈 구간은 undefined 슬롯으로 채우며 packed 유지.
$a[0] = 'a'; $a[5] = 'b';를 쓰면 구멍 네 개짜리 packed 배열이 나온다. - 테이블을 넘지만 두 배 미만인 키, 테이블이 절반 이상 참. 키우고 packed 유지.
- 그 외 전부, 모든 문자열 키, 모든 음수 키. 해시로 변환.
같은 원소 두 개를 도착 순서만 바꿔 담은 배열 둘이다.
[0 => 'b', 1 => 'a'] built at runtime      216 bytes
[1 => 'a', 0 => 'b'] built at runtime      376 bytes
376바이트짜리는 버킷 8개와 인덱스 슬롯 16개를 가진 해시 테이블이다. 값 두 개를 담으려고. 216바이트짜리는 zval 8개가 전부다. 둘 다 최소 테이블 크기다.
실제로 발목을 잡는 건 array_filter()다. 키를 보존한다는 건 다들 안다. 필터링한 리스트가 JSON에서 객체로 인코딩되는 증상 때문이다. 메모리 쪽 증상은 그만큼 요란하지 않다. packed 100만 개를 짝수만 남기고 거르면 결과 배열이 0, 2, 4, 6 순으로 키 단위로 만들어지다가 키 8이 도착한다. 초기 테이블 크기 8에 들어가지 못하고 "절반 이상 참" 조건도 통과하지 못해서, 새 배열은 다섯 번째 원소에서 해시로 바뀌고 평생 그 상태로 남는다.
array_filter keeping every other element   20,971,600 bytes   41.94 bytes/elem
array_values() of that result               8,392,784 bytes   16.79 bytes/elem
array_is_list(filtered) = false
원소는 절반인데 메모리는 원본 packed 100만보다 많다. array_values()가 복사 한 번 값으로 이걸 고쳐주는데, 결과가 한동안 살아 있을 거라면 언제나 치를 만한 값이라는 게 저자의 판단이다.
그리고 array_is_list()는 키를 검사하지 레이아웃을 검사하지 않는다. 8.1에 들어온 함수라 저자도 이게 그 테스트인 줄 알았다고 한다. 이 함수가 답하는 건 "키가 0부터 n-1까지 순서대로인가"이고, 해시 테이블도 그 조건은 만족할 수 있다.
[1 => 'a', 0 => 'b']                       376 bytes   array_is_list = false
after unset($b[1])                         376 bytes   array_is_list = true
똑같은 376바이트, 똑같은 해시 레이아웃인데 이제 함수는 리스트라고 답한다. PHP 8.4 전까지는 유저랜드에서 레이아웃을 보여주는 호출이 없었고, 정직한 계측기는 memory_get_usage()뿐이었다. 8.4부터 debug_zval_dump()가 packed 배열 옆에 packed를 찍어준다. 위 배열에는 아무것도 찍히지 않는다.
복사는 첫 쓰기 전까지 공짜다 #
refcount는 변수가 아니라 zend_array 헤더에 있다. $b = $a는 refcount를 올리고 두 변수가 같은 테이블을 가리키게 한다. 배열을 함수에 넘겨도 마찬가지다. 그리고 엔진은 refcount가 1인, 즉 독점 소유한 구조만 수정할 수 있다. 아니면 먼저 분리하고, 분리는 테이블 복제를 뜻한다.
$copy = $a                                          0 bytes
$copy[] = 1 (first write)                  16,781,392 bytes
행 배열에는 유리하게 작동하는 디테일이 하나 있다. 분리는 바깥 테이블만 복사하고 각 행의 refcount를 올린다. 행을 깊은 복사하지 않는다. 100만 행 배열의 복사본에 하나를 덧붙이는 데 16.8MB(바깥 packed 테이블)가 들었고, 그 복사본의 한 행에서 필드 하나를 바꾸는 데 그 행의 해시 테이블용 376바이트가 더 들었다. 엔진은 건드린 만큼만, 한 단계씩 복사한다.
100만 행을 배열로 들면 객체의 두 배다 #
저자가 실제로 알고 싶었던 건 이 부분이다. 쿼리 결과를 연관 배열로 받는 건 저자가 본 모든 PHP 코드베이스의 기본값이었다(fetchAll(PDO::FETCH_ASSOC)이거나 같은 모양을 돌려주는 쿼리 빌더). 전형적인 요청에서 살아 있는 배열 대부분이 해시 배열일 거라는 추정도 여기서 나온다. 쿼리나 JSON 본문에서 문자열 키를 달고 왔을 테니까. 그래서 필드 다섯 개짜리 행 100만 개를 같은 값으로 여러 컨테이너에 담아봤다.
final class Row
{
    public function __construct(
        public int $id,
        public string $name,
        public string $email,
        public bool $active,
        public float $balance,
    ) {}
}

// each shape, built a million times in a loop and kept in a list
$row = ['id' => $i, 'name' => "user$i", 'email' => "user$i@example.com", 'active' => true, 'balance' => 1.5];
$row = new Row($i, "user$i", "user$i@example.com", true, 1.5);
$row = [$i, "user$i", "user$i@example.com", true, 1.5];
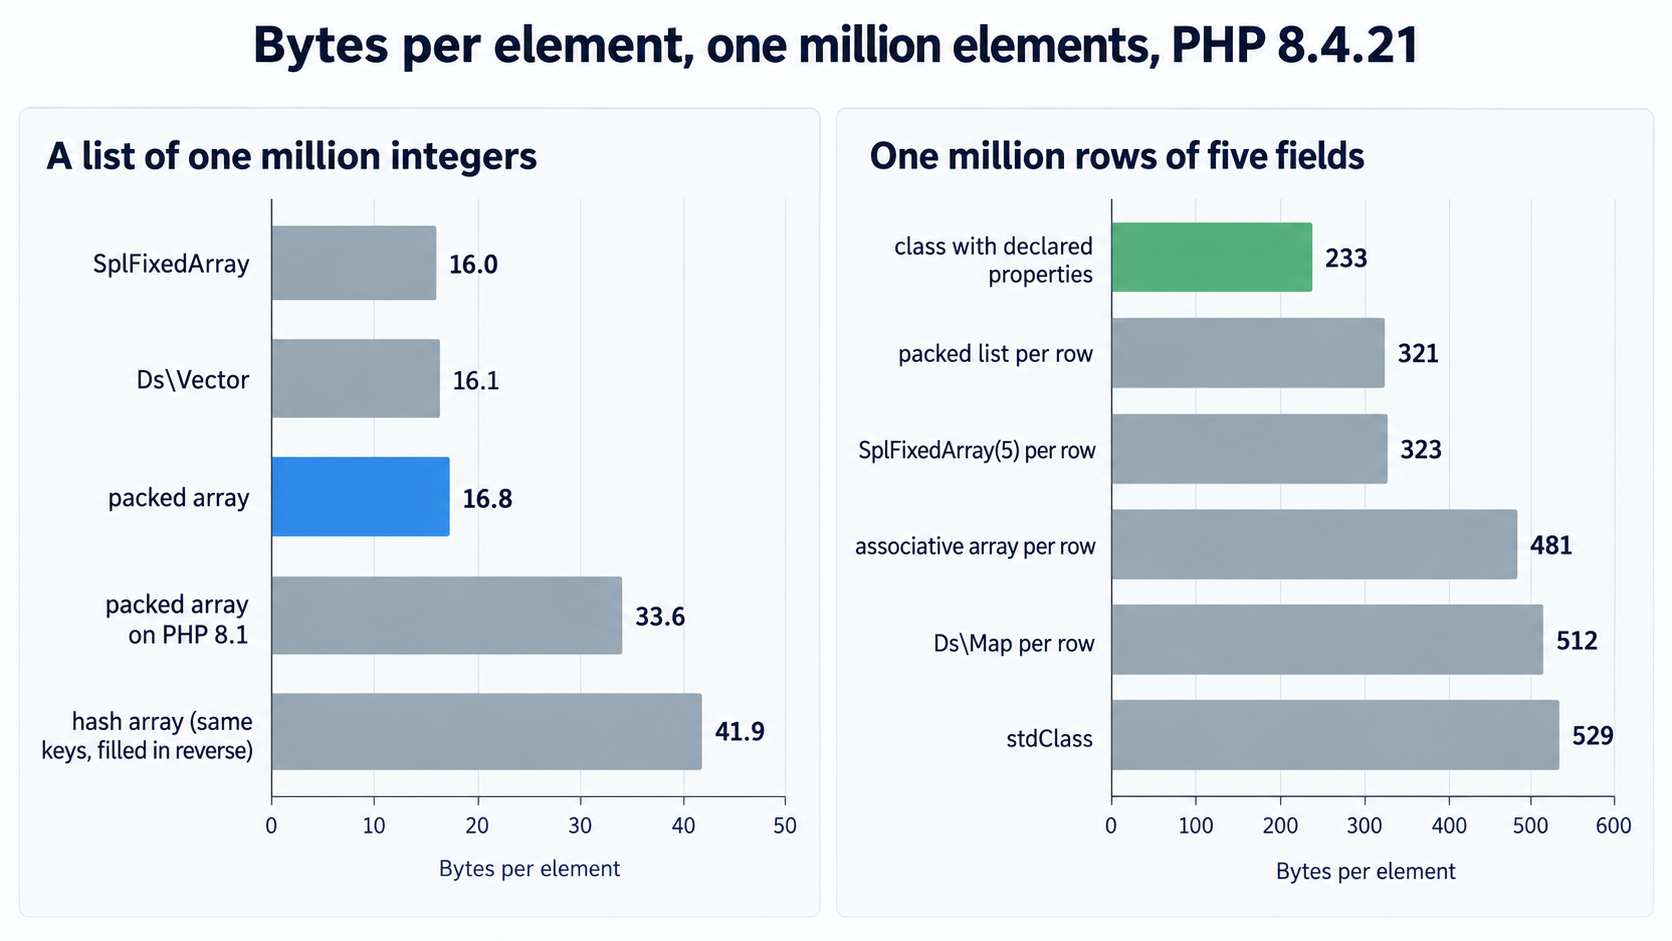
100만 행 기준, 문자열 두 개와 바깥 리스트 슬롯까지 포함한 행당 바이트다.
| 형태 | PHP 8.4.21 | PHP 8.1.34 |
|---|---|---|
| 타입 선언 프로퍼티 5개짜리 클래스 | 233 | 250 |
같은 클래스, readonly 프로퍼티 | 233 | 250 |
행마다 packed 리스트 (FETCH_NUM 모양) | 321 | 498 |
행마다 SplFixedArray(5) | 323 | 324 |
행마다 연관 배열 (FETCH_ASSOC 모양) | 481 | 498 |
행마다 stdClass (FETCH_OBJ 모양) | 529 | 546 |
이 표에는 단서가 하나 붙는다. 여섯 형태를 한 프로세스에서 연달아 돌렸기 때문에 객체 행이 실제보다 조금 싸 보인다. 모든 객체는 엔진 객체 저장소에 8바이트 항목을 하나씩 차지하는데, 이 저장소는 가득 차면 두 배가 되고 절대 줄지 않는다. 뒤에 실행된 객체 측정은 stdClass 실행이 이미 지불한 항목과 관리 정보를 재사용했다. 각각 새 프로세스에서 재면 클래스 행은 8.4에서 241바이트, 8.1에서 258바이트이고 SplFixedArray(5) 행은 8.4에서 340, 8.1에서 341이다. 배열 행과 stdClass는 같게 나온다.
문자열 두 개는 모든 행에서 동일하다. "user123456"과 "user123456@example.com"이 각각 40바이트와 48바이트다. 24바이트 zend_string 헤더에 문자들과 종료 문자를 더하고 할당자 bin으로 올림한 값이다. 바깥 배열 슬롯은 16.78. 이 105바이트를 빼면 남는 게 컨테이너 비용이고, 저자는 그것도 행 하나씩 따로 쟀다.
assoc row, 5 string keys                   376 bytes
stdClass row, 5 dynamic properties         416 bytes
packed row, 5 values                       216 bytes
SplFixedArray(5) row                       176 bytes
object row, 5 declared properties          128 bytes
376은 앞 절에 나온 그 숫자다. 56바이트 헤더에 최소 버킷 8개용 해시 블록(버킷 8 x 32, 인덱스 16 x 4)을 더해 320바이트. 필드 다섯 개를 담으려고 말이다. 행마다 자기 인덱스, 자기 키 해시와 포인터 사본, 그리고 빈 버킷 세 개를 이고 다닌다.
객체가 128인 건 zend_object 헤더가 40바이트이고 선언된 프로퍼티는 그 바로 뒤에 16바이트 zval 하나씩 인라인으로 저장되기 때문이다(40 + 5 x 16 = 120, 할당자가 128 bin으로 올림). 프로퍼티 이름은 객체 안에 아예 없다. 클래스가 이름과 슬롯 오프셋을 매핑하는 테이블을 컴파일 타임에 한 번 만들어 들고 있고, 인스턴스는 슬롯일 뿐이다.
타입을 붙였든 아니든, readonly든 아니든 바이트 수는 달라지지 않는다. 타입은 클래스에 살고 슬롯은 어느 쪽이든 zval이다. 정확성을 위해 쓰는 readonly DTO가 행을 담는 가장 싼 방법이기도 하다는 뜻이다.
stdClass는 양쪽의 나쁜 점만 가져왔다. 40바이트 객체 헤더가 있고 선언된 프로퍼티가 없으니 모든 필드가 객체 자신의 properties 해시 테이블로 들어간다. 그 테이블이 바로 앞의 376바이트 배열이고, 거기에 객체 껍데기가 하나 씌워진 꼴이다. FETCH_OBJ는 이 모양을 100만 번 만들어준다. PHP 8.2가 일반 클래스의 동적 프로퍼티를 deprecated 처리했지만, 해당 RFC는 stdClass에 #[AllowDynamicProperties]를 붙여뒀으니 사라지지 않는다.
행마다 packed 리스트를 쓰는 건 8.2 변경을 보여주는 좋은 예다. 8.4에서 216바이트, 헤더에 16바이트 슬롯 8개를 160 bin으로 올린 값이다. 8.1에서는 376으로 연관 배열과 똑같다. 그때는 packed 버킷이 32바이트였고 8개에 작은 인덱스를 더하니 같은 320바이트 bin에 떨어졌기 때문이다. 8.2 전까지 FETCH_NUM은 아무것도 절약하지 못했고, 지금은 3분의 1을 아끼는 대신 컬럼 이름을 잃는다.
드라이버가 배열을 준다는 반론은 당연히 나온다. 100만 개를 객체로 바꾸면 생성자 호출이 100만 번이다. 저자의 답은 이미 지불한 쿼리 비용에 비하면 생성자는 싸다는 것이다. PDO는 FETCH_CLASS로 행마다 클래스를 만들 수도 있다(다만 FETCH_PROPS_LATE를 붙이지 않으면 생성자 호출 전에 프로퍼티를 할당해서 생성자 프로모션과 어울리지 않는다. 저자는 차라리 매핑 한 줄을 직접 쓰겠다고 한다). 하지만 "생성자 100만 번"에 대한 더 나은 답은 애초에 100만 개를 들고 있으면 안 된다는 것이고, 그게 마지막 절이다.
 Photo by Markus Spiske on Pexels
평평한 리스트는 SplFixedArray가 이기고, ext-ds는 판을 바꾸지 못한다 #
SplFixedArray는 zend_long size와 zval *elements 버퍼를 가진 C 구조체다. 버퍼는 정확히 size * sizeof(zval)만큼 할당된다. 해시도 인덱스도 2의 거듭제곱 올림도 없다. 정수 100만 개가 정확히 원소당 16.00바이트로, packed 배열의 16.78보다 낫다(packed는 테이블을 다음 2의 거듭제곱으로 올렸다). 그 5%가 메모리 이득의 전부고, 대신 증가와 문자열 키와 모든 array_* 함수를 포기해야 한다. 필드 다섯 개짜리 행에는 176바이트가 드는데, 이건 클래스보다 많다.
ext-ds는 저자가 직접 컴파일해서 쟀다. PHP 자료구조 얘기만 나오면 늘 거론되는 확장이기 때문이다. 숫자 앞에 단서 하나. pecl install ds로 2.0.0이 깔렸는데 이 빌드에서는 Ds\Seq, Ds\Map, Ds\Set, Ds\Heap, Ds\Pair만 선언하고 Ds\Vector는 아예 없었다. 아래 수치는 1.6.0 기준이다.
PHP 8.4.21, ext-ds 1.6.0
Ds\Vector of N ints (push)                 16,085,160 bytes   16.09 bytes/elem
Ds\Map of N ints (reverse order)           37,748,960 bytes   37.75 bytes/elem
Ds\Map per row inside a Ds\Vector 512,457,608 bytes 512.46 bytes/rowDs\Vector는 용량이 2의 거듭제곱에 묶이지 않은 연속 버퍼라서(매뉴얼에 그렇게 적혀 있다) 16.78이 아니라 16.09에 떨어진다. Ds\Map은 해시 배열보다 10%쯤 낫다. 행마다 Ds\Map을 쓰면 평범한 연관 배열보다 나쁘다. 알고리즘 보장이 확실한 좋은 API이고, 배열이 절대 하지 않는 일인 "줄어들 때 메모리 반환"도 한다. 다만 행 데이터의 메모리 해법은 아니고, 리스트에서 4% 아끼자고 배포에 C 확장을 추가하지는 않겠다는 게 저자의 결론이다.
저자가 실제로 하겠다는 것 #
리스트는 packed로 유지한다. 순서대로 덧붙이고, 인덱스로 거꾸로 채우지 않고, 리스트여야 할 것에 문자열 키를 들이지 않는다. array_filter() 결과가 다음 줄보다 오래 살 거라면 array_values()를 부른다. array_is_list()는 테스트의 단언문으로는 괜찮지만 키만 검사한다는 걸 알고 써야 한다.
메모리에 들고 있을 행은 프로모션된 타입 선언 프로퍼티를 가진 작은 final 클래스에 담는다. 연관 배열의 절반 메모리에 모든 필드가 이름과 타입을 갖고, readonly는 추가 비용이 없다. fetchAll()을 하고 결과를 순회하는 코드에 저자가 가하고 싶은 단 하나의 변경이 이거다.
그리고 100만 행을 들고 있지 마라. 전부 materialize한 다음 도는 모양과 제너레이터를 도는 모양을 각각 다른 프로세스에서 돌려 피크를 정직하게 쟀다. 행은 DB 없이 코드에서 생성했으므로, 가져오는 비용이 아니라 들고 있는 비용을 잰 것이다.
function rows(int $n): Generator
{
    for ($i = 0; $i < $n; $i++) {
        yield new Row($i, "user$i", "user$i@example.com", true, 1.5);
    }
}

function loadAll(int $n): array
{
    $all = [];
    foreach (rows($n) as $row) {
        $all[] = $row;
    }
    return $all;
}

// materialize: foreach (loadAll(N) as $row) { $sum += $row->balance; }
// stream: foreach (rows(N) as $row) { $sum += $row->balance; }materialize all rows, then loop peak over start 241,157,928 bytes
stream rows through a generator peak over start 37,008 bytes같은 100만 행을 같은 방식으로 도는데 241MB 대신 37KB다. 실제 statement라면 제너레이터는 while ($r = $stmt->fetch())로 한 번에 Row 하나를 yield하는 모양이 된다. 다만 MySQL에서는 큰 단서가 하나 붙는다. 쿼리가 기본적으로 버퍼링되기 때문에 드라이버가 첫 fetch() 전에 결과 집합 전체를 PHP 메모리로 끌어오고, mysqlnd에서는 그 버퍼가 memory_limit에 잡힌다. 버퍼링된 결과 집합 위의 제너레이터는 객체는 스트리밍하면서 원본 행 전부를 밑에 깔고 있는 셈이다. 해법은 큰 쿼리에 한해 Pdo\Mysql::ATTR_USE_BUFFERED_QUERY를 false로 두거나(8.3 이하에서는 PDO::MYSQL_ATTR_USE_BUFFERED_QUERY이고 8.5에서 deprecated된다) 기본 키로 페이징하는 것이다. 라라벨의 cursor()가 바로 이 패턴이다.
슬롯당 16바이트는 리스트 값으로 적당하다. 비싸지는 건 배열이 조용히 리스트이기를 그만두는 방식이다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.