재시도할까, 말까? AI 모델 8종에 API 재시도 판단을 시켜 봤다 (To Retry or Not to Retry?)
API 장애 시나리오 14개로 AI 모델 8종이 '재시도해도 되는 요청'을 제대로 가려내는지 Kaggle 벤치마크로 측정했습니다. 멱등성 키가 없는 결제 요청에서 대부분의 모델이 Retry-After 헤더만 보고 재시도를 택했습니다.


To Retry or Not to Retry? That Is the Question.
This is a submission for the Kaggle Benchmarking Challenge Those who read my articles know that a...
개요 #
503 Service Unavailable을 받았다고 해서 무조건 다시 보내도 되는 건 아닙니다. POST 요청은 서버에서 이미 처리됐을 수도 있고, 타임아웃은 서버가 요청을 받기 전에 났을 수도, 상태를 바꾼 뒤에 났을 수도 있습니다. 멱등성 키(idempotency key)가 있느냐 없느냐에 따라 답이 정반대가 되기도 합니다.
.NET 벤치마크 글을 꾸준히 써 온 Daniel Balcarek은 DEV.to의 Kaggle Benchmarking Challenge에 참가하면서 바로 이 지점을 AI 모델에게 물어봤습니다. "이 요청, 재시도해도 될까?" 결과는 이렇습니다. 최상위 모델도 실수를 했고, 멱등성 키 없는 결제 요청 시나리오에서는 8개 모델 중 6개가 매번 틀렸습니다.
무엇을 측정했나 #
판단 결과만 채점하는 단순한 구조 #
작성자는 요청 정보, 응답, 추가 맥락을 담은 API 장애 시나리오를 여러 개 만들었습니다. 모델은 두 가지만 답하면 됩니다.
- 판단:
YES,NO,YES_AFTER_DELAY중 하나 - 이유: 한 문장 설명
예를 들면 이런 문제입니다.
POST /payments
503 Service Unavailable

An idempotency key was supplied and the API guarantees
duplicate requests with the same key are not processed twice.

Retry?
개발자라면 바로 YES_AFTER_DELAY라고 답할 겁니다. 핵심은 503 자체가 아니라, 같은 키로 보낸 요청은 결제가 두 번 처리되지 않는다는 맥락입니다. 모델도 이걸 알아챌까요? 그리고 이보다 덜 뻔한 상황에서는 어떨까요?
모든 모델에 같은 응답 형식을 요구했습니다.
Decision: YES | NO | YES_AFTER_DELAY
Reason: <one sentence>
점수는 Decision으로만 매깁니다. 그래야 결과가 결정적이고 모델끼리 비교하기도 쉽습니다. Reason은 점수에 반영하지 않지만, 모델이 상황을 제대로 이해했는지, 아니면 엉뚱한 이유로 우연히 정답을 맞혔는지 확인하려고 함께 수집했습니다.
왜 이걸 측정하나 #
외부 서비스를 연동하면서 호출을 좀 더 튼튼하게 만들고 싶다고 해 봅시다. 요즘은 코딩 에이전트가 그 작업을 맡을 가능성이 높고, 재시도 정책 코드를 만드는 것쯤은 AI에게 어렵지 않습니다. 작성자가 던진 질문은 그다음입니다. 재시도해야 할 요청만 제대로 골라서 재시도하느냐는 것이죠. 재시도하면 안 되는 요청을 다시 보내는 건, 아예 재시도하지 않는 것보다 훨씬 나쁜 결과를 낳을 수 있습니다.
시나리오 14개 #
시나리오는 모두 Kaggle 벤치마크에 실제로 들어간 과제입니다. 전체 문제와 정답·해설은 별도 웹 앱에서 볼 수 있고, 사람이 직접 풀어 보는 테스트도 있습니다.
- Safe Payment Retry — 결제 요청이
503으로 실패했지만, 멱등성 키 덕분에 재시도해도 중복 결제가 생기지 않는다. - Unsafe Payment Retry — 결제 요청이
Retry-After와 함께503을 받았지만, 멱등성 키가 없어 재시도하면 이중 청구가 될 수 있다. - Idempotent PUT —
PUT요청은 전송됐지만 응답이 오기 전에 연결이 끊겼다. - Rate-Limited Order — 주문 요청이 처리 전에 속도 제한에 걸려
Retry-After와 함께429 Too Many Requests를 받았다. - Payment Details Conflict — 여러 단계로 이뤄진 결제 흐름에서
/payments/details가transient-error: false와 함께409 Conflict를 돌려줬다. - Non-Idempotent PATCH — 재고를 늘리는
PATCH요청 도중 연결이 끊겨, 변경이 이미 반영됐는지 클라이언트가 알 수 없다. - Idempotent DELETE — 세션 삭제 요청을 보냈지만 응답 전에 연결이 끊겼다.
- Service Unavailable —
GET요청이Retry-After헤더와 함께503을 받았다. - Stale Resource Version — 다른 클라이언트가 리소스를 먼저 수정해서, 예전 ETag로 보낸
PATCH가412 Precondition Failed로 실패했다. - Rate Limit Without Retry-After — 안전한
GET요청이 계속429를 받지만, 서버가Retry-After를 주지 않는다. - I'm a Teapot — 커피를 요청했더니 전설의
418 I'm a Teapot이 돌아왔다. - Eventual Consistency — 방금 만든 리소스를 다른 서비스가 바로 쓰려고 하자
404 Not Found가 났다. - Expired Filter Workflow — 임시 필터가 여러 번 타임아웃되다가 결국
404를 돌려줘, 원래 필터는 더 이상 쓸 수 없다. - Cached Cart Options — 장바구니 옵션 요청이
504 Gateway Timeout으로 실패했지만,stale-if-error로 막 만료된 캐시 응답을 쓸 수 있다.
테스트한 모델 #
작성자가 업무에서 자주 쓰는 모델과 궁금했던 모델을 섞어 8개를 골랐습니다.
GPT-5.6 Luna,GPT-5.6 Sol— 작성자가 가장 많이 쓰는 모델. Luna는 Sol보다 실수가 잦지만 토큰을 훨씬 적게 쓴다고 합니다.Gemini 3.7 Flash,Gemini 3.1 Pro Preview— 텍스트 생성과 CSS 작업에 자주 쓰던 모델.Claude Sonnet 5,Claude Haiku 4.5— 예전에 코딩용으로 많이 썼지만, 지금은 작업 흐름상 GPT-5.6으로 대부분 옮겼다고 합니다.GLM-5,DeepSeek-R1— 호기심으로 추가.
Grok도 넣으려 했지만 Grok 4.5, Grok 4.6 모두 호출 단계에서 404 Not Found가 나서 결과에서 빠졌습니다.
결과 #
첫 번째 실행: 대부분이 같은 함정에 빠졌다 #
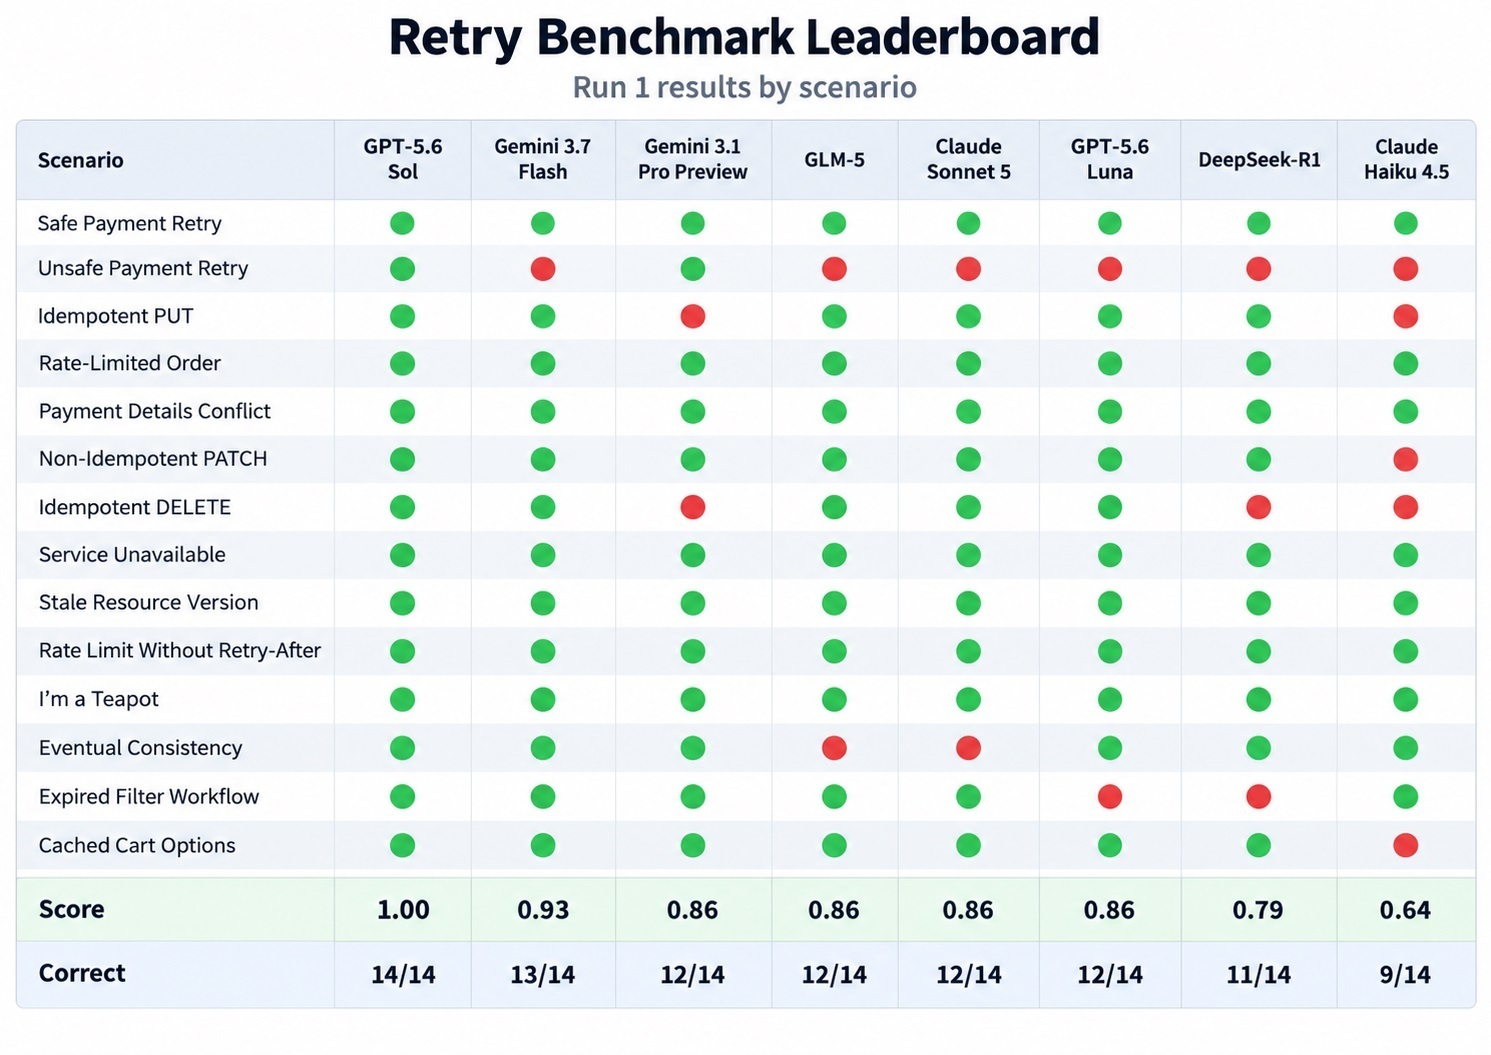
1회차에서 만점(1.00)은 GPT-5.6 Sol 하나였습니다. Gemini 3.7 Flash가 한 문제 차이로 2위였고, 네 모델이 두 문제씩 틀렸습니다. DeepSeek-R1은 세 문제, 최하위 Claude Haiku 4.5는 다섯 문제를 틀렸습니다.
가장 많은 모델이 틀린 문제는 Unsafe Payment Retry였습니다. Retry-After 헤더가 붙어 있어 헷갈리기 쉽지만, 이 요청을 다시 보내면 이중 청구가 날 수 있습니다. 정답을 맞힌 건 GPT-5.6 Sol과 Gemini 3.1 Pro Preview뿐이었고, 나머지는 대체로 이렇게 답했습니다.
Decision: YES_AFTER_DELAY
Reason: The server explicitly requests waiting 10 seconds before attempting the request again.
눈에 잘 띄는 HTTP 신호만 따라가다가, 그 신호가 전체 맥락과 어긋난다는 점을 놓친 겁니다. Retry-After는 "다시 보내라"고 말하지만, 멱등성 키 없는 결제는 "다시 보내면 안 될 수도 있다"고 말합니다. 작성자는 아직 AI를 속일 수 있다는 데서 작은 승리감을 느꼈다고 덧붙였습니다.
멱등 메서드를 다룬 Idempotent PUT, Idempotent DELETE에서 틀린 모델이 있었던 것도 의외였습니다. 다만 완전히 엉뚱한 답은 아니었습니다. 대부분 일시적인 네트워크 문제로 보고 YES_AFTER_DELAY를 골랐습니다. 재시도가 안전하다는 건 이해했고, 언제 재시도할지에서만 의견이 갈린 겁니다. 상황을 잘못 이해한 것과는 성격이 다릅니다. 작성자는 2판에서는 일부 시나리오에 정답을 여러 개 허용하는 방안을 고려하겠다며, 이 부분은 오히려 AI에게 배운 셈이라고 했습니다.
세 번 돌려 본 결과 #
한 번 돌린 결과만 보고 판단하기는 이르니, 같은 벤치마크를 두 번 더 돌려 모델이 얼마나 일관되게 답하는지 확인했습니다.
| 모델 | 1회 | 2회 | 3회 | 평균 |
|---|---|---|---|---|
| GPT-5.6 Sol | 14/14 | 14/14 | 13/14 | 13.67 |
| Gemini 3.7 Flash | 13/14 | 13/14 | 13/14 | 13.00 |
| Gemini 3.1 Pro Preview | 12/14 | 12/14 | 13/14 | 12.33 |
| GLM-5 | 12/14 | 13/14 | 12/14 | 12.33 |
| Claude Sonnet 5 | 12/14 | 12/14 | 12/14 | 12.00 |
| GPT-5.6 Luna | 12/14 | 12/14 | 12/14 | 12.00 |
| DeepSeek-R1 | 11/14 | 10/14 | 10/14 | 10.33 |
| Claude Haiku 4.5 | 9/14 | 9/14 | 9/14 | 9.00 |
전체적으로는 꽤 안정적이었습니다. 모델 8개 × 시나리오 14개, 총 112개 조합 가운데 102개(약 91%)가 세 번 모두 같은 정오답 결과를 냈습니다.
그런데 점수가 같다고 행동까지 같은 건 아니었습니다. 맞힌 개수는 그대로인데 틀린 문제가 회차마다 바뀐 모델도 있었습니다. 세 번 내리 12/14를 받았어도 매번 같은 판단을 했다고 볼 수는 없다는 뜻입니다.
이런 흔들림이 가장 두드러진 문제는 Expired Filter Workflow였습니다. GPT-5.6 Sol, Gemini 3.1 Pro Preview, GLM-5, DeepSeek-R1 네 모델의 답이 회차마다 달라졌습니다. 1·2회차에서 만점을 받은 GPT-5.6 Sol도 3회차에는 이 문제의 답을 YES에서 YES_AFTER_DELAY로 바꿨습니다. 재시도해야 한다는 판단은 같았고 시점만 달라진 것인데, 작성자는 YES와 YES_AFTER_DELAY를 엄격하게 구분해 채점하는 게 늘 옳은지 다시 생각하게 됐다고 합니다.
반복 실행으로 Unsafe Payment Retry에 대한 결론은 더 분명해졌습니다. 24번 시도 중 정답은 **6번(25%)**뿐이었고, 결과가 회차마다 완전히 같았습니다. GPT-5.6 Sol과 Gemini 3.1 Pro Preview는 세 번 모두 맞혔고, 나머지 여섯 모델은 세 번 모두 틀렸습니다. 무작위로 흔들린 결과라기보다, 모델들이 이 시나리오를 해석하는 방식에 구조적인 함정이 있는 것으로 보입니다.
반대로 14개 중 7개 시나리오는 24번 모두 정답이 나왔습니다. 단순한 재시도 상황에서는 모델 간 차이가 거의 없었고, 재시도 시점이나 더 넓은 맥락, 여러 단계에 걸친 상태가 중요해지는 순간부터 차이가 벌어졌습니다.
비용 대비 성능 #
세 번 모두 모델들이 차트에서 비슷한 위치에 놓였기 때문에, 작성자는 3회차 그래프를 기준으로 효율을 비교했습니다.
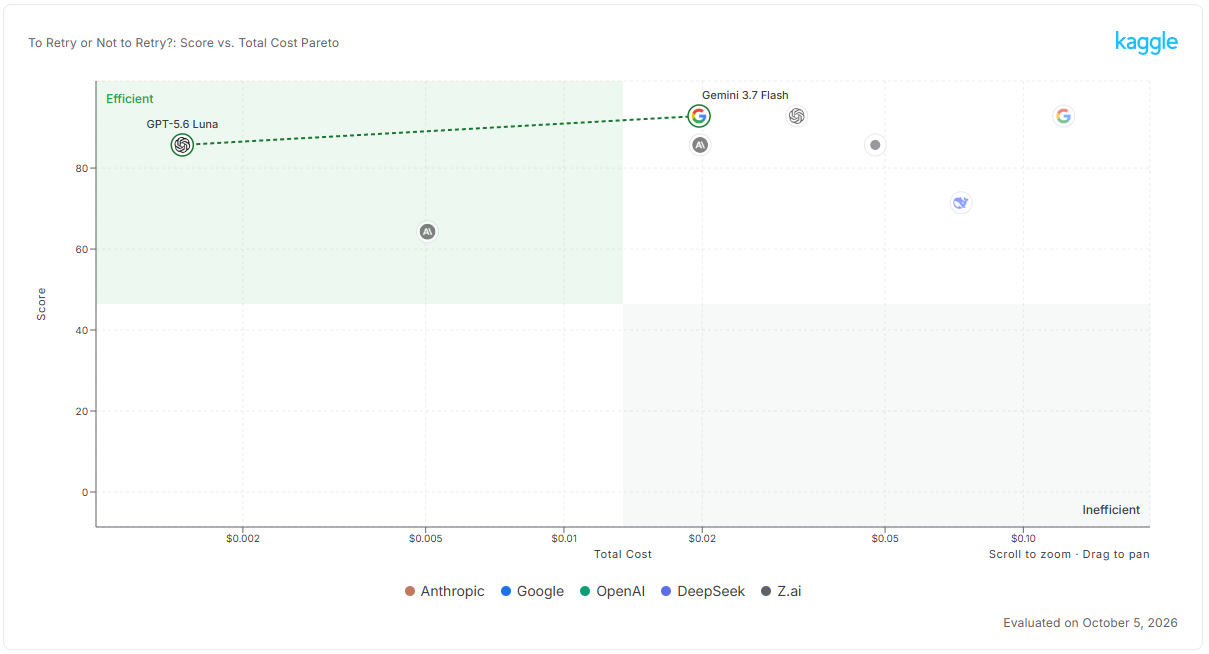
GPT-5.6 Luna가 가장 효율적이었습니다. 작성자가 업무에서 주로 쓰는 이유이기도 합니다. 싸고, 대개 최종 답에 가깝게 데려다준다는 평가입니다.Claude Haiku 4.5도 효율 구간에 있었지만, 점수는 8개 모델 중 가장 낮았고 비용은GPT-5.6 Luna보다 높았습니다.- 나머지 모델은 차트 오른쪽 위에 몰렸습니다. 특히
DeepSeek-R1이 두 번째로 비싼 모델이었다는 점이 의외였습니다.
작성자가 DeepSeek-R1의 출력을 확인해 보니, Decision과 Reason만 쓰라는 지시를 무시하고 매번 4,000~9,000자를 쏟아내고 있었습니다. 다른 모델은 모두 형식을 지켰습니다. 결국 비용 차이를 만든 건 토큰 단가가 아니라, 출력 형식 지시를 얼마나 잘 따랐느냐였습니다.
작성자가 내린 결론 #
실험을 설계할 때 작성자는 문제가 요즘 AI에게 너무 쉬울까 봐 걱정했다고 합니다. 결과는 그렇지 않았습니다. YES와 YES_AFTER_DELAY 사이의 모호함처럼 벤치마크 자체에 다듬을 부분은 분명히 있습니다. 그래도 판단이 눈에 띄는 HTTP 신호 하나로 끝나지 않는 순간부터는 가장 강한 모델도 실수를 했습니다.
실제 시스템에서 재시도 판단은 생각보다 단순하지 않습니다. AI가 까다로운 상황을 따져 보는 데 도움은 되지만, 결국 중요한 건 전체 맥락이고 모델의 답을 그대로 믿는 건 위험할 수 있다는 게 작성자의 결론입니다.
벤치마크는 Kaggle에서 직접 확인할 수 있습니다: To Retry or Not to Retry? Benchmark
작성자는 Kaggle을 이번 챌린지에서 처음 써 봤는데, 생각보다 설정이 훨씬 간단해서 UI만으로 작은 실험용 벤치마크를 만들 수 있었다고 합니다. 전통적인 ML 대회 말고도 둘러볼 게 많아 앞으로 더 써 볼 생각이라고 덧붙였습니다.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.