AI가 짠 코드, 진짜 병목은 검증이다
코딩 에이전트가 5분 만에 만든 비밀번호 재설정 기능에 버그가 있었다. 생성이 싸지면서 검증이 개발의 새로운 병목이 됐다는 실험 기록.


The Verification Bottleneck in AI-Generated Software
AI can generate code faster than ever. That doesn't mean we're shipping correct software...
개요 #
코딩 에이전트에게 비밀번호 재설정 기능을 맡겼더니 5분 만에 라우트, 토큰 처리, 이메일 연동, UI까지 전부 나왔다. 문제는 재설정 링크가 한 번 쓰고 나서도 계속 먹혔다는 점이다. 새 비밀번호를 설정한 뒤 같은 링크를 다시 열어도 그대로 동작했다.
Ken W Alger는 이 경험을 출발점 삼아 글을 썼다. 요구사항 문서에 "재설정 링크는 일회용"이라는 문장은 없었다. 굳이 적을 필요가 없다고 여겨지는 조건이었기 때문이다. 그리고 사람이 손으로 클릭해 보는 경로에서는 전부 멀쩡하게 동작했다. 코드 리뷰라면 잡았을지도 모르지만, 데모로는 절대 못 잡는다.
그가 짚는 건 이 틈이다. 코드를 만드는 속도가 빨라진 만큼, 그 코드가 맞는지 확인하는 비용이 상대적으로 커졌다는 것.
비싼 쪽이 바뀌었다 #
기존 개발의 제약은 명확했다. 사람이 직접 코드를 써야 했다. 요구사항을 이해하고, 구현을 설계하고, 코드를 쓰고, 돌려 보고, 안 되면 디버깅하고, 될 때까지 반복한다.
에이전트는 이 루프의 앞부분을 크게 줄였다. 문제는 에이전트가 내놓은 결과물을 꼼꼼히 읽는 시간보다 에이전트가 만드는 시간이 더 짧다는 것이다. 오랫동안 코드를 쓰는 게 비싸고 확인하는 게 상대적으로 쌌는데, 그 관계가 뒤집혔다.
Alger는 숫자로 정리한다. 에이전트가 5분 만에 기능을 구현했지만 그게 맞는지 판단하는 데 수동 테스트와 코드 리뷰로 45분이 더 든다면, 5분짜리 개발 프로세스가 생긴 게 아니다. 구현 단계만 아주 빠른 50분짜리 프로세스가 생긴 것이다.
게다가 검증 쪽은 예전보다 어렵다. 내가 쓰지 않은 코드를 감사해야 하니까.
살아남는 건 명세다 #
글의 핵심 주장은 테스트 얘기를 넘어선다. 에이전트가 컴포넌트를 싸게 다시 쓸 수 있다면, 특정 구현에 대한 애착이 줄어든다. 구현은 소모품이 된다. 6개월 뒤에 라우트가 바뀌고, 프레임워크가 바뀌고, DOM이 바뀌고, 내부 구조가 바뀐다.
바뀌지 않는 건 사용자 요구사항이다.
비밀번호를 재설정한 사용자는 새 비밀번호로 인증할 수 있어야 하고, 기존 비밀번호로는 더 이상 인증할 수 없어야 하며, 재설정 링크를 재사용할 수 없어야 한다.
코드 생성이 싼 시대에 유지할 가치가 있는 건 구현이 아니라 명세라는 얘기다. 그렇다면 명세는 이미 만들어진 것을 설명하는 문서가 아니라, 그 자체로 하나의 산출물로서 먼저 쓰여야 한다.
구현이 아니라 행동에서 시작한다 #
Alger는 작은 웹 애플리케이션과 Claude Code, testRigor로 이걸 실험했다.
애플리케이션은 일부러 평범하게 잡았다. 인증, 사용자 계정, 로그인 동작. 업무용 애플리케이션이면 어디에나 있는 기능이다. 에이전트가 보기 좋은 결과물을 만들 수 있느냐는 관심사가 아니었다. 기대 동작을 먼저 정의하고, 에이전트가 구현하게 하고, 독립적인 E2E 검증으로 실제 성공 여부를 판정할 수 있느냐가 질문이었다.
비밀번호 재설정만 봐도 라우트, 폼 처리, 토큰 생성, 검증, 비밀번호 해싱, DB 갱신, 세션 동작, 에러 처리, UI 변경이 얽힌다. 에이전트는 이걸 전부 빠르게 만들어 낸다.
그런데 사용자는 그중 무엇에도 관심이 없다. 재설정을 요청할 수 있는지, 메일을 받는지, 새 비밀번호를 설정할 수 있는지, 그걸로 로그인되는지, 기존 비밀번호와 사용한 링크가 막히는지만 중요하다.
이건 전부 관찰 가능한 결과다. 그래서 우리가 에이전트에게 시킨 것과 에이전트가 실제로 만든 것 사이의 경계선으로 쓸 만하다.
 Photo by Lucian Pirvu on Pexels
실행 가능한 명세 #
testRigor가 흥미로웠던 지점이 여기다. 이 도구는 셀렉터와 자동화 코드 대신 영어에 가까운 행동 지시문으로 테스트를 표현한다. 사용자가 무엇을 하고 무엇을 보게 되는지를 서술하는 방식이다.
AI 개발과 결합하면 이 행동 테스트가 실행 가능한 명세 역할을 한다. "비밀번호 재설정 기능 추가해줘"라고 시키는 대신 행동 계약을 준다. 재설정 링크를 메일로 보내야 한다. 링크를 열면 폼이 나와야 한다. 새 비밀번호로 로그인돼야 한다. 링크는 두 번째에는 동작하지 않아야 한다.
이렇게 하면 책임이 둘로 갈라진다. 코딩 에이전트는 행동을 어떻게 구현할지 알아내는 쪽을 맡고, 행동 테스트는 그 행동이 존재하는지 판정하는 쪽을 맡는다. 분리 자체가 요점이다.
학생에게 채점을 맡기지 말 것 #
요즘 AI 코딩 도구는 테스트도 알아서 만든다. Alger도 쓴다고 밝힌다. 다만 같은 시스템이 요구사항을 해석하고, 구현하고, 그 구현에 맞는 테스트를 만들고, 전부 통과했다고 선언하는 구조에는 문제가 있다.
같은 착각이 여러 군데에 그대로 복제되기 때문이다. 에이전트가 요구사항을 잘못 이해하면 그 오해에 맞는 코드를 만들고, 같은 오해를 검증하는 테스트를 만든다. 전부 초록불인데 전부 틀린 상태가 된다.
재설정 링크가 정확히 그랬다. 자기가 방금 만든 기능의 테스트를 직접 쓴 에이전트라면 해피 패스만 테스트했을 것이다. 자기가 이해한 요구사항이 거기까지니까. 그리고 통과했을 것이다.
일회용 여부를 확인하는 검사가 존재한 이유는 딱 하나다. 코드보다 먼저 쓰인 명세가 요구사항 문서에 없던 질문을 던졌기 때문이다. 테스트가 영어로 쓰여서가 아니라, 구현이 아니라 요구사항을 생각하던 사람이 썼기 때문에 나온 검사다.
독립적인 행동 검증은 질문 자체가 다르다.
어떻게 구현했든, 이 소프트웨어가 우리가 명세한 동작을 실제로 보이는가?
사용자가 궁금해하는 질문에 훨씬 가깝다.
루프를 닫는다 #
Alger가 가장 흥미롭게 본 건 테스트 도구가 아니라 피드백 루프다.
E2E 테스트가 결정론적인 통과/실패를 내놓는 순간, 그 결과는 코딩 에이전트의 입력이 된다. 에이전트가 기능을 구현하고, 행동 테스트가 돌고, 실패하면 실패 내용이 에이전트로 돌아간다. 에이전트가 구현을 살펴보고 다시 고치면 검증이 또 돈다.
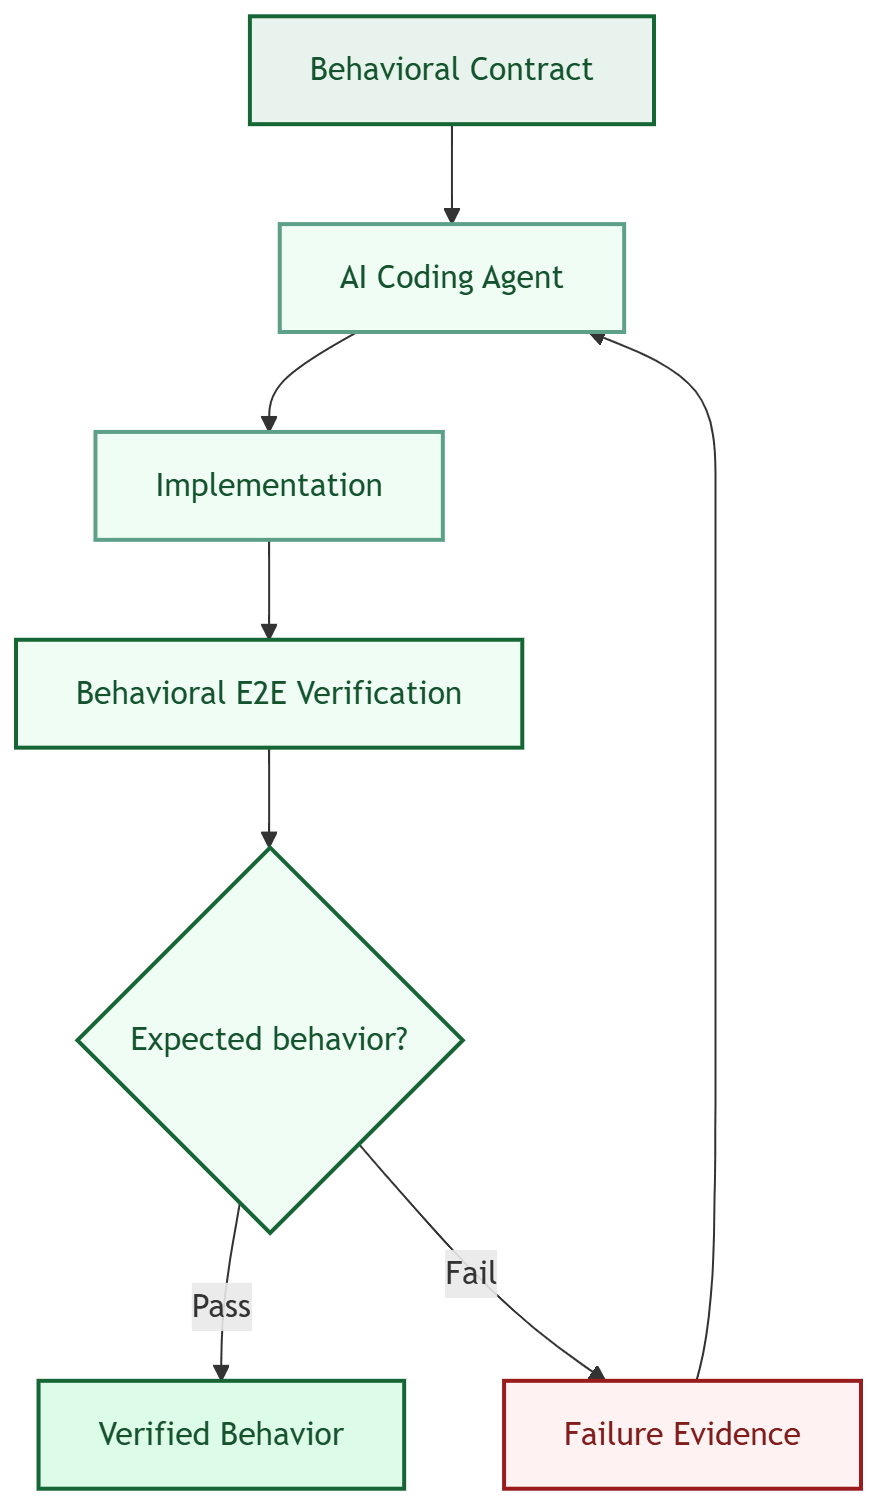
실험에서는 이 사이클이 세 번 돌았다. 기능이 아직 없는 기준선에서 빨간불, 생성 이후 재사용된 링크 때문에 또 빨간불, 실패 텍스트를 컨텍스트로 에이전트에게 돌려주고 나서 초록불. 전체 20분 남짓이었고 대부분은 지켜보지 않은 채로 돌아갔다.
실패 텍스트의 역할이 예상보다 컸다. 스택 트레이스가 아니라, 일어나지 않은 동작 한 단계를 평문으로 적은 문장이었다. 사람도 읽고 에이전트도 읽는다. 중간에서 번역해 주는 사람 없이 루프가 닫힌 이유가 그거다.
에이전트가 받은 건 "다시 해봐"보다 훨씬 쓸모 있다. 특정 기대 동작이 관찰되지 않았다는 증거다.
YouTube 영상 보기 → — Spec-First Verification for AI-Generated Code
제안과 판정은 다른 일이다 #
Alger는 이 실험이 AI 시스템 설계에 대한 생각을 굳혔다고 말한다. 확률적 시스템은 무언가를 제안하는 데 아주 강하다. 구현을 만들고, 요구사항을 해석하고, 수정안을 제시하고, 실패 원인을 설명하고, 어떤 파일을 고쳐야 할지 짚는 일.
반면 권한을 다른 쪽에 주고 싶은 영역이 있다. 빌드가 성공했나? API가 기대한 응답을 줬나? DB가 기대한 상태인가? 사용자가 명세된 워크플로를 끝까지 수행할 수 있나? 테스트가 통과했나? 전부 결정론적으로 답할 수 있는 질문이다.
AI는 제안하고, 결정론적 시스템이 검증한다.
물론 실수가 사라지지는 않는다. 잘못 쓴 테스트는 엉뚱한 걸 검증한다. 명세가 부실하면 중요한 동작이 빈다. 테스트 환경이 운영과 다를 수도 있다. 검증 자체에도 엔지니어링이 필요하다. 다만 생성과 검증을 분리하면, 모델이 자신 있어 한다는 사실을 구현이 맞다는 증거로 취급하는 일은 그만둘 수 있다.
자연어 테스트도 공부가 필요하다 #
영어에 가까운 테스트 시스템을 써 보고 얻은 또 다른 교훈은, 평문이라고 배울 게 없는 건 아니라는 점이다.
도구에는 여전히 고유한 의미 체계가 있다. 요소를 어떻게 식별하는지, 지시문을 어떻게 해석하는지, 상태를 어떻게 관리하는지, 인증은 어떻게 처리하는지, 애플리케이션이 예상과 다르게 굴 때 어떻게 반응하는지 알아야 한다. Alger도 당연해 보이는 지시문이 원하는 대로 동작하기 전에 testRigor의 어휘를 몇 번 익혀야 했다고 적는다. 그의 명세는 재설정 성공 후 로그인 폼으로 이동한다고 가정했는데 실제로는 아니었다. 애플리케이션 버그가 아니라 명세의 빈틈이었고, 이걸 찾는 데 계획에 없던 실행이 한 번 더 들었다.
testRigor만의 문제는 아니다. 추상화는 복잡도를 없애지 않고 옮긴다. SQL이 데이터베이스 이해의 필요를 없애지 않았고, 고수준 언어가 소프트웨어 이해의 필요를 없애지 않았다. 자연어 테스트도 테스트 이해의 필요를 없애지 않는다. 바뀌는 건 누가 행동을 표현할 수 있느냐, 그리고 그 행동이 구현 세부에 얼마나 묶여 있느냐다.
무엇을 최적화할 것인가 #
AI 개발 논의는 대부분 생산성에 쏠려 있다. 개발자가 얼마나 빨리 코드를 쓰는가, 에이전트가 작업을 몇 개나 끝내는가, 토큰을 얼마나 썼는가.
쓸모없는 지표는 아니지만 결과는 아니다. 소프트웨어는 문제를 풀 만큼 정확하게 동작하려고 존재한다. 에이전트가 10분에 1만 줄을 뽑아냈는데 그게 돌아가는지 확인하느라 하루를 쓴다면, 그 1만 줄은 생산성의 증거가 아니다. 검수를 기다리는 재고다.
추적할 가치가 있는 지표는 단위 시간당 전달된 정상 동작이다. 생성도 포함되지만 검증도 포함된다. 생성의 한계 비용이 0에 가까워질수록 남는 비용은 후반부에 몰린다.
코딩 에이전트는 앞으로 더 좋아진다. 더 큰 변경을 만들고, 감독 없이 더 오래 돌고, 더 복잡한 저장소를 이해하고, 구현 과정을 더 많이 자율적으로 처리할 것이다. 그래서 검증은 덜 중요해지는 게 아니라 더 중요해진다. 독립적인 평가 없는 자율성 확대는 더 나은 개발 시스템이 아니라, 검증되지 않은 산출물을 더 빨리 뽑는 공급원을 만든다.
Alger의 결론은 검증을 나중에 덧붙이지 말고 아키텍처에 넣으라는 것이다. 명세가 목적지를 정하고, 코딩 에이전트가 경로를 제안하고, 검증이 실제로 도착했는지 알려준다. 코드를 더 빨리 만드는 게 아니라, 동작하는 소프트웨어를 더 빨리 내보내는 쪽으로.
이 글은 위 출처를 바탕으로 한국 독자를 위해 재작성한 기사입니다. 원문의 사실과 수치에 근거하며, 별도의 견해를 포함하지 않습니다.